XFA(XML 表单架构)已被弃用。ISO 32000-1 第 12.7 节包含它,但附带说明它已从 PDF 2.0 中删除,现代阅读器也接连放弃了它们的 XFA 引擎。但这都没能清空档案。在将近二十年的时间里,政府接收表单、保险申请和银行对账单都是用 XFA 编写的,今天这些文件仍陆续进入收件箱和文档处理管线。过去用来渲染它们的阅读器一旦停止支持,表单就会变成只剩“请在其他阅读器中打开”占位符的空白页。长久之计是将 XFA 展平(flatten),也就是把它们转换为任何阅读器都能绘制的静态 PDF 内容
展平过程中最困难的部分不是表单字段。文本框和复选框映射为 AcroForm 控件相对直截了当。真正的难点是 XFA 存储在 draw 元素中、包含在 <exData contentType="text/html"> 块里的富文本。这个块是带有内联样式的 HTML 子集,并且通常还包含锚点(anchors)。将其放置到页面上意味着必须同时重现样式化的文本和有效的超链接,而大多数实现在处理超链接这一步时通常会悄悄放弃
XFA 富文本的真实面貌
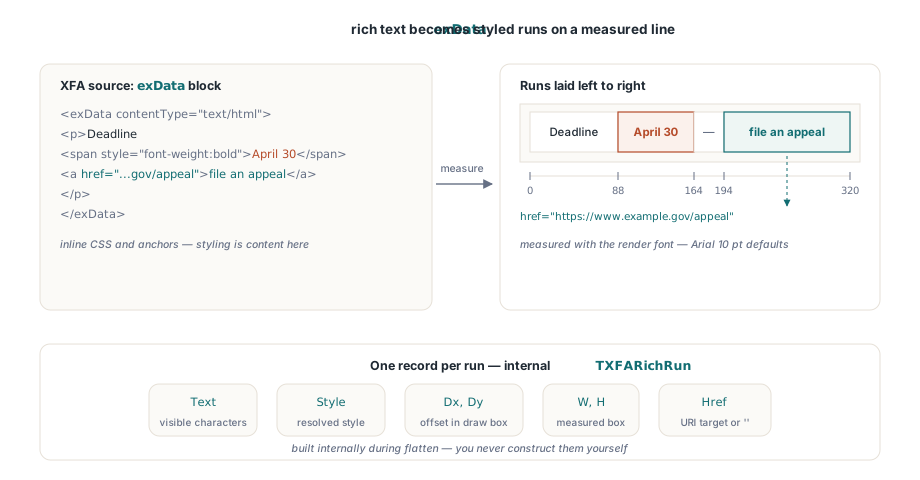
exData 主体是 XHTML 的一小片断。一个段落是一个 <p>;一串带样式的字符是一个带有其自身内联 CSS(用于控制字重、字形姿态、颜色和大小)的 <span>;而一个超链接则是一个包裹了其可见文本的 <a href="...">。单行文本可能连续包含好几个 span,每一个都带有不同的样式,并且其中一个可能是锚点。这些样式不是可以随意丢弃的装饰。作为法律警告、以红色加粗字体呈现的条款,在展平后必须保持红色加粗,否则展平后的文档会曲解原文
因此,展平引擎不能把这个块当作一个字符串来处理。它必须遍历内联结构,通过将 span 的内联 CSS 叠加在 draw 元素的基础字体之上,来解析每个序列的有效样式,然后把各个文本序列接连排列在一行中。HotPDF 将每个这样排布好的片段都构建为一个内部的 TXFARichRun 记录(record)进行管理。该记录携带该序列的文本、其解析出的样式、测量出的方框,以及,如果是锚点,其指向的 Href
将文本序列从左到右排版
定位是富文本从解析问题演变成排版问题的环节。这些序列(runs)共用一行,因此每个序列都在前一个序列结束的地方开始。没有任何标记记录这些位置;它们必须通过测量获得。引擎的内部 LayoutRichText 过程使用它随后用来进行绘制时的字体度量信息来测量每个序列,然后将该序列的水平偏移量设置为之前所有序列宽度的累计和。第一个序列从 draw 元素的起点开始,第二个序列起始于第一个序列末端的宽度处,第三个起始于前两个结合处的总宽度,以此类推穿越这一整行
这就是为什么测量字体的对齐方式如此重要。布局阶段(layout pass)测量的是字形的跨距(advances);独立的渲染阶段绘制字形。如果这两个阶段在字体上存在分歧,布局计算出的方框就不会刚好落在渲染器绘制出来的字形下方。为了保持一致,HotPDF 通过内部协助函数 RunStyleToFontSpec,将每个序列解析出来的样式映射到一个同渲染引擎自身的默认设置(Arial 10 pt)相匹配的字体定义上。这样测量出的宽度与实际绘制的内容就能对齐,并且序列算出的方框就能真切地涵盖读者看到的所有字符
// 每个已排版序列(run)的概念外形。引擎内部会构建一个由这些记录组成的数组;
// 你不必自己构造它们,但这些字段说明了链接的热区(hit box)如何由测量出的
// 几何信息——而非文本本身——推导而来。
type
  TRichRunInfo = record
    Dx, Dy : Double;       // 左上角,相对于 draw-box 原点
    W, H   : Double;       // 测量出的序列方框(宽度由布局阶段得出)
    Text   : AnsiString;   // 该序列的可见字符
    Href   : AnsiString;   // <a> 序列的 URI 目标,否则为 ''
  end;
从锚点序列到 PDF Link 注释
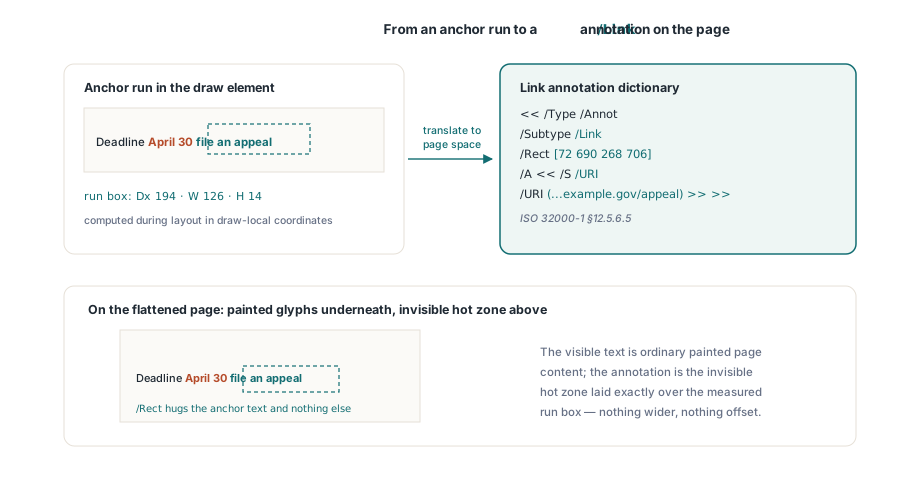
在一个完成生成的 PDF 文件里,超链接并非页面内容的一部分。它是一个独立的对象:根据 ISO 32000-1 的 §12.5.6.5 小节所描述的 Link 注释。该注释有一个定义了页面上可点击矩形区域的 /Rect 参数,以及当该区域被点击时触发的动作(action)。对于外部链接,该动作是 URI action:即包含作为目标网址的 /URI 字符串的 /S /URI。底部的可见文字仅是普通的页面内容;该注释则是叠加在它之上的那个不可见的触发热区(hot zone)
展平路径正是按照这个模型工作的。当一个序列带有 Href 时,HotPDF 先绘制带样式的文本,然后在该序列的方框上构建一个 Link 注释。构建这个注释的公开入口是页面方法 AddURILink,它创建带 /URI 动作的 /Type /Annot /Subtype /Link 对象并返回注释字典。它的矩形就是该序列的测量方框,从 draw 元素的局部坐标换算为页面坐标。这样得到的链接精确落在锚点文本上,且只落在锚点文本上
// 展平路径为每个锚点序列所用的同一个公共 API。它会产生一个
// ISO 32000-1 12.5.6.5 定义的 Link 注释:带有 /URI 动作的 /Subtype /Link,
// 作用于给定的矩形之上。可选的描述文本会填入 /Contents,以便
// 屏幕阅读器能够播报目标地址。
var
  LinkRect: TRect;
  Annot: THPDFDictionaryObject;
begin
  LinkRect := Rect(72, 690, 268, 706);  // 该序列在页面空间中的热区
  Annot := Pdf.CurrentPage.AddURILink(LinkRect,
    'https://www.example.gov/appeal', 'File an appeal online');
end;
为什么热区必须来自测量得到的宽度
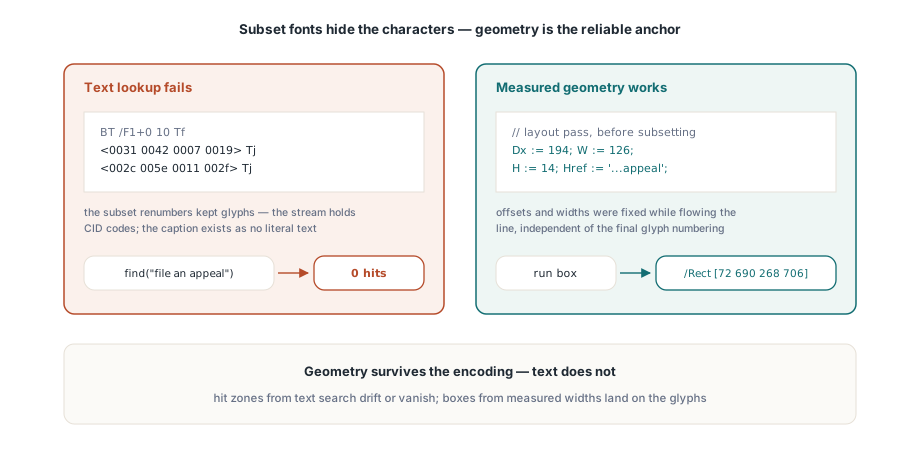
有人可能会想:在页面中搜索链接的可见文本,然后在找到的内容周围画一个矩形,不就能定位链接了吗。这行不通,原因要归结到展平文本存储方式的根本之处。带样式的序列是用内嵌的子集字体(subset font)绘制的。子集字体会对它保留的字形重新编号,因此页面内容流里保存的是十六进制的 CID 码,而不是原始的字符编码。页面上的字节既不是人类读到的字母,也无法作为文本被搜索。搜索锚点的标题会一无所获,因为那段标题根本不以字面文本的形式存在于内容流中的任何地方
矩形唯一可靠的定位依据是布局阶段已经产出的几何信息。每个序列的偏移量和测量宽度是在折行排布时计算的,那时还没有任何字形被重新编号,它们描述的正是文本实际出现的位置。因此 HotPDF 直接从序列排定后的方框取得链接矩形,而不是去查找文本。由于测量用的就是渲染字体,无论子集化如何处理,方框都是正确的。几何信息能在编码后幸存,文本则不能。这就是基于测量宽度定位的全部理由,也是为什么试图靠文本搜索来补挂链接的展平器,做出来的热区不是漂移就是消失
用你的代码驱动展平
对于一个已包含 XFA 数据包的 PDF,入口是 FlattenLoadedXFA。加载文档、调用该方法、保存结果即可。Editable 参数决定表单字段的去向:传 True 将它们保留为可填写的 AcroForm 控件,传 False 则把每个控件标记为只读,让输出成为一份冻结的记录。无论哪种方式,带样式序列和链接注释的富文本 draw 块都会被生成。函数返回它发出的控件数量
var
  Pdf: THotPDF;
  Emitted, i: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('xfa_appeal_form.pdf');
    // True 使字段保持可填写;False 则将其冻结为只读。
    Emitted := Pdf.FlattenLoadedXFA(True);

    // 引擎无法映射的任何内容都会被报告,而不是抛出异常。
    for i := 0 to Pdf.XFAFlattenWarnings.Count - 1 do
      Writeln('XFA warning: ', Pdf.XFAFlattenWarnings[i]);

    Pdf.SaveLoadedDocument('appeal_form_flat.pdf');
    Writeln('Widgets emitted: ', Emitted);
  finally
    Pdf.Free;
  end;
end;
调用之后务必读取 XFAFlattenWarnings。该列表在每次展平开始时清空,并为引擎拒绝渲染的每一个元素累积一行:不支持的字段类型、无法解码的 draw 图像、没有任何可用 span 的 exData 块。这些都不会抛出异常,因此空的警告列表就是一切都被成功映射的证据,而非空的列表会确切告诉你要检查哪些原始文件。当你手里的是 XDP 字节形式的原始 XFA 而不是已加载的 PDF 时,姊妹方法 ApplyXFAAsAcroForm 直接接收这些字节,并共享同一条代码路径和同样的警告行为。配套的 AddXFAPacket 方法则反其道而行,把 XFA 数据包嵌入你正在构建的文档
在阅读器中确认结果
用 Acrobat 或任何现代阅读器打开展平后的文件,检查两件事。第一,富文本在渲染后样式完好:该粗体的是粗体,该带颜色的带着颜色,各个 span 在行内顺序正确,既不重叠也不越出方框。第二,超链接是活的。把鼠标悬停在锚点上,状态栏应显示目标地址;点击它,URI 动作应能将其打开。用阅读器的注释检查器确认每一个都是真正的 /Link 注释,其 /Rect 紧贴锚点文本,下方的内容如今是纯粹的绘制字形而不是由表单渲染的 XFA。样式化静态文本加上落在正确矩形上的真实 Link 注释,这一组合正是让展平后的文档能够摆脱对 XFA 引擎的依赖、长久存活的原因
至于字段本身的展平——即环绕这些富文本的文本框、复选框和选择列表——在我们把 XFA 表单展平为 AcroForm 控件的分步指南中有专门讲解。若想了解如何手工构建和放置 Link 注释(而不只是展平路径自动生成的那些),请参阅在 HotPDF 中处理 PDF 注释。两者都建立在随 Delphi 和 C++Builder 版 HotPDF Delphi Component 一起发布的同一套注释与表单模型之上