PDF 没有内嵌字体时,HotPDF 组件用 HPDFMapBaseFontToSystem 选定的一款已安装 Windows 字体来渲染那段文字:它解码 /BaseFont 名称,剥掉样式部分,尝试多种拼写直到 GDI 确认字族已安装,用度量兼容字体测量缺失的标准 14 字体宽度,并在绘制前把单字节代码转成 Unicode。每一步的存在,都是因为想当然的做法在真实文件上会翻车。RenderLoadedPageToBitmap 页面渲染器处理内嵌字体游刃有余;本文讲的是那些压根不在文件里的字体
为什么 GDI 会对未内嵌字体无声地画出另一种字型?
GDI 从不报告字体缺失:递给 CreateFontIndirect 一个它不认识的字面名,它会悄悄挑个替身,常常是一个没有粗体字重的另一种衬线。把 PDF 名称几乎原样传过去,TimesNewRoman,Bold、TimesNewRomanPS-BoldMT 和 SegoeUI-Semibold 全都匹配不到任何东西,最后落进 GDI 随手挑的那个字体。名称还能更糟。ISO 32000-1 §7.3.5 允许名称里以 #xx 写任意字节,CJK 生成器习惯把字体名拼成转义的 UTF-8 或遗留代码页字节;跳过解码步骤的映射器,会拿转义序列本身当字面名去问 GDI 要。HPDFMapBaseFontToSystem 先解码转义,把合法 UTF-8 字节序列还原为字符,其余高位字节按系统代码页读出
剥样式这步是启发式规则咬人的地方。逗号总是终结字族(Arial,Bold 得到 Arial),连字符只有当它后面的词是样式词时才终结:Bold、Italic、Oblique、Regular、Roman、Medium、Light、Black、Heavy、Semi、Demi、Thin、Extra、Ultra 或 Condensed。这条规则保住完整的 MS-Mincho,同时把 Calibri-Light 变成 Calibri。HotPDF 随后尝试字族的几种拼写,再尝试去掉 PSMT、MT 或 PS 后缀后的拼写。这些拼写穷举了单词可能起首之处空格的有无:小写字母后的大写之前(MyriadPro 变 Myriad Pro)、小写字母跟在一串大写之后的最后一个大写处(UIGothic),以及开头 MS 之后(MSPGothic),从全加空格的形式一直到名字原样;超过四个这样的位置,就只试全空格与连写两种。空格不能瞎加,因为 Windows 保留了一些连写:SimSun 安装时就叫这个名,而 MicrosoftYaHei、MicrosoftJhengHei 和 MSPGothic 属于 Microsoft YaHei、Microsoft JhengHei 和 MS PGothic。在每个内部大写前都加空格的映射器,会把 MicrosoftYaHei 当成 Microsoft Ya Hei 去查,永远查不到。一个候选算已安装的判定是:CreateFontIndirect 之后 GetTextFace 返回请求的名字,或者所选字体的 name 表把它列为任意语言的 family、full 或 typographic family 名;结果按名字缓存,所以带大量未安装字体的文档不会每一页都对每个名字去折腾一遍 Windows
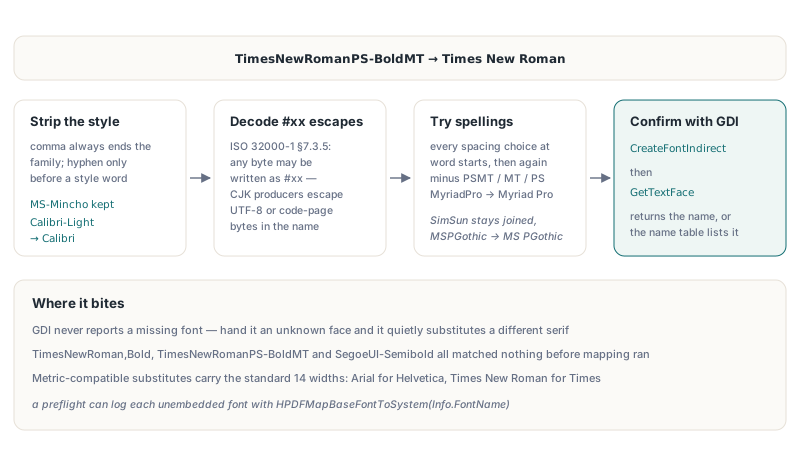
映射函数在 HPDFRenderFontMetrics 单元里是公开的,所以预检报告可以展示每个未内嵌字体将以哪个已安装字族渲染,用的字体枚举 THotPDF 对已加载文档早就暴露了:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
没有 /Widths 的标准 14 字体怎么量宽度?
缺失的宽度由 HotPDF 在已安装字体上按同样的度量测出,因为 ISO 32000-1 §9.6.2.2 允许标准 14 字体省略 /Widths,而库不带 AFM 表。Arial 带着 Helvetica 的度量,Times New Roman 带着 Times,Courier New 带着 Courier,所以 HPDFMeasureBaseFontWidths 以 lfHeight = -1000 创建对应字体并调 GetCharWidth32W;在这个高度上结果恰好就是 PDF 宽度使用的 1/1000 em 单位。渲染器先经 /Encoding、/BaseEncoding 与 /Differences 把每个代码转成 Unicode,默认 StandardEncoding。SVG 导出与文本提取还共踩一个坑:标准 Type 1 字体即使完全没写 /Encoding,也隐含 StandardEncoding;不实现它的解码器手里没有任何编码信息,测出的每个宽度都派不上用场。HotPDF 补上这个隐含的 StandardEncoding 并把它标记为预定义编码;若改走 CMap 名称路径,每个代码都会解成 0,宽度随之全部落空
粗体、斜体与从 1 起数的字体描述符标志位
字体描述符的 /Flags 条目从 1 而不是 0 开始数位,所以按 ISO 32000-1 Table 123,ForceBold 是第 19 位($40000),Italic 是第 7 位($40)。差一错误很好犯:从零数起,$20000 看着像 ForceBold,其实是第 18 位 SmallCap,拿它做字重测试会把每个 small-caps 字体渲染成粗体。这个陷阱还藏得深,因为 /FontDescriptor 几乎总是间接引用:只读直接对象的代码根本走不到标志位分支,同样的失明也会无视 /Widths 12 0 R,用回退步进排版文本。解析间接引用与把位常量钉死在 Table 123 上,这两件事要一起做:
const
  // ISO 32000-1 Table 123 从 1 起数位
  FD_ITALIC     = $00040;  // 位 7
  FD_SMALLCAP   = $20000;  // 位 18,不是字重
  FD_FORCEBOLD  = $40000;  // 位 19

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;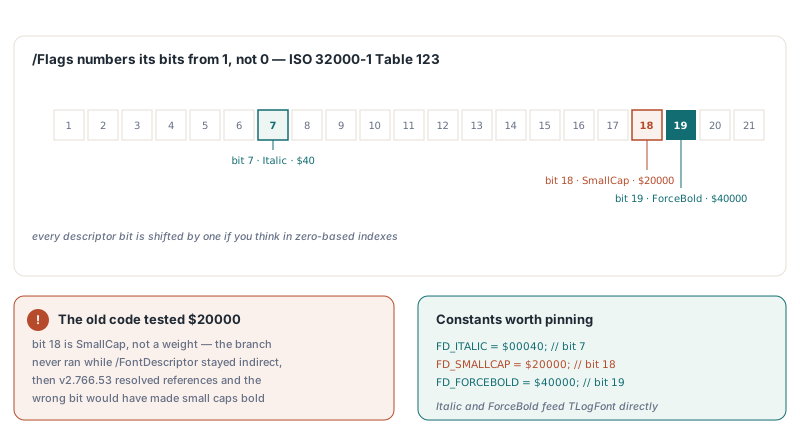
带 UCS2 CMap 的 CJK 字体为什么量错宽度?
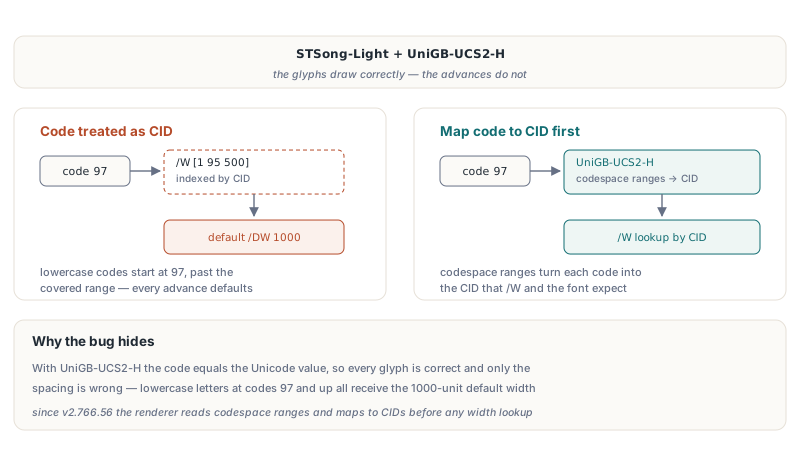
带预定义 UCS2 CMap 的 CJK 文本,在渲染器把代码当 CID 用时会画出正确的字形、错误的间距,因为 /W 以 CID 索引,不以字符代码索引。用 STSong-Light 配 UniGB-UCS2-H 时,代码恰好等于 Unicode 值,GDI 画出的字符是对的,错误藏在步进里:小写字母以 97 以上的代码到来,落不进 [1 95 500] 这样的 /W 条目,全部拿到 /DW 默认宽度 1000。HotPDF 渲染器经 CMap codespace 区间(ISO 32000-1 §9.7.6.2)读代码,先映射成 CID 再查宽度。它基于内置 UCS2 与 UTF16 表以及内嵌 CMap 流工作;对 GBK-EUC-H 这类映射做恒等近似,只是看起来像支持、产出却是错的,所以刻意不用
中文 Windows 上带变音符号的字符为什么变成问号?
单字节代码绝不能送到 ANSI(“A” )系列 GDI 函数,因为 GetGlyphOutlineA 和 GetGlyphIndicesA 按系统代码页解释字节,而 TextOutA 用的是所选字体的字符集。在中文系统上,Arial 的字节 $A9(Windows-1252 里的版权符号)会成为 GBK 的首字节,渲染成“?”,任何调 A 系列函数的轮廓路径都会一头撞上。HotPDF 用 GetTextCharset 向已实例化的字体询问字符集,经 TranslateCharsetInfo 换成代码页,把字节送进 MultiByteToWideChar 再调 W 系列函数;symbol 字体改用 U+F000 加代码。与 Windows-1252 不一致的编码——/Differences、StandardEncoding、MacRomanEncoding——在任何系统字体见到它们之前就先映射成 Unicode
用系统字体绘制能走多远?
系统字体渲染天然是近似,本地化的 Windows 又添一层变数:GetTextFace 按系统语言报告字族名,只比名字的话,中文 Windows 上的 Microsoft YaHei、日文 Windows 上的 Yu Mincho 都会被判成未安装。这就是为什么以另一个名字回来的字体还要到该字体的 name 表里查证。度量兼容只覆盖 Helvetica、Times、Courier 三族;Symbol 映到 Symbol,ZapfDingbats 映到 Wingdings,那是权宜之计而非匹配。上面的 preflight 走的是每页的 /Resources 字典,只在 form XObject 内部引用的字体需要单独跑一趟。仍有画不出来的代码时,绘制时的未解析字形跟踪会报告它,比眯着眼看缩略图可靠得多
长治久安的答案在生成侧。HotPDF 自己写文件时默认 FontEmbedding 为 True,就算代码用 Helvetica 调 SetFont 也换成一个内嵌的 Arial,内嵌文本走内嵌字体字形渲染器,不经过上面任何猜测。对来路文件的一个便宜护栏:渲染前发现映射出的字族不在屏幕字体清单里就告警:
// VCL:Screen.Fonts 列出已安装字族名(Forms 单元)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;
完整组件(含页面渲染、文本提取和写出侧的字体子集化)见 HotPDF Delphi PDF component 产品页