一份从本地磁盘秒开的 PDF,同样的字节改由应答 Range 请求的 HTTP 服务器提供时,可能要花好几秒才显示第一页——哪怕文件只有几 MB、链路也快。带宽不是问题,请求数才是,而解药是把几百次细碎分散的读取变成几十个缓存区块,然后只在访问模式保持顺序时才向前预读
为什么同一份 PDF 在本地秒开,在网络上却慢如蜗牛?
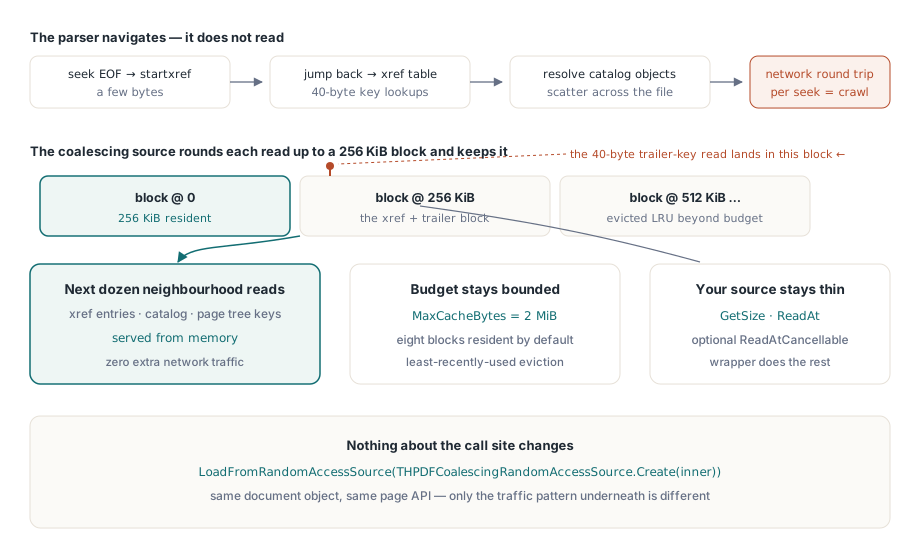
PDF 解析器不是从头到尾读一个文件,而是导航一个文件。ISO 32000-1 §7.5 的结构把入口放在末尾:解析器先 seek 到最后 1 KB 找 startxref,跳回交叉引用表,解析 trailer 字典,顺着引用找到 Catalog,再到页面树根,再到某个页面节点,再到该页的资源字典。每一跳都从不同的偏移读几十字节,增量更新的文件还要经 /Prev 链把这条路线每个修订版重走一遍
在本地文件上这种模式几乎免费:操作系统早已把周围的 4 KiB 页留在文件缓存里,第二次读取只是一次内存复制。网络传输没有这种局部性,每次读取都变成一个自带延迟的请求,算术很残酷:单程 40 ms 时,300 次小读取累计十二秒的等待,而线路大部分时间闲着。少读不是选项,解析器要的字节一个都不能少。能变的是每次物理请求带回来多少
把你的传输层包进 THPDFCoalescingRandomAccessSource
HotPDF 从任何 THPDFRandomAccessSource 的子类加载文档,而 THPDFCoalescingRandomAccessSource 就坐在那个类和解析器之间。每次读取向上取整到对齐区块,区块留在内存里。BlockSize 默认 262,144 字节,MaxCacheBytes 默认 2,097,152,于是八个区块常驻,预算满时淘汰最近最少使用的那个。解析器为查一个 trailer 键做的 40 字节读取,捎回了周围 256 KiB,同一片区域的接下来十几次读取(交叉引用条目、Catalog、页面树键)全部出自内存
你自己的类保持单薄。两个方法是必需的:GetSize 和 ReadAt。你的 HTTP 客户端能中止在途请求时,重写 ReadAtCancellable;源是仍在下载的文件时,重写 IsRangeAvailable。包装器每次取数之前都问这个问题:整个块还没到位就只拿请求的那些字节重试,那些也缺就短读返回而不是阻塞
type
  // TMyHttpClient 代表你自己的 HTTP 客户端类
  THttpRangeSource = class(THPDFRandomAccessSource)
  private
    FClient: TMyHttpClient;
    FUrl: string;
    FSize: Int64;
  public
    constructor Create(const AUrl: string);
    function GetSize: Int64; override;
    function ReadAt(Offset: Int64; var Buffer; Count: Longint): Longint; override;
    function ReadAtCancellable(Offset: Int64; var Buffer; Count: Longint;
      CancellationToken: THPDFCancellationToken): Longint; override;
  end;

var
  Raw: THttpRangeSource;
  Cached: THPDFCoalescingRandomAccessSource;
  Pdf: THotPDF;
begin
  Raw := THttpRangeSource.Create('https://files.example.com/contract.pdf');
  // OwnsSource=True:包装器负责释放 Raw;256 KiB 块、8 MiB 预算
  Cached := THPDFCoalescingRandomAccessSource.Create(Raw, True, 262144, 8388608);
  Cached.MaxReadAheadBlocks := 8;   // 有效范围 1..32
  Pdf := THotPDF.Create(nil);
  try
    // 又是 OwnsSource=True:Pdf 释放 Cached,Cached 释放 Raw
    if Pdf.LoadFromRandomAccessSource(Cached, True) > 0 then
      RenderFirstPage(Pdf);   // 你自己的代码
  finally
    Pdf.Free;
  end;
end;包装器一构造出来,异步预取和自适应预读就都开着,所以示例只碰了窗口上限。构造函数提前校验参数:BlockSize 必须在 4,096 到 16,777,216 字节之间,MaxCacheBytes 至少装得下一个块,否则一个字节都还没动你就收到 ERangeError
显式包装器并非必需。把一个普通源交给 LoadFromRandomAccessSource,HotPDF 会替你包一层,用的是经 GetCacheAdmissionPolicy 和 SetCacheAdmissionPolicy 在 clkRawCompressed 层可读可改的原始缓存策略:八个条目、合计 2 MiB、每条 256 KiB。传自己的 THPDFCoalescingRandomAccessSource 则按你配置的原样使用。凡是过网络的东西,请自己构建包装器:你拿到预读旋钮和完整的统计记录,而自动路径只经 GetCacheAdmissionStatistics 报告命中、未命中、准入和淘汰计数
应该预读多远?
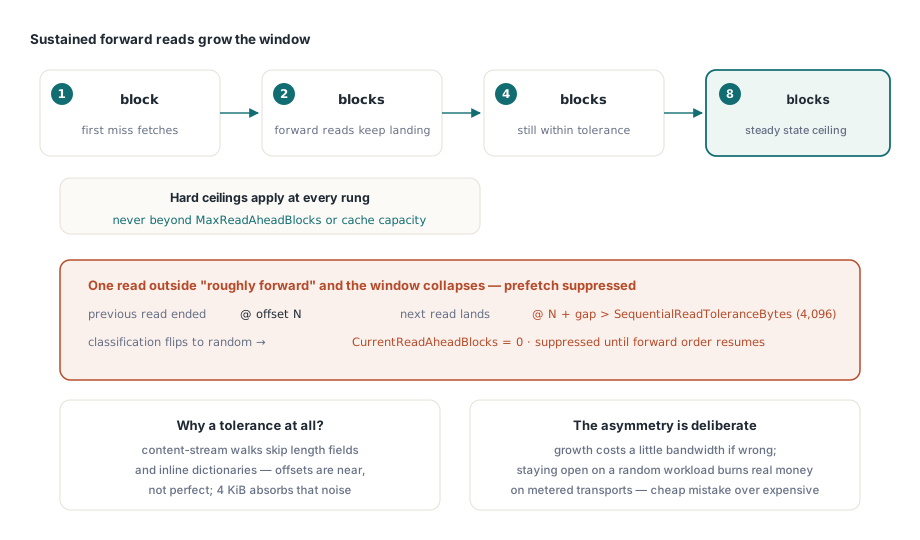
自适应预读按文档决定。设了 AdaptiveReadAheadEnabled 之后,解析器经已加载文档做出的每次读取都被归类为顺序或随机,预取窗口跟着一个分数走。连续两次向前读取把窗口开到两个块,四次开到四个,六次开到八个。窗口从不超过 MaxReadAheadBlocks,也不超过 MaxCacheBytes 装得下的块数,所以小缓存不会被自己的预取淹没
向后跳的读取,或落在上次读取结尾太远的读取,把分数压到零以下。窗口关闭,所有朝别处去的预取被取消,SuppressedPrefetchCount 上涨。再两次向前读取,窗口以单个块重新打开。这个迟滞正是要点:交叉引用追踪途中一次碰巧连续的读取,不该重启投机
SequentialReadToleranceBytes 默认 4,096,定义了什么叫"太远"。遍历内容流的解析器不会产生完全连续的偏移:这里跳过一个长度字段,那里跳过一个内联图像字典。落在上次结尾容差之内的读取仍算向前。设太低,正常的向前扫描被归类为随机,预读永远不启动;设太高,真正的随机访问看着像顺序,你取回没人读的兆字节。setter 接受从零到 BlockSize 的任何值,变更时重置分数
增长渐进、坍塌立即,这个不对称是刻意的。随机负载上的过度预取烧真实带宽,计量链路上烧真金白银;顺序负载上的预取不足只多付几个往返。AdaptiveReadAheadEnabled 保持打开。关掉之后,包装器无视模式、每次读取后固定预取一个块——解析器在交叉引用节之间跳来跳去时,这恰恰是最坏的行为
分类由加载期间 HotPDF 实际读取的流驱动。你自己的代码也经包装器取字节时——比如给文件算哈希或抽取附件——每次读取后带着偏移和长度调 ObserveReadPattern,窗口也会对这份流量做出反应。你已经知道接下来要哪些字节时,PrefetchRange 直接发起一次后台取数;IsPrefetchActive 报告它是否还在跑
缓存满了之后,把热块留住
朴素的最近最少使用淘汰有个众所周知的弱点。一次很长的向前扫描——比如穿过一张大内嵌图像——会把解析器反复回来的块全部挤出去,包括下一页还要再用的交叉引用和 Catalog 块。THPDFCoalescingRandomAccessSource 统计每个块被索取的次数,预算满时,新块只有被请求次数不低于它将替换的块才准进缓存。否则读取直接落到你的源上、只拿请求的字节,RejectionCount 和 FrequencyRejectionCount 记下这件事
这条规则默认打开(构造参数 AdaptiveAdmission)。ConfigureCacheAdmission 在活的包装器上改字节预算、单条目上限、可选的条目数限制和准入规则;它取消正在运行的预取,并当场把缓存裁到新上限
真正能中止传输的取消机制
预取跑在单个后台线程上,一旦不再值得跑完,包装器就取消它。要的字节在预取范围之外的前台读取取消它,用户要的页面绝排在投机流量后面。一次随机读取取消它。销毁包装器、调 CancelPrefetch 或 ClearCache 也取消它并等待线程退出。这几种情况都会置位预取线程传进你 ReadAtCancellable 的那个 THPDFCancellationToken
字节是否真的停下来,取决于你的重写。THPDFRandomAccessSource 默认的 ReadAtCancellable 在一次普通 ReadAt 前后各查一次令牌,这对文件共享够用,却会让一个写到一半的 256 KiB HTTP 响应跑完。按块读响应体的客户端可以在块间查令牌并中止:
function THttpRangeSource.ReadAt(Offset: Int64; var Buffer;
  Count: Longint): Longint;
begin
  Result := ReadAtCancellable(Offset, Buffer, Count, nil);
end;

function THttpRangeSource.ReadAtCancellable(Offset: Int64; var Buffer;
  Count: Longint; CancellationToken: THPDFCancellationToken): Longint;
var
  Status: Integer;
begin
  if CancellationToken <> nil then
    CancellationToken.ThrowIfCancellationRequested('http range read');
  // GetRange 和它的回调是你客户端的 API:它发送
  // "Range: bytes=Offset-(Offset+Count-1)",并在正文块之间调用回调
  Result := FClient.GetRange(FUrl, Offset, Count, Buffer, Status,
    function: Boolean
    begin
      Result := (CancellationToken <> nil) and
        CancellationToken.IsCancellationRequested;
    end);
  // 200 而不是 206 意味着服务器无视 Range、发来了整个文件
  if Status <> 206 then
    raise EStreamError.CreateFmt('Range request not honored (HTTP %d)', [Status]);
  if CancellationToken <> nil then
    CancellationToken.ThrowIfCancellationRequested('http range read');
end;
状态检查覆盖了大多数 HTTP 源最先撞上的陷阱。RFC 9110 §14 允许服务器无视 Range 头、以 200 返回完整表示,某些 CDN 和代理配置对某些文件就是这么干的。把 200 响应的前 Count 字节复制出去的源,无论请求哪个偏移,交给解析器的都是偏移零的字节。返回值同样要紧:ReadAt 报告负数或超出请求量的字节数时包装器抛 EStreamError,零则当作数据结束
你的源拿到的唯一非 nil 令牌属于预取线程。加载期间的解析器读取带着 nil 令牌到达你的 ReadAtCancellable,所以停加载本身是另一个开关:给 THotPDF.OperationCancellationToken 赋一个令牌,文档加载会在推进过程中检查它。同一套令牌模型驱动着 用请求队列做后台渲染讲的那个队列,查看器因此能从一个关闭处理器取消加载、它的渲染和它的投机网络流量
读取区间缓存统计信息
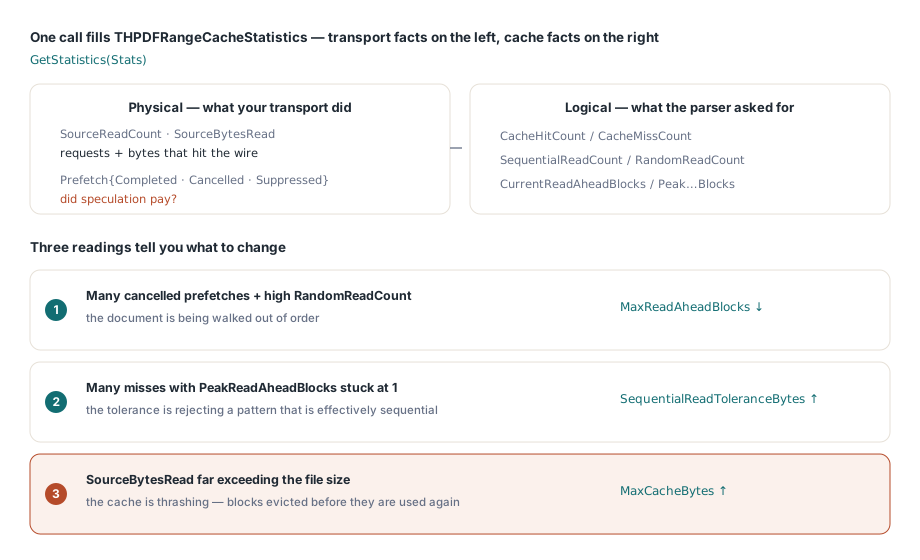
GetStatistics 填充一个 THPDFRangeCacheStatistics 记录,把你的传输干了什么和缓存干了什么分开。SourceReadCount 和 SourceBytesRead 是物理流量。CacheHitCount 和 CacheMissCount 是逻辑流量。SequentialReadCount 和 RandomReadCount 显示访问模式被如何归类,CurrentReadAheadBlocks 和 PeakReadAheadBlocks 显示窗口开了多远,四个预取计数器说明投机有没有赚。CachedRangeCount、CachedBytes、EvictionCount 和 RejectionCount 描述缓存本身
var
  S: THPDFRangeCacheStatistics;
begin
  Cached.GetStatistics(S);
  Log(Format('physical %d reads / %d bytes, hits %d, misses %d',
    [S.SourceReadCount, S.SourceBytesRead, S.CacheHitCount, S.CacheMissCount]));
  Log(Format('pattern: %d sequential, %d random, peak window %d blocks',
    [S.SequentialReadCount, S.RandomReadCount, S.PeakReadAheadBlocks]));
  Log(Format('prefetch: %d issued, %d completed, %d canceled, %d suppressed',
    [S.PrefetchRequestCount, S.PrefetchCompletedCount,
     S.PrefetchCancelledCount, S.SuppressedPrefetchCount]));
  Log(Format('cache: %d blocks / %d bytes, %d evicted, %d rejected',
    [S.CachedRangeCount, S.CachedBytes, S.EvictionCount, S.RejectionCount]));

  // 基本顺序的文档上拒绝堆积:给它更多空间
  if S.RejectionCount > S.CacheHitCount then
    Cached.ConfigureCacheAdmission(16 * 1024 * 1024, Cached.BlockSize, 0);
end;
三种读数告诉你该调什么。取消的预取很多、随机读取计数又高,说明文档正被乱序遍历——调低 MaxReadAheadBlocks,别再为要扔掉的带宽买单。未命中很多、峰值窗口停在 1,说明容差把实际顺序的模式拒之门外——调高 SequentialReadToleranceBytes。SourceBytesRead 远超文件大小,说明块在被再次使用之前就被淘汰了——先调 MaxCacheBytes,再动别的。示例里那个拒绝阈值只是我们自己的起步启发式,请对着你的流量调
线性化文件会改变整个算法
生产端归你管时,把文档线性化改变的是问题本身,而不只是调参。ISO 32000-1 附录 F 把第一页的对象和一张提示表放在文件前部,查看器凭开头那点字节就能渲染第 1 页,不用碰其余部分。HotPDF 经 GetProgressiveLinearizedLoadInfo 和 ReadProgressiveLinearizedFirstPageSection 暴露这条路径,两者都接受你为合并而包的同一个 THPDFRandomAccessSource;写入侧见 生成带提示表的线性化 PDF
两种技术可以叠加。合并让任何文档——包括你无法重新保存的第三方文件——在慢链路上变得可忍受;线性化让你自己产出的文档第一页早早到达。本地磁盘上大到内存装不下的文件是另一类问题,没有往返延迟可供摊销,直接文件 API 工作流里的映射文件与惰性流路径更适合它们
随机访问源类、合并包装器、缓存准入策略和渐进线性化加载调用都随 HotPDF 交付——一个带完整源码的原生 Delphi 和 C++Builder PDF 组件。授权与完整 API 参考在 HotPDF Delphi PDF 组件页面上