HotPDF 通过 THPDFHTMLImporter.RenderHTML5 把 HTML 转换为 PDF 页面,这是一个带版本号的分页媒体配置,具备真正的 DOM、真正的 CSS 层叠、表格、分页控制,以及可选的从 HTML 表单控件生成 AcroForm 的能力。它完全在进程内运行:没有浏览器引擎,没有 Chromium,没有外部转换器,默认情况下也完全不访问文件或网络
之所以存在一个独立的入口点,而不是直接改进 RenderHTML,原因是兼容性。旧方法多年来一直在生产环境应用中渲染发票和信函,而一个宽松的 DOM 加上完整层叠会改变那些针对旧行为调校过的文档的输出。因此旧方法保留其精确语义,一切新特性都放在 RenderHTML5 背后,其配置版本号由 HTML5ProfileVersion 报告,支持的里程碑由 HTML5ProfileMilestones 列出
HTML5 配置到底新增了什么?
实际起作用的能力有四项。一个结构化 DOM,其中 html 和 body 是容器而不是文本节点。一个具有正确优先级的 CSS 层叠。表格布局。以及显式的分页控制,这正是"分页媒体"的含义:HTML 本是为可滚动视口设计的,把它变成分页文档,就必须决定内容允许在哪里断开
容器这一点听起来像实现细节,实际上却是能不能正常工作的分界线。如果根元素被当作文本容器处理,整个 DOM 在解析时就会坍缩成一整块文本,之后所有样式表规则、分页、表格和表单子树都作用于空无一物。任何把结构化文档渲染成一整堵不加区分的文字墙的 HTML 渲染器,犯的正是这个错误
层叠顺序,逐步拆解
CSS 优先级不是单一一次排序。HotPDF 先按特异性、再按源码顺序,应用匹配规则中的普通声明,接着在其上应用内联普通声明,然后是匹配规则中的 !important 声明,最后是内联 !important。共四个阶段,顺序如上
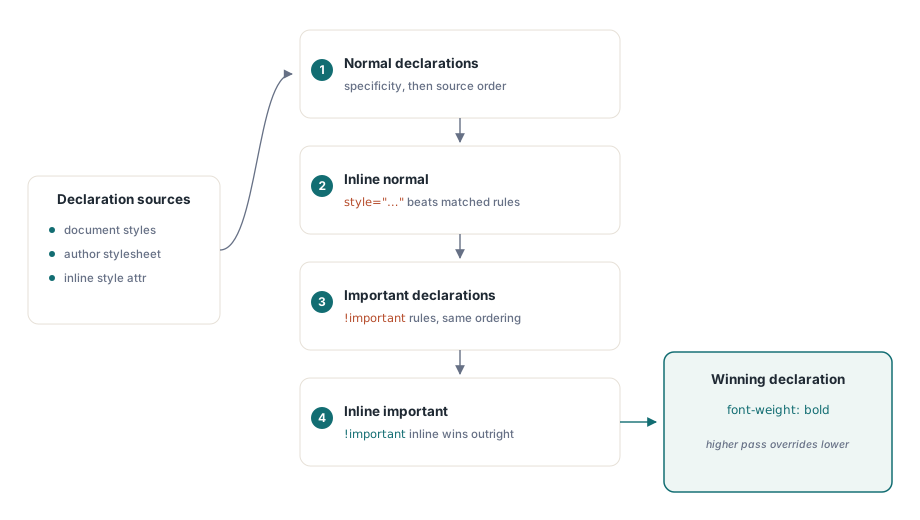
把这一切压缩成"后来者优先"的实现,能处理好常见情形,却会在有意思的情形上出错,而这比统一出错更糟糕,因为这种失败只会出现在用 !important 覆盖基础样式表的模板里——恰恰是那些编写者本就指望层叠机制能正常工作的模板:
uses
  HPDFDoc, HPDFHTMLImport;

var
  Pdf: THotPDF;
  Importer: THPDFHTMLImporter;
  Html, Css: WideString;
begin
  Pdf := THotPDF.Create(nil);
  Importer := THPDFHTMLImporter.Create(Pdf);
  try
    Pdf.FileName := 'statement.pdf';
    Pdf.BeginDoc;

    Importer.Margin := 56;              // points
    Importer.BaseFontName := 'Arial';
    Importer.BaseFontSize := 10;
    Importer.CreateAcroForms := False;  // 渲染控件,不创建字段

    Css := '@page { margin: 56pt } ' +
           'table { border-collapse: collapse } ' +
           'tr.total { page-break-inside: avoid; font-weight: bold }';
    Html := LoadTemplate('statement.html');

    if not Importer.RenderHTML5(Html, Css) then
      raise Exception.Create('nothing was emitted - check the markup');

    Pdf.EndDoc;

    Writeln(Format('profile=%d nodes=%d rules=%d layout ops=%d',
      [Importer.Statistics.ProfileVersion,
       Importer.Statistics.ParsedNodeCount,
       Importer.Statistics.CSSRuleCount,
       Importer.Statistics.LayoutOperationCount]));
  finally
    Importer.Free;
    Pdf.Free;
  end;
end;
第二个参数是一份作者样式表,与文档自带的样式一并应用,这是一种干净的方式,可以在不修改每一份模板的前提下强制执行页边距、孤行控制之类的统一规则
为什么导入器从不主动获取任何内容?
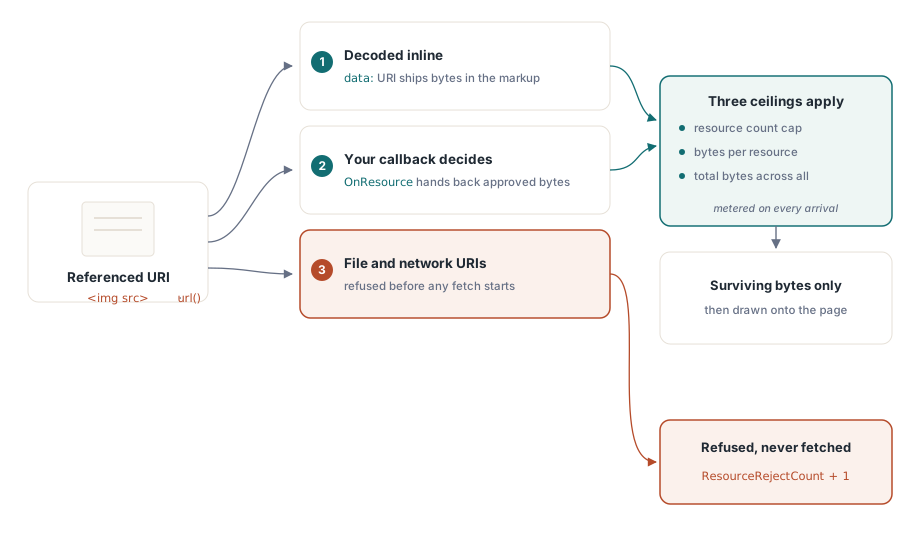
一个会解析外部引用的 HTML 转 PDF 转换器,本质上是一台披着文档生成外衣的服务端请求伪造引擎。把它指向用户提交的标记内容,它就会欣然去抓取 http://169.254.169.254/,或者从你的应用服务器上抓取一个 file URL,并把结果嵌进某个人即将下载的 PDF 里
因此 HotPDF 默认既不读文件也不访问网络。图像及其他资源只有两种到达方式:作为标记内容内部的 data: URI,或者通过 OnResource 回调,由你的代码决定某个 URI 意味着什么并提供对应的字节:
procedure TReportForm.SupplyResource(Sender: TObject;
  const URI: WideString; ResourceKind: THPDFHTMLResourceKind;
  var Data: TBytes; var ContentType: string; var Handled: boolean);
begin
  Handled := False;
  // 只从允许列表中的本地资源目录提供文件。不要
  // 将 URI 传给 HTTP 客户端,也不要把它拼接到路径上
  // 未经先行验证
  if StartsText('asset:', URI) then
  begin
    Data := LoadAssetBytes(Copy(URI, 7, MaxInt));
    ContentType := 'image/png';
    Handled := Length(Data) > 0;
  end;
end;
每一个确实到达的资源,仍然要受到三条独立上限的约束:资源数量、每个资源的字节数、以及总字节数。一个老实返回所要求内容的回调,不会因为某个文档把同一张 50 MB 的图片引用两百次,就被诱导耗尽内存
四项预算,一种失败模式
解析节点、CSS 规则、布局操作和资源分别独立计量,因为它们会独立地失败。一个文档可能体积很小,但布局代价却高得离谱;另一个文档可能层级很浅,样式表却是专门设计来让选择器匹配爆炸的。任何一项耗尽都会引发 EHPDFHTMLImportBudget,这是一个专用的异常类,使预算耗尽可以与格式错误的输入分开捕获
每次调用 RenderHTML5 时统计信息都会重置,因此这些数字描述的是单次导入,而不是导入器对象的整个生命周期。在一个渲染不受信任模板的服务中,应按文档记录 ParsedNodeCount、LayoutOperationCount 和 ResourceRejectCount:拒绝计数持续上升,通常意味着某个模板作者引用了你的回调不认识的资源,而布局操作计数逼近上限,则意味着下一个稍大一点的文档就会失败
在 HTML 导入和布局 API 之间如何选择
当内容由非 Delphi 开发者以 HTML 形式编写、模板变化比代码更频繁,或者同一份内容还需要以邮件形式发送时,HTML 导入更胜一筹。当文档是由你自己的代码根据数据生成、需要自动输出 PDF/UA 结构,或者精确控制分页比编写便利性更重要时,带标记输出的声明式 PDF 布局 中所述的声明式布局树更胜一筹
两者并不互斥。一种常见做法是:报告正文用 HTML 导入,而页眉、页脚和签名区块则直接绘制,因为这些是固定几何结构,不该由任何模板来掌控。表格是唯一值得两种方式都实测一下的领域:复杂的财务表格有时通过 在 PDF 中生成表格 中所述的专用表格路径能获得更好的分页效果
请刻意设置 CreateAcroForms。关闭时,HTML 表单控件渲染为静态图形,这正是打印版对账单所需要的。开启时,它们变成真正可交互的 AcroForm 字段,这正是可填写表单所需要的,随之而来的字段行为见 向已加载的 PDF 添加表单字段
HTML 导入、声明式布局和直接绘制 API,在 Delphi 与 C++Builder 中面向同一个文档对象;完整功能列表见 HotPDF Delphi PDF 组件页面