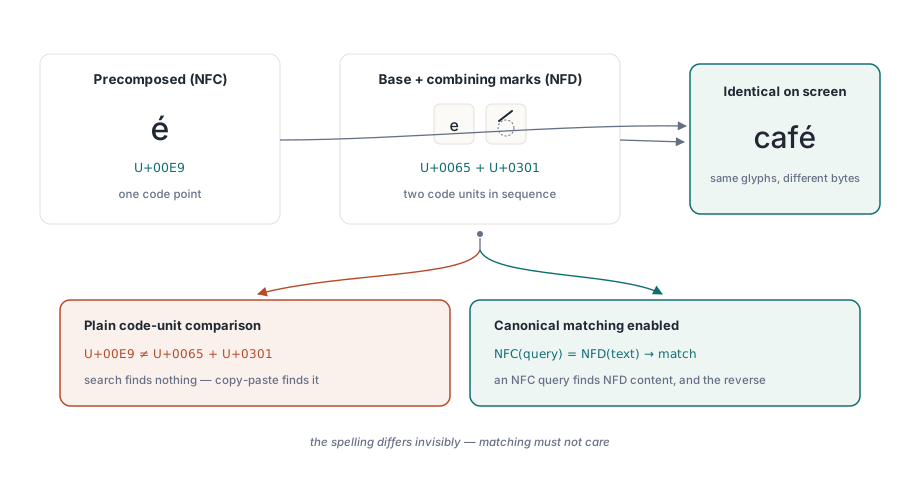
用户在搜索框里输入 Müller,一无所获;把同一个名字从 PDF 里复制出来、再粘回搜索框,突然就有结果了。在调试器里看这两个字符串,输入的那个 Length 返回 6,粘贴的那个返回 7。输入的词携带 U+00FC——单个预组合的 ü;文档里存的是普通 u 后跟 U+0308 COMBINING DIAERESIS。两者渲染出同样的字形,而代码单元比较永远不会判它们相等
看起来相同的字符串为什么比较起来不相等?
Unicode 刻意允许同一个抽象字符有不止一种编码,并称这些编码规范等价。Unicode Standard Annex #15 定义了两个与搜索相关的规范形式:NFC,倾向预组合码点;NFD,把每个预组合字符按固定顺序拆成基础字母加组合标记。带变音符号的拉丁字母两种形态都有;谚文音节也一样,可以是一个预组合音节,也可以是两三个结合字母(jamo)的序列
PDF 里最终是哪种形态,取决于生成它的软件、运行的平台,有时还取决于字体的 ToUnicode 映射是怎么建的。一台机器上输入、另一台机器上编辑的文档,同一页都能混用两种形式。搜索的人对此毫无察觉。他们的键盘和输入法几乎总是产出 NFC,于是文件里任何分解形式的内容从他们那边都搜不到
显而易见的变通是把这个问题扔进大小写折叠同一个桶:两边小写、去掉变音符、比较。因为一个结构性原因这样做行不通。大小写折叠和去变音符在代码单元层面是一对一的,折叠后的文本与原文长度完全一致,折叠副本里位置 17 的命中就是提取文本里位置 17 的命中。规范化改变长度:一个预组合字母变成两三个代码单元,一个分解序列缩回一个,谚文音节膨胀成字母——变换之后拿回来的位置不再指向你提取的那段文本
在 PDF Library for Delphi 中用 soCanonicalEquivalent 搜索
在 PDF Library for Delphi 里,TPDFlibSearchOptions 的 soCanonicalEquivalent 成员让 SearchText 比较查询与页面文本的规范分解,于是 NFC 查询找到 NFD 内容,NFD 查询找到 NFC 内容。这个选项是集合的一员,意味着它与 soWholeWord、soCaseSensitive、soWildcards 和 soDiacriticInsensitive 组合使用,不需要任何单独的 API:
uses
  SysUtils, Math, PDFlibrary;

var
  Lib: TPDFlib;
  Hits: array of TPDFlibSearchHit;
  Found, Stored, I: Integer;
  Slice: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contracts.pdf', '');
    Lib.SearchContextChars := 24;      // 填充 ContextBefore / ContextAfter
    SetLength(Hits, 500);

    Found := Lib.SearchText('Bäcker',
      [soCanonicalEquivalent, soWholeWord, soGraphemeClusters],
      '', Hits);                       // 空页码范围 = 每一页

    // Found 统计全部命中;只有前 Length(Hits) 个被拷入数组
    Stored := Min(Found, Length(Hits));
    for I := 0 to Stored - 1 do
    begin
      Slice := Copy(Hits[I].MatchText, Hits[I].MatchStart,
        Hits[I].MatchLength);
      Writeln(Format('page %d: [%s] %d code units, ...%s|%s|%s...',
        [Hits[I].Page, Slice, Hits[I].MatchLength,
         Hits[I].ContextBefore, Slice, Hits[I].ContextAfter]));
    end;
  finally
    Lib.Free;
  end;
end;那个循环里有两个细节坑人。SearchText 即使缓冲区更小也返回命中总数,所以在大型文档上迭代到 Found - 1 会走出一个 500 元素数组的末端;用 Min 截断,或改用 SearchTextEach——它把每个命中交给回调,完全不需要缓冲区。MatchText 是包含匹配的那整个文本块,MatchStart 是其中从 1 计的索引,所以被匹配的词本身就是上面那段 Copy
对一个以分解形式存 Bäcker 的文件跑这段代码,打印的长度是 7;对 NFC 文件则是 6。同一查询、同一选项集。切片永远是文档里的原样文本
命中落在原文的哪个位置
最后那条性质让规范化搜索在"是/否"之外还有用处。PDF Library for Delphi 为规范化器产出的每个代码单元记录它来自的原始 UTF-16 区间的起止。递归分解继承父节点的区间,组合合并输入的区间;找到匹配时,搜索在映射区间上扫出最小起点和最大终点
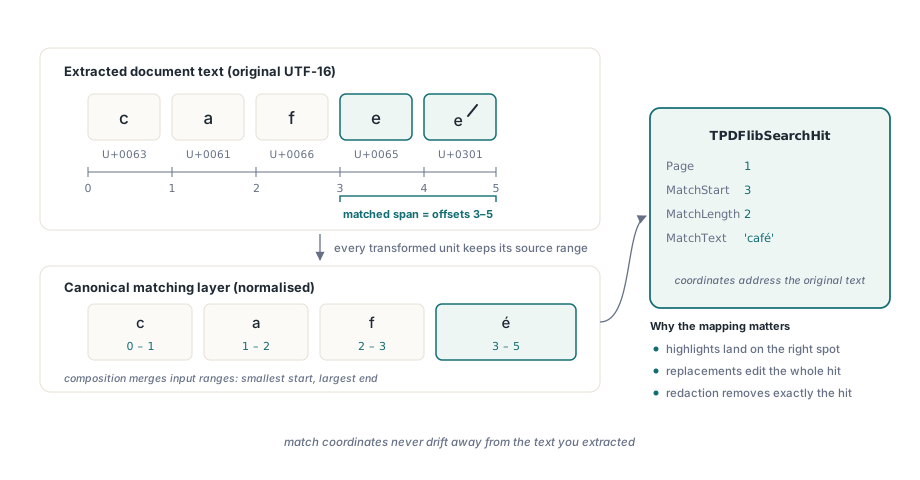
于是 MatchStart、MatchLength、ContextBefore、ContextAfter 和两个替换入口针对的都是调用者手里已有的提取文本。一个只能说"这个块里有一处命中"却说不出确切位置的搜索,当结果计数还行,用于其他一切都会出错:高亮会随每个带音符的字母漂移一两个字符,替换则会改写错误的文本段
规范化器随库一起交付。它携带取自 Unicode 15.1 的紧凑表格——规范分解、组合和规范结合类——谚文用算法规则处理而不是表项,NFD 期间稳定地重排组合标记。不加载任何外部数据文件、不调用任何操作系统规范化函数,所以 Windows 服务、Linux 守护进程和 Free Pascal 构建对同一份文件返回完全相同的命中。Windows 上明明可以让操作系统代劳,我们仍偏好这样做:在一台服务器上建、在另一台上查询的搜索索引,不应该因为两台机器的 Unicode 版本不同而得出不同结果
该选项默认关闭,这个默认是合理的。构建 NFD 文本和位置映射要花时间,纯 ASCII 发票上的搜索永远用不着它。设置 soCanonicalEquivalent 后,每个文本块保留两份变换副本——一份带组合标记、一份不带——所以对同一块的一批查询只规范化一次。普通大小写折叠继续走更便宜的一对一路径
命中的结尾落在一个字符中间会出什么错?
规范等价回答"这是不是同一段文本",但对命中允许停在哪里只字未提。只带 soCanonicalEquivalent 在分解形式的 café 里搜 cafe,前四个代码单元匹配,后面的组合尖音符留在命中之外。soWholeWord 抓不住它,因为它的单词字符遵循标识符规则(ASCII 字母、数字和下划线),组合标记算边界。高亮盖住 cafe,替换则在接下来的内容上留一个悬空的音符
同样的事情远不止拉丁变音符。国旗 emoji 是两个区域指示符码点;家庭 emoji 是若干个由零宽连接符相连的人物;天城文的连字是一个辅音、一个 virama 加另一个辅音;越南语的元音可以叠两个标记。基本多文种平面之外的任何东西在 UTF-16 里都是代理对,把它拦腰切断会产出一个未配对代理,许多文本管线会把它替换成 U+FFFD
soGraphemeClusters 要求每处命中——字面或通配——的两端都落在 Unicode Standard Annex #29 定义的扩展字位簇边界上。分段覆盖 CR/LF 配对、控制字符、谚文音节类型、Extend 与 SpacingMark、Prepend、emoji ZWJ 序列、区域指示符对和印度系连字断点,并且从不在代理对内部放边界。设了这个标志,cafe 根本不再匹配分解形式的 café;如果你真想要不区分音符的匹配,加 soDiacriticInsensitive
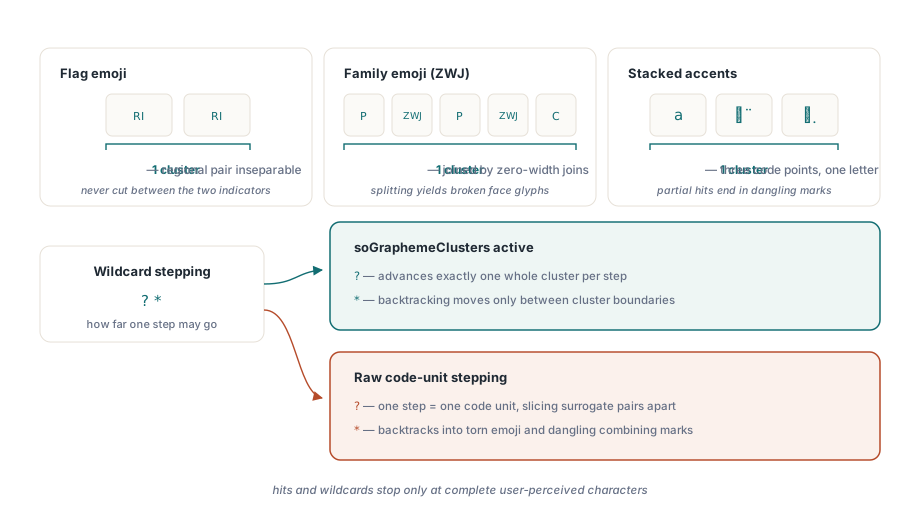
通配符是这个标志改变结果最显眼的地方。soCanonicalEquivalent 下页面文本按 NFD 比较,côté 变成 c o U+0302 t e U+0301,不管文件当初怎么存的。没有 soGraphemeClusters 时,c?té 里的 ? 恰好吃掉一个代码单元——o——然后期待 t,遇到的却是 U+0302。没有命中。有了这个标志,? 前进一整个簇,* 的回溯也只在簇边界之间移动:
// "?" 每次步进一个用户可感知的字符,所以这条查询能匹配 côté
// 无论 PDF 存的是预组合还是分解形式
Found := Lib.SearchText('c?té',
  [soWildcards, soCanonicalEquivalent, soGraphemeClusters], '', Hits);

// 替换走同样的簇安全范围,因此永远不会
// 切开一个 emoji 或留下一个悬空的变音符
Replaced := Lib.SearchAndReplaceTextInContent('naïve', 'plain',
  [soCanonicalEquivalent, soGraphemeClusters], '1-20');
if Replaced = 0 then
  Writeln(Lib.GetLastUnicodeReplacementDiagnostics)
else
  Lib.SaveToFile('contracts-edited.pdf');
SearchAndReplaceTextInContent 重写页面内容里的文本,返回替换的匹配数。返回零时,GetLastUnicodeReplacementDiagnostics 会说明原因,比如某个匹配无法映射回绘制它的内容。另一个入口 SearchAndReplaceText 接受同样的选项集,改为在匹配块上绘制替换
按工作负载挑选选项集
三种组合覆盖大多数应用。文档查看器里的最终用户搜索框:soCanonicalEquivalent 加 soDiacriticInsensitive——两种编码形式都匹配,带音符与不带音符的拼法也都匹配,这正是被多年网页搜索养出来的预期。法务或合规审查——一次误报要花掉某人一下午:soCanonicalEquivalent 配 soCaseSensitive 和 soWholeWord,音符折叠保持关闭,等价保持精确,只是无视文件碰巧采用的编码方式
任何要改动文档的操作,一律加上 soGraphemeClusters。这是我们唯一不愿留给口味的地方:返回范围短了一个代码单元的搜索只是误导看结果的人;用同样范围的替换或移除会把错误写进文件,直到页面被打印或再次提取都没人发现。必须销毁内容而非遮盖的移除是另一个话题,见 真正的涂黑与内容移除
多条查询打同一份文档时,优先 SearchTextBatch。它在页面文本块驻留期间求值每一条非空查询,每页只提取一次、每块只规范化一次,而且每条查询带自己的选项集:
var
  Queries: array[0..2] of TPDFlibSearchQuery;
  BatchHits: array of TPDFlibSearchBatchHit;
  Count, I: Integer;
begin
  Queries[0].Query := 'Müller';
  Queries[0].Options := [soCanonicalEquivalent, soDiacriticInsensitive];
  Queries[1].Query := '서울';                // 谚文:文件里可能是 NFC 也可能是字母形式
  Queries[1].Options := [soCanonicalEquivalent, soGraphemeClusters];
  Queries[2].Query := 'Nguyễn';
  Queries[2].Options := [soCanonicalEquivalent, soCaseSensitive,
    soWholeWord, soGraphemeClusters];

  SetLength(BatchHits, 2000);
  Count := Min(Lib.SearchTextBatch(Queries, '', BatchHits),
    Length(BatchHits));
  for I := 0 to Count - 1 do
    Writeln(Format('query %d -> page %d',
      [BatchHits[I].QueryIndex, BatchHits[I].Hit.Page]));
end;命中按页、块、查询排序返回,QueryIndex 是你传入数组里的从零位置。SearchTextBatchEach 是给预先定不了大小的结果集用的回调形式。文本块最初如何提取,见 文本搜索与页面元素枚举
哪些文字上规范等价不是可选项
对韩语,规范等价决定一个名字能不能被找到,因为预组合音节和分解字母在真实文档里都会出现。越南语在可能已带短音符或扬抑符的元音上再叠一个声调标记,组合形式完全取决于生成方。对天城文、孟加拉文和其他印度系文字,连字规则决定命中边界是否落在阅读者能认出的位置。日语和中文在搜索这一侧相对省事,排版那一侧则不然,见 日语与中文的竖排
我们的建议直截了当:语料里含任何英语以外的语言,先打开 soCanonicalEquivalent,在自己的文档上实测计时、确认成本不可接受之后再关掉。它拦下的失效,恰好砸在用户搜索最多的那些名字上
同一个支持 Unicode 的引擎在 Delphi、C++Builder 和 Free Pascal 下驱动搜索、提取、替换与涂黑;选项集、批量 API 和文本工具箱的其余部分列在 PDF Library for Delphi 产品页