PDFlibPas(Delphi PDF 库)能导入 JPEG 压缩超出 8-bit baseline 的 TIFF 图像:12-bit 扩展顺序(SOF1)、Huffman 无损(SOF3)、算术编码(SOF9 和 SOF10),以及带表偏移的旧式 TIFF 6.0 JPEG。由于 PDF 的 DCTDecode 承载不了这些压缩方式,PDFlibPas 用原生 Pascal 解码它们,并以每分量 8 或 16 位把样本无损嵌入
完整支持需要 v3.724.0 或更高版本,瞄准的正是扫描仪、医疗与科学采集软件,以及冻结在 20 世纪 90 年代的归档系统产出的 TIFF。下文讲清楚:这些变体为什么不能原样拷进 PDF、PDFlibPas 如何把它们落进文档,以及一路上踩到的 Pascal 坑
为什么 12-bit JPEG 不能直接进 PDF?
12-bit JPEG 没法直接透传,因为 PDF 没有任何 filter 被要求解码它。ISO 32000-1 §7.4.8 围绕 JPEG baseline 格式定义 DCTDecode,PDF 1.3 加入了 progressive 扩展。该条款完全没有覆盖 12-bit 样本精度、ITU-T T.81 附录 H 的无损流程,或附录 D 的算术熵编码器。阅读器在 DCTDecode 流里遇到 SOF1 12-bit 帧或 SOF9 标记时,有权什么都不画,大多数阅读器也确实什么都不画
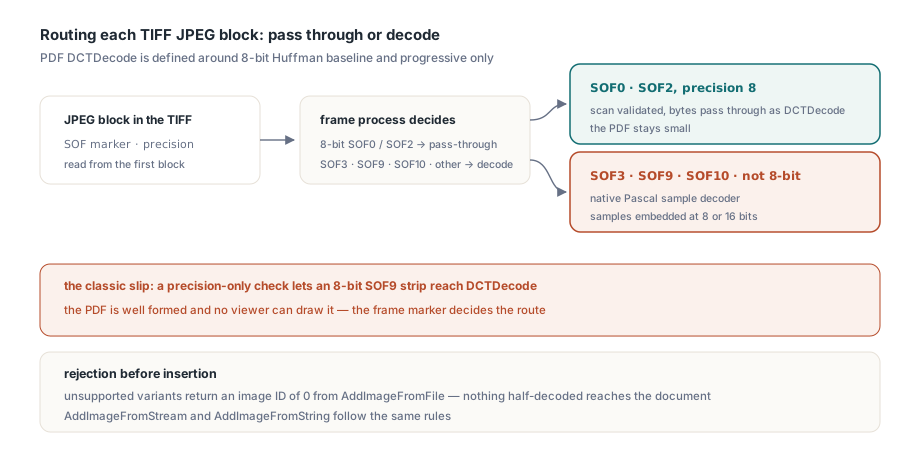
对构成大多数 TIFF 内 JPEG 的 8-bit Huffman baseline 和 progressive 条带,PDFlibPas 仍会校验每个 scan,然后把压缩字节按 DCTDecode 透传,让 PDF 保持小巧。其余一律解码。PDFlibPas 读取第一个 JPEG 块的帧标记和样本精度,一旦发现 SOF3、SOF9、SOF10 或精度不是 8,页面就走样本解码器而不是透传路径。靠帧标记识别算术编码比听起来重要得多:只看样本精度的检查,会让一个老式 TIFF 把 8-bit SOF9 条带塞进 DCTDecode 路径,产出阅读器无法显示的 PDF
PDFlibPas 往 PDF 里写的是什么
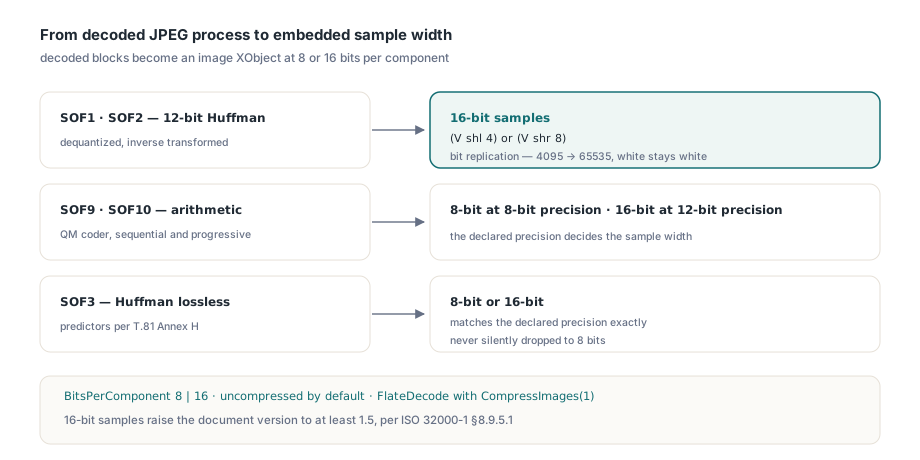
PDFlibPas 把解码后的 JPEG 块变成普通 image XObject,BitsPerComponent 为 8 或 16。样本默认不压缩存储;添加图像前调用 CompressImages(1),PDFlibPas 会用 FlateDecode 写入。ISO 32000-1 §8.9.5.1 从 PDF 1.5 起允许每分量 16 位,所以只要添加了带 16-bit 样本的图像,PDFlibPas 就把文档版本提到至少 1.5。多条带与分块图像也在内——它们的根对象是没有 BitsPerComponent 可查的 Form XObject
每种 JPEG 压缩方式的映射是固定的:
- 12-bit Huffman JPEG(顺序 SOF1、渐进 SOF2)经反量化、逆变换后扩宽为 16-bit 样本
- 算术编码 JPEG(顺序 SOF9、渐进 SOF10)在 8-bit 精度下产出 8-bit 样本,12-bit 精度下产出 16-bit 样本
- Huffman 无损 JPEG(SOF3)产出 8-bit 或 16-bit 样本,与其声明的精度严格一致
从 12 位扩到 16 位用的是位复制,(V shl 4) or (V shr 8),所以 4095 映射到 65535,白色仍是白色,而不是卡在 65520。PDFlibPas 从不背着你把这些图像降到 8 位。库为自己的显示表面栅格化这类页面时用的是每个样本的高字节,但嵌入 PDF 的图像完整保留 16 位
代价是文件体积:即使开了 CompressImages(1),Flate 压缩的 16-bit 样本也比原来的 DCT 数据大,不开就更大。对诊断和归档工作流,这笔交换通常是划算的。如果某个项目里体积更要紧,Delphi 缩减 PDF 文件体积指南会告诉你字节到底花在哪
用 TPDFlib 导入这些 TIFF
调用代码完全不变。TPDFlib.AddImageFromFile(Const FileName: WideString; Options: Integer): Integer 在 Options 里传 1 基的 TIFF 页码,返回图像 ID,无法导入该页时返回 0。不支持的 JPEG 变体在插入图像之前就被拒绝,所以返回 0 意味着没有任何解码到一半的东西进入文档
uses
  PDFlibrary;

function TiffToPdf(const TiffName, PdfName: WideString): Boolean;
var
  Lib: TPDFlib;
  Page, PageCount, ImageID: Integer;
  DPI, W, H: Double;
begin
  Result := False;
  Lib := TPDFlib.Create;
  try
    Lib.SetMeasurementUnits(0);   // 默认用户空间,1/72 英寸
    Lib.SetOrigin(1);             // DrawImage 用左上角原点
    Lib.CompressImages(1);        // 解码后的样本用 Flate
    PageCount := Lib.GetImagePageCount(TiffName);
    if PageCount = 0 then
      Exit;
    for Page := 1 to PageCount do
    begin
      ImageID := Lib.AddImageFromFile(TiffName, Page);  // Options = TIFF 页码
      if ImageID = 0 then
        Exit;                     // 不支持或已损坏的图像数据
      Lib.SelectImage(ImageID);
      case Lib.ImageResolutionUnits of
        2: DPI := Lib.ImageHorizontalResolution;          // 点每英寸
        3: DPI := Lib.ImageHorizontalResolution * 2.54;   // 点每厘米
      else
        DPI := 0;
      end;
      if DPI <= 0 then
        DPI := 300;
      W := Lib.ImageWidth * 72 / DPI;
      H := Lib.ImageHeight * 72 / DPI;
      if Page > 1 then
        Lib.NewPage;
      Lib.SetPageDimensions(W, H);
      Lib.DrawImage(0, 0, W, H);
    end;
    Result := Lib.SaveToFile(PdfName) = 1;
  finally
    Lib.Free;
  end;
end;不需要任何按格式分支的代码,AddImageFromStream 和 AddImageFromString 对内存中的 TIFF 数据遵循同样的规则
旧式 JPEG:表在偏移处,条带没有头
自 v3.713.0 起,PDFlibPas 可导入旧式 JPEG 的 TIFF(Compression = 6),其表来自 JPEGQTables、JPEGDCTables 和 JPEGACTables 偏移标签,或来自只含表的 JPEGInterchangeFormat 流。TIFF 6.0 第 22 节定义了这种布局,TIFF Technical Note 2 后来用 Compression = 7 和共享的 JPEGTables 标签取代了它,但扫描仪们照写旧格式写了很多年
容器一侧(BigTIFF 与分块布局)在 TIFF 解码器加固记里有讲;这里聚焦 JPEG 载荷。每个表偏移标签指向一段原始 64 字节量化表,或一个 Huffman 表(16 个 counts 加其值),每分量一项。PDFlibPas 把它们变成合成 JPEGTables 流里的 DQT 和 DHT 段。随后每段裸熵编码数据都会配一个自己的头:SOI、带该条带行数的帧标记、设了 JPEGRestartInterval 时的 DRI、SOS、熵数据和 EOI。这些条带不能粘成一个 scan,因为旧式 JPEG 在每个条带边界都重启 DC 预测
有两个细节容易做错。YCbCr 图像的三个分量常常把表偏移指向同一批字节,所以 PDFlibPas 在分配表编号前先按内容去重。若某一类 Huffman 表剩下超过两张,合成帧用 SOF1 而不是 SOF0,因为 baseline 帧最多只能引用两张 DC 表和两张 AC 表。当 JPEGInterchangeFormat 指向的是包含 scan 的完整 JPEG 流时,PDFlibPas 把那个流当作整幅图像,作为单个新式条带导入。无损、分块和独立平面的旧式 JPEG 会明确报错拒绝而不是瞎猜,这类文件请先在上游转成新式 JPEG
为什么 TIFF 里的 CMYK JPEG 会反色?
当导入器把属于独立 JPEG 文件的 Adobe APP14 约定套到 TIFF 上时,TIFF 里的 CMYK JPEG 就会反色。Photoshop 往独立 JPEG 里写的是反转 CMYK,所以 PDF 生产工具传统上会加 /Decode [1 0 1 0 1 0 1 0] 来补偿。TIFF PhotometricInterpretation 5 把样本定义为油墨量,0 表示无墨,主流 TIFF 阅读器对解码出的 JPEG 样本按字面值使用,根本不看 APP14
PDFlibPas 嵌入 JPEG 压缩的 CMYK TIFF 条带时不加反转 Decode 数组,无论有没有 APP14 标记。APP14 的 transform 标志仍然决定 YCCK 是否转成 CMYK,这一步由 DCTDecode 自己处理。独立的四分量 JPEG 文件保留反转的 Adobe 约定,所以同一批 JPEG 字节会因容器不同而区别对待——这是两种格式各自的要求
为什么无损 JPEG 解码会栽在一个 Pascal 移位上?
无损 JPEG 解码在 Pascal 里会栽,是因为预测子 5 和 6 需要算术右移,而 Pascal 的 shr 是逻辑移位。SOF3 用左侧(Ra)、上方(Rb)和左上(Rc)邻居预测每个样本,只编码差值。T.81 表 H.1 的七个预测子里,预测子 5 是 Ra + ((Rb - Rc) >> 1),预测子 6 是 Rb + ((Ra - Rc) >> 1),只要左上邻居更亮,括号里的差值就是负数。把负 Integer 交给 shr,符号位就变成了数值位,图像随之溶解成噪点
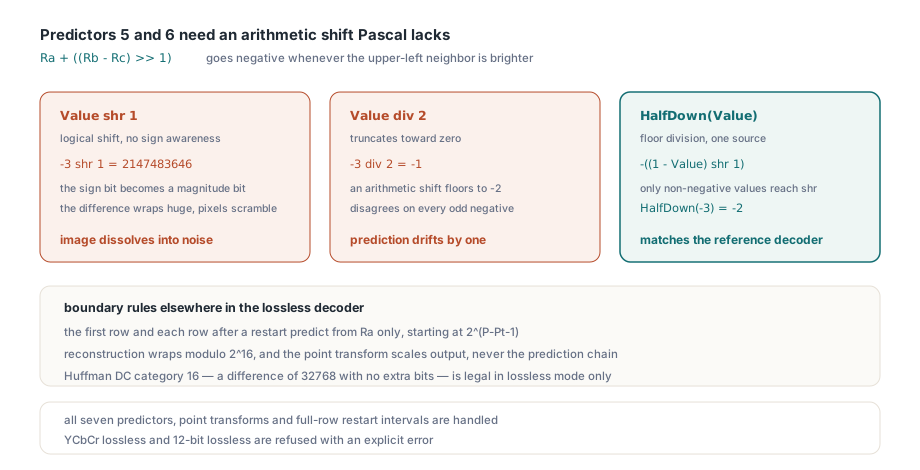
把移位换成 div 2 也救不了。div 向零截断,算术移位向负无穷取整,每个奇数负值上两者都不同。Free Pascal 的 System 单元里有 SarLongint;Delphi 没有等价物,所以 PDFlibPas 用一个在两边编译出相同行为的辅助函数:
// 算术右移一位:floor(Value / 2)
// shr 是逻辑移位,div 2 向零截断
function HalfDown(Value: Integer): Integer;
begin
  if Value >= 0 then
    Result := Value shr 1
  else
    Result := -((1 - Value) shr 1);
end;

// Value = -3 时:-3 shr 1 = 2147483646,-3 div 2 = -1,HalfDown(-3) = -2
同一类问题的类型宽度一面,见 Delphi Linux64 上的 Longint 与指针陷阱
无损解码器的其余部分有自己的边界规则。第一行以及每个 restart 标记后的第一行只用左邻居预测,起点是精度 P、点变换 Pt 下的 2^(P−Pt−1);之后每行从上方样本出发。重建按 2^16 取模回绕,点变换只缩放输出,从不动预测链。Huffman DC 类别 16——不带附加位的 32768 差值——只在无损模式下合法,所以表解析器在还不知道帧会声明哪种压缩方式时就得接受它
PDFlibPas 支持全部七个预测子、点变换以及覆盖整行的 restart 间隔。JPEG 精度必须等于 BitsPerSample 且为 8 或 16,每个分量必须 1x1 采样。YCbCr 无损数据和 12-bit 无损 JPEG 会明确报错拒绝
原生 Pascal 里的 12-bit DCT 与算术编码
PDFlibPas 的 12-bit 解码器和算术解码器共用一个逆 DCT,只在熵解码上不同。12-bit Huffman JPEG 里,DC 类别最高 15、AC 类别最高 14,量化表可能带 16 位条目,DC 预测在每个 scan 和每个 restart 都重置。系数保持 zigzag 顺序直到反量化——反量化必须用同一 zigzag 下标处的量化值——然后才换到自然顺序做可分离的两遍 IDCT。解码样本与独立浮点参考解码器的差距在 ±1 以内
算术编码用 T.81 附录 D 的 QM 编码器取代 Huffman:114 项概率状态表、64 格 DC 统计区和 256 格 AC 区,由 DAC 段给出的条件化参数驱动(默认 L = 0、U = 1、Kx = 5)。统计、DC 上下文和预测在每个 restart 间隔和每个 scan 开始时重置。这正是 PDFlibPas 为算术图像规范化共享 JPEGTables 时保留 DAC 段的原因:丢掉它们,每条条带都会用错误的统计模型解码
v3.723.0 给这些解码路径加入了下采样分量和按 JFIF 公式的 YCbCr 转 RGB,v3.724.0 又加入 12-bit Huffman(SOF2)和算术(SOF10)两种数据的 progressive scan。下采样色度用复制补到全分辨率而不是平滑插值——这正是参考解码器关掉色度平滑时的行为。Hierarchical JPEG 和算术编码无损 JPEG(SOF11)明确报错拒绝
在 Delphi 里测试二进制 JPEG 测试数据
Delphi 单元测试里手工拼的 JPEG 测试数据,可能以极像解码器 bug 的方式失败。由 #$xx 字符拼出、超过 255 字符的字符串常量会被推断为 UnicodeString,赋给 AnsiString 时会经过当前代码页转换。熵编码数据里随处可见的 $80 到 $9F 字节就在这一步被改写。运行时拼标记头也有同样的坑:在 Delphi 里 AnsiChar + AnsiChar 得到 UnicodeString,所以请向 AnsiString 追加单字节,或用 SetLength 加下标赋值。测试数据建议存十六进制文本,运行时再解码:
uses
  SysUtils, PDFlibrary;

function HexToBytes(const Hex: AnsiString): AnsiString;
var
  I: Integer;
begin
  SetLength(Result, Length(Hex) div 2);
  for I := 1 to Length(Result) do
    Result[I] := AnsiChar(StrToInt('$' + string(Copy(Hex, I * 2 - 1, 2))));
end;

// 测试数据保持纯 ASCII,任何代码页都碰不到它
ImageID := Lib.AddImageFromString(HexToBytes(TiffHex), 1);生成测试图像时注意:jpegtran -arithmetic 写的是顺序 SOF9;SOF10 还得加上 -progressive。另外,非零图像 ID 只证明导入被接受。请渲染页面并比较像素,因为透传错误产出的 PDF 结构完好,只是没有任何阅读器画得出来
把遗留扫描档案装进 PDF
这些 JPEG 变体往往在档案迁移时一口气冒出来。PDFlibPas 用与其他格式同一个 AddImageFromFile 调用读取 12-bit、无损、算术和旧式 JPEG 的 TIFF,在 PDF 里保留完整精度,并对该集合之外的稀有压缩方式明确报错拒绝。授权、完整功能清单和试用下载见 PDFlibPas PDF Library for Delphi 产品页