PDFlibPas在Object Pascal里用同一个Keccak-f[1600]置换实现SHA-3和SHAKE256。两个家族恰好有两处不同:pad10*1域字节,按FIPS 202 §6.2和§6.3,SHA-3用$06、SHAKE用$1F;以及rate规则。SHAKE256不管输出多长都把rate钉在136字节
第二个区别正是人们搞错的那个,因为它看起来根本不像区别。SHA3-256也跑在rate 136上,所以照抄SHA-3代码路径做出来的SHAKE256,能通过你扔给它的每一个32字节测试,然后第一次有人要64字节时就产出乱码。接下来讲的是两个家族在PDFlibDigest里如何共享一个上下文记录、一次性入口停在哪里,以及为什么流式XOF必须在Ed448或ML-DSA之前就存在
为什么SHA-3和SHAKE256共享一个Keccak上下文?
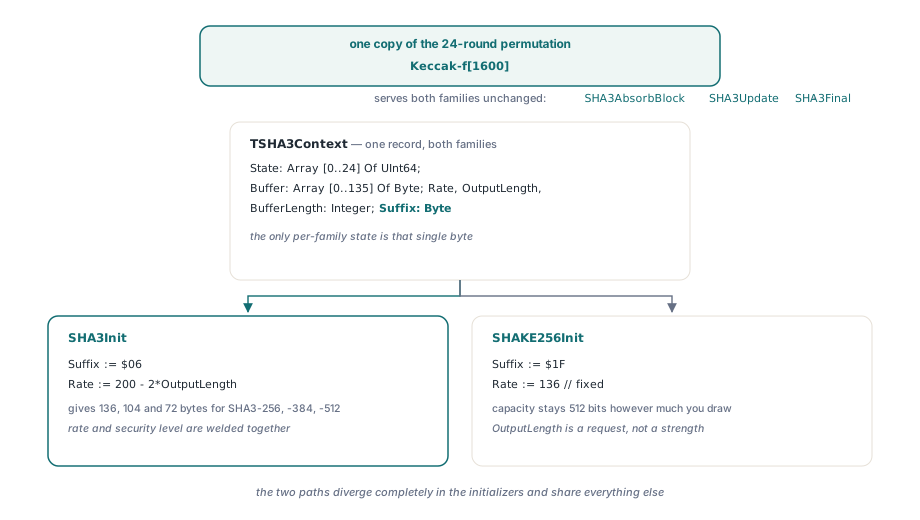
因为每个家族独有的状态只有一个字节,PDFlibPas把它作为Suffix存在TSHA3Context里。域分隔符一旦住进上下文而不是硬编码在收尾例程里,SHA3AbsorbBlock、SHA3Update和SHA3Final就能原样服务两个家族,库里的24轮置换也只剩一份。两条路径的分岔点在初始化器,而且它们完全分岔
Type
  TSHA3Context= Record
    State: Array [0.. 24] Of UInt64;
    Buffer: Array [0.. 135] Of Byte;
    BufferLength: Integer;
    Rate: Integer;
    OutputLength: Integer;
    // Domain separator: $06 for SHA3, $1F for SHAKE (FIPS 202 §6.2/6.3)
    Suffix: Byte;
  End;

Procedure SHA3Init(Var Context: TSHA3Context; OutputBits: Integer);
Begin
  FillChar(Context, SizeOf(Context), 0);
  Context.OutputLength:= OutputBits div 8;
  Context.Rate:= 200- 2* Context.OutputLength;   // rate 随摘要大小变化
  Context.Suffix:= $06;
End;

// SHAKE256:rate 固定为 136 字节,无论调用方要求什么,
// 因为 SHAKE 是可扩展输出函数
Procedure SHAKE256Init(Var Context: TSHA3Context; OutputBytes: Integer);
Begin
  FillChar(Context, SizeOf(Context), 0);
  Context.OutputLength:= OutputBytes;
  Context.Rate:= 136;
  Context.Suffix:= $1F;
End;SHA3Init里的公式给SHA3-256、SHA3-384和SHA3-512分别算出136、104和72字节的rate,所以在定长家族里,rate和安全级别焊死在一起。SHAKE256Init刻意打破这条链接:OutputLength变成对字节数的请求,而不是安全强度的声明,无论你抽多少输出,海绵容量都保持在512位。这种解耦就是可扩展输出函数的定义,把它写成同一个上下文上的两个初始化器,区别在源码里一目了然,而不是埋在注释里
一次性入口上的136字节上限
PDFlibPas的便捷函数拒绝1..136字节之外的任何请求,这个限制是诚实的而不是任意的。SHAKE256StreamRange和SHAKE256ByteArray都走SHA3Final,它填充最后一块、置换一次、直接从状态里读输出。那个状态只有前Rate个字节是合法输出,所以一次squeeze最多产出136字节;再多,每一块都需要一次新置换。两个真实消费者反正都落在窗口里:PDF签名profile摘要32字节,Ed448按RFC 8032 §5.2需要114。SHAKE256StreamRange与SHA256StreamRange和SHA3_256StreamRange一样接受FirstLength、SecondStart、SecondLength三元组,所以校验代码对每种算法都以同样方式走签名/ByteRange,永远不必给XOF开特例
pad10*1在位置落到rate-1时会出什么错?
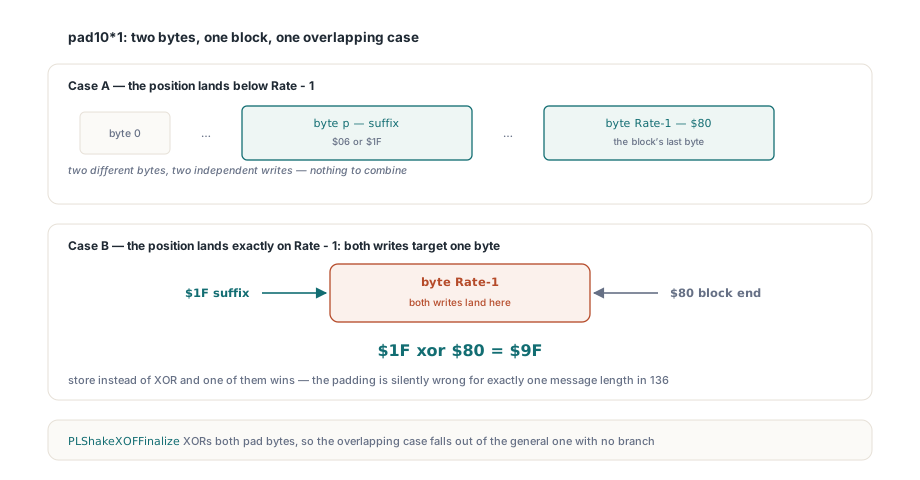
只要把两个pad字节XOR进状态而不是赋值,就什么事都不会出。FIPS 202 §B.2把域后缀放在当前吸收位置,把$80放在块的最后字节。当消息碰巧让位置停在Rate- 1时,这两次写入瞄准同一个字节,必须合并成$9F。用存储而不是XOR,其中一个就会赢,填充对136种消息长度里的恰好一种悄悄出错,而你拥有的每个回归向量都通过,因为没有一个落在那里。PDFlibPas的PLShakeXOFFinalize两个都XOR,让重叠情形无需分支就从一般情形里自然落出
// 填充最后一个不完整块,然后进入挤压阶段
Procedure PLShakeXOFFinalize(Var Ctx: TPLShakeXOF);
Begin
  If Not Ctx.Absorbing Then
    Exit;
  Ctx.Absorbing:= False;
  // suffix 在 SqueezePos,$80 在 Rate-1;当 SqueezePos = Rate-1 时,两处
  // 两次 XOR 落在同一个字节上,正确合并为 $9F
  Ctx.State[Ctx.SqueezePos div 8]:= Ctx.State[Ctx.SqueezePos div 8]xor
    (UInt64(Ctx.Suffix)shl (8* (Ctx.SqueezePos and 7)));
  Ctx.State[(Ctx.Rate- 1)div 8]:= Ctx.State[(Ctx.Rate- 1)div 8]xor
    (UInt64($80)shl (8* ((Ctx.Rate- 1)and 7)));
  SHA3Permute(Ctx.State);
  Ctx.SqueezePos:= 0;
End;
TPLShakeXOF:直接吸收进海绵
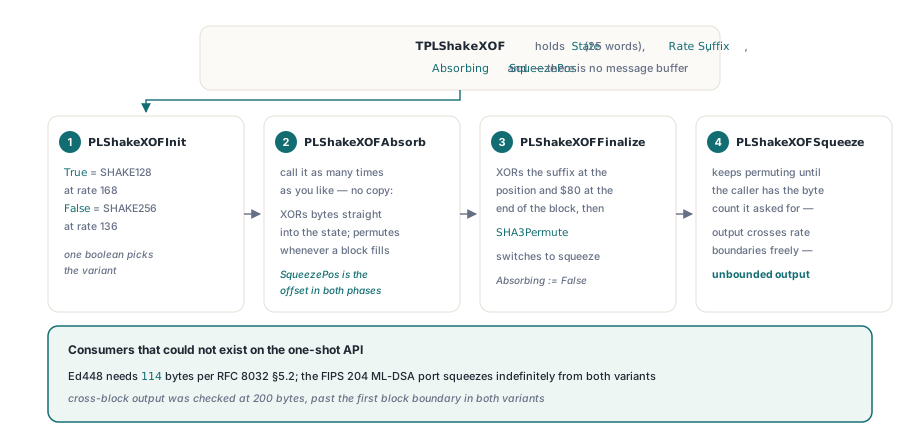
PDFlibPas通过一个独立记录TPLShakeXOF暴露无界输出,它只持有25个UInt64字的State、Rate、Suffix、一个Absorbing标记和SqueezePos。没有消息缓冲区:PLShakeXOFAbsorb把进来的字节直接XOR进状态,每填满一块就置换一次,SqueezePos在两个阶段都充当偏移。PLShakeXOFInit用一个布尔选变体,True是rate 168的SHAKE128,False是rate 136的SHAKE256,PLShakeXOFSqueeze持续置换直到调用方拿到要的字节数。跨块输出在200字节处做过检查,两个变体都越过了第一块边界
Var
  Ctx: TPLShakeXOF;
  Digest: Array [0.. 113] Of Byte;   // Ed448 wants 114 bytes, RFC 8032 §5.2
Begin
  PLShakeXOFInit(Ctx, False);        // False = SHAKE256, rate 136
  PLShakeXOFAbsorb(Ctx, @Dom4[1], Length(Dom4));
  PLShakeXOFAbsorb(Ctx, @Prefix[1], Length(Prefix));
  PLShakeXOFAbsorb(Ctx, @Msg[1], Length(Msg));
  PLShakeXOFFinalize(Ctx);
  PLShakeXOFSqueeze(Ctx, @Digest[0], SizeOf(Digest));
End;

// 或者,当你只需要一个输入缓冲和一个输出缓冲时:
// PLShakeXOF(False, Input, Output, 114)分多次调用吸收比看起来更重要。Ed448在哈希前给消息加一个dom4字符串和一个57字节的值,拒绝采样器则想在不先拼接字符串的情况下喂入种子和索引字节。让流式记录赶在两个消费者之前落地正是关键:纯Pascal Ed448和Brainpool曲线工作一次要114字节,FIPS 204 ML-DSA移植版则从两个变体无限squeeze。这两者都不可能对着一次性API写出来
为什么PDFlibPas拒绝把SHAKE256暴露为摘要选择器?
因为没有合法的挑选方式。PDFlibDigitalSign里的TPDFlibDigestAlgorithm枚举到daAuto、daSHA1、daSHA256、daSHA384、daSHA512、daSHA3_256、daSHA3_384、daSHA3_512就停了。没有daSHAKE256,这个省略是决定而不是疏忽。RFC 8702把SHAKE注册进CMS,但在PDF签名内部,ISO/TS 32002把SHAKE256放进的唯一位置是作为Ed448的内部摘要,由签名算法选择它,调用方不选。把它发布成独立DigestAlgorithm值,任何人都能把SHAKE256和RSA或ECDSA配对,产出一个没有校验器会接受的签名字典。能力随库发布,选择器不发布,验证侧代码直接对/ByteRange布局调用SHAKE256StreamRange。如果你今天要为对方必须能验证的签名选摘要,带时间戳和长期验证数据的PAdES B-B到B-LTA工作流里daSHA256到daSHA3_512仍然是答案;SHA-3什么时候在PDF里成为常规,那是ISO/TS 32001说了算
测试XOF:看起来通过的向量
比较完整输出长度,而且要用不止一个向量。空字符串的SHAKE256结果是人人都背下的那个,它偏偏因为被引用得太广而成为弱测试。abc的32字节SHAKE256输出更糟:它的前16字节483366601360a8771c6863080cc4114d与好几个邻近向量重合,所以截断比较会报告成功,而有区分力的那一半8db44530f8f1e1ee4f94ea37e78b5739反而没被检查。PDFlibPas的回归对两个向量都做全长度比较。再加一个跨块用例,因为从不跨越rate边界的squeeze循环等于完全没被测过
把SHAKE并入现有SHA-3实现得到的更大教训是:共享代码从来不是风险。Keccak-f[1600]对两个家族是同一个置换,它要么匹配向量,要么不匹配。风险在于那两个字节和一个整数——它们不同——也在于你必须诚实声明的上限,而不是让调用方自己去发现。想看清摘要层如何与原生Object Pascal代码库里的签名、加密和PDF/A工具并排相处,PDFlibPas Delphi PDF库产品页列出了完整组件集和支持的编译器矩阵