PDF Library for Delphi 可以通过 DeduplicateSimilarImages 合并 PDF 内部那些看起来一样、但字节并不完全相同的图片。精确去重只会合并字典和编码后负载都完全匹配的图片;而这个功能比较的是图片实际看起来的样子,使用一种感知哈希外加两项像素误差阈值,并把每一处引用都重定向到一个单一的规范对象
这个功能真正派上用场的,是那些无意中膨胀起来的文件。一批扫描件,每一页都带着同一个 logo,却被不同的扫描仪重新编码了一遍。一份由多个来源拼装而成的报告,每个来源都以略有差异的 JPEG 质量内嵌了同一张图表。一份缩略图被两种工具分别重新生成过的产品目录。在每一种情形下,文件里都装着同一张图片的许多份拷贝,而精确去重对它们一个都碰不到
"足够相似"必须意味着什么
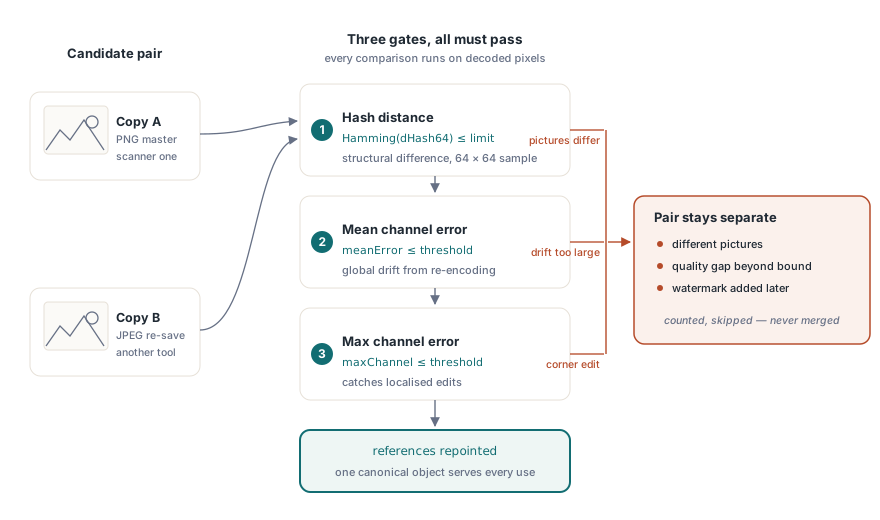
两张图片要被合并,必须同时满足三项阈值,每一项各自捕捉一种不同的差异。感知哈希距离约束的是结构性差异:从解码后图像的一个 64×64 采样中计算出一个 64 位差分哈希,允许的汉明距离范围是 0 到 7。平均通道误差约束的是整体偏移,这正是重新编码所产生的那种差异。单通道最大误差约束的是局部性差异,这正是一处小改动所产生的那种差异
要求三项同时满足,正是这次合并能站得住脚的原因。一张只在某个角落多了个水印的图片,平均误差很低而最大误差很高,因此最大误差这道关卡会把它拒之门外。一张被重新压缩过的图片,则处处都有一点微小的误差,因此能够通过。这正是一个体积优化器需要划清的那条界线
uses
  PDFlibrary;

var
  Lib: TPDFlib;
  Stats: TPDFlibImageSimilarityDedupStats;
  Merged: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('scanned-batch.pdf', '');

    // 哈希距离 2,平均误差 2,单通道误差 4。
    // 选项可以要求做一次预演,此时不会修改任何内容
    Merged := Lib.DeduplicateSimilarImages(2, 2, 4, 0, Stats);
    if Merged < 0 then
      raise Exception.Create('deduplication failed');

    Log(Format('%d scanned, %d merged, %d refs repointed, %d bytes duplicated',
      [Stats.ImagesScanned, Stats.ImagesDeduplicated,
       Stats.ReferencesRepointed, Stats.DuplicatePayloadBytes]));
    Log(Format('worst accepted: hash %d, mean %.2f, channel %d',
      [Stats.MaxAcceptedHashDistance, Stats.MaxAcceptedMeanError,
       Stats.MaxAcceptedChannelError]));
    Lib.SaveToFile('scanned-batch-optimised.pdf');
  finally
    Lib.Free;
  end;
end;
语义同一性先于视觉相似性
在比较任何像素之前,候选图片必须在语义上先一致。本库会从完整的图像字典中构建一个稳定的签名,排除 /Length、/Filter 和 /DecodeParms,因此尺寸、色彩空间、位深度、遮罩、/Decode 数组、插值方式、可选内容成员关系以及元数据都必须一致
这个先后顺序防止了一整类错误合并。两张图片在一个 64×64 的采样中可能看起来完全一样,但在页面上的表现却不同:一张 /Interpolate 为真而另一张不是,缩放时的平滑效果就会不同;一张属于某个可选内容组的图片,在该图层被隐藏时会消失。跨越这些边界去合并,产出的文档虽然更小,却是错的
只有间接的 Image XObject 才会被扫描。内联图片是一种经济性完全不同的构造,而无法解码的图片会被保守地跳过并计数,而不是凭空臆断地合并——没有像素证据,就没有合并
搜索是如何保持低成本的
把每张图片与其他每张图片逐一比较是平方级的开销,在一份包含成千上万张图片的文档上是不可接受的。因此这个哈希被拆分成八个 8 位的分段,并对每一段建立一个有序索引
鸽笼原理解决了剩下的问题:如果两个哈希值相差至多 7 位,它们在这八个分段中至少有一段必定完全一致。因此按分段逐一查找候选项,就能找到每一个符合条件的匹配,而不需要做一次穷举式的两两扫描,官方公布的 7 这个上限,正是因为这一保证只在该距离以内才成立
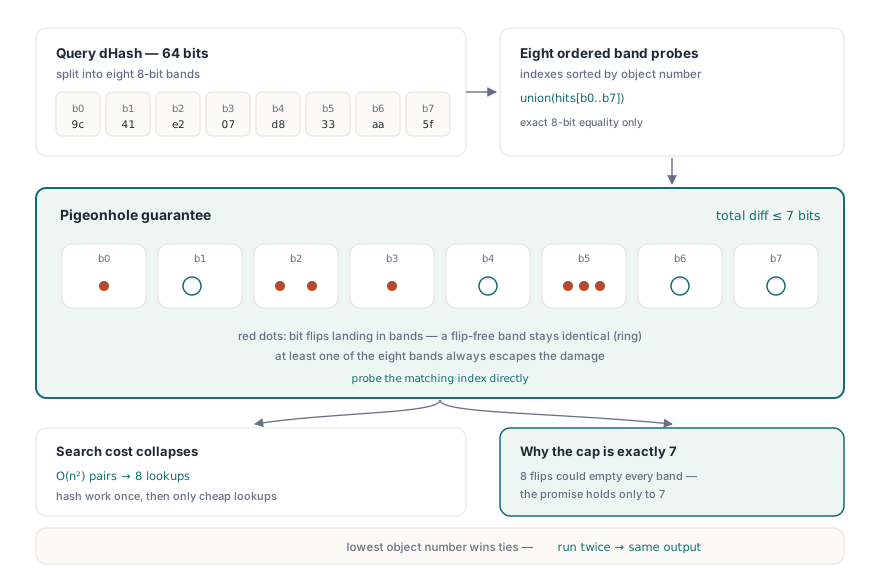
候选项和分段命中都按对象编号和世代号做确定性排序,编号最小的对象成为规范对象。这让输出结果是可复现的:对同一份输入运行两次优化器,会得到相同的规范选择,这在结果需要被比较或签名时很重要
预演模式与诚实的报告
由于这在"被合并的图片本非完全相同"这个意义上是一种有损优化,明智的工作流程是三思而后行。预演选项会报告哪些内容会被合并、能回收多少负载空间,而不会修改对象图,因此一个批处理作业可以先记录下影响,让人工审阅一次阈值,而不必逐个文件去审
报告中有两点诚实的说明值得一提。可回收数字只估算重复流的编码后负载,不计入字典、间接对象和交叉引用带来的开销,因此实际的文件体积缩减量会比报告的数字略大,而不是更小。报告还暴露了被接受的最大误差和比较工作量,这样你就能看出这些合并距离你设定的阈值有多近
固定的 64×64 采样网格是一种刻意的近似,它带来一个值得明说的后果:一处小于单个采样格的差异,即使在阈值为零的情况下也可能被忽略。扫描页面上一个改动过的单词,可能无法在这种采样下留下痕迹。当需要字节级别的证明时,改用精确去重路径——它只合并真正完全相同的资源,完全不做任何视觉判断
它在体积缩减流水线中的位置
按风险高低排列各个环节的顺序。先做精确资源去重,因为它是无损的,而且几乎不花代价。然后做字体子集化,这同样是无损的,通常也是文字密集型文档上单项收益最大的一步,见 PDF 文件体积优化与字体子集化。如果目标载体允许,再做图像重新压缩或降采样。感知去重应该排在这些环节之后,因为它是唯一一个结果取决于主观判断的步骤
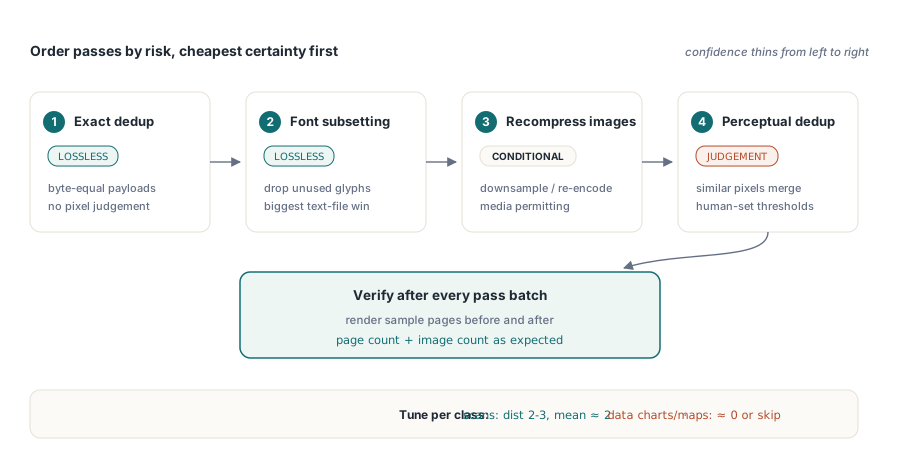
阈值应按文档类别选择,而不是全局统一设定。对于每一页都带着同一个信头的扫描批次,哈希距离取 2 到 3、平均误差取 2 左右,能可靠地合并信头。对于图片本身承载数据的文档——图表、地图、医学影像——应使用零或接近零的阈值,或者干脆跳过这一步,因为两张只在一个绘图点上不同的图表,无论在 64×64 下看起来多相似,都是两张不同的图表
优化之后要做校验。渲染优化前后的一部分页面样本并加以比较,检查页数和图片数量的变化是否符合预期。查看一份文档实际包含什么内容的检查方法,见 按类别审计 PDF 文件体积,这也是判断图片是否才是你真正的问题所在的最快方法
感知去重、精确资源去重和体积审计,在 Delphi、C++Builder 和 Free Pascal 中都作用于同一个对象图;完整功能列表见 PDF Library for Delphi 页面