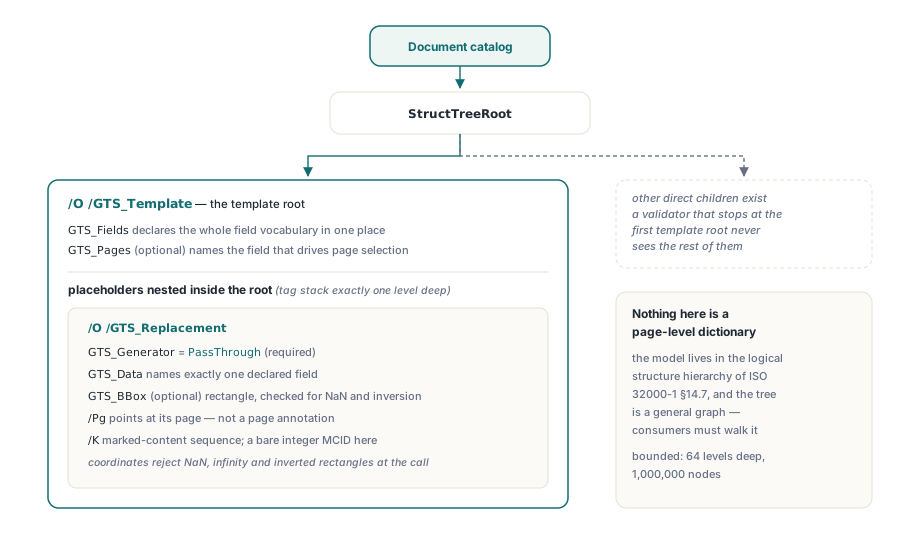
PDFlibPas把PDF/VCR-1实现为一种标记结构(tagged structure)profile:替换定义住在StructTreeRoot下的一个直接子分支里,模板根携带/O /GTS_Template来声明字段集,每个占位符携带/O /GTS_Replacement绑定一个数据字段。它没有任何东西是页面级字典
这一句话正是大多数实现搞错的地方,而搞错的代价不止是一次校验失败。一份替换计划被误读的可变数据作业不会崩溃。它会按量印刷出来,错误字段进错误框,第一个发现的人是拿着五万份邮件的那位客户
替换定义到底住在哪里
PDF/VCR-1把替换模型放在ISO 32000-1 §14.7描述的逻辑结构层级里,而不是放在私有的页面字典里。模板根是直接挂在StructTreeRoot下的结构元素,靠GTS_Template这个attribute owner区分,它通过GTS_Fields一次性声明整个字段词汇表,外加一个可选的GTS_Pages指定驱动页面选择的字段
占位符是嵌在那个根里面的结构元素,attribute owner是GTS_Replacement。每个占位符携带GTS_Generator(PDFlibPas要求它是PassThrough)、一个恰好命名一个已声明字段的GTS_Data值,以及可选的GTS_BBox。与页面的绑定也不是页面注释:元素通过/Pg指向它的页面,通过/K指向标记内容序列。选择结构而不是页面字典,随之而来的后果容易说也容易被低估:结构树是从catalog可达的一张通用图,所以任何消费这个profile的东西都得是树遍历器,带着这隐含的全部风险,而不是字典读取器。如果你以前没碰过结构树,机制在tagged PDF结构与无障碍里铺开了
为什么只检查第一个顶层分支会放坏文件过关?
因为StructTreeRoot可能有很多直接子节点,而一个找到模板根就停下的校验器永远看不到其余节点。这正是PDFlibPas要避免的那种具体失败,它产出的恰好是比完全不检查更糟的假通过:一份报告合规却包含第二个模板根的文件,或者一个待在模板分支外面、没有任何消费者会认它的占位符
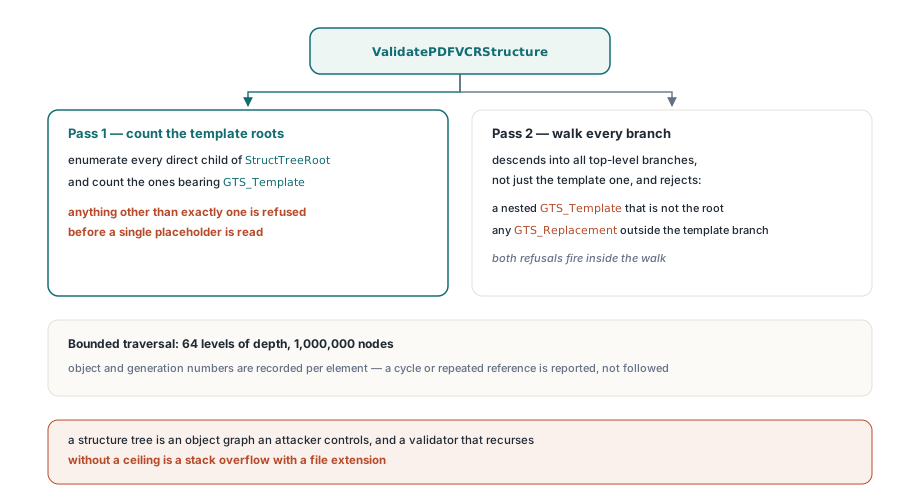
所以PDFlibPas的ValidatePDFVCRStructure对同一棵树跑两遍。第一遍枚举StructTreeRoot的每个直接子节点,数出带GTS_Template的;只要不是恰好一个,还没读任何占位符就拒绝。第二遍下潜进所有顶层分支,不只模板分支,一次拒绝两种东西:携带GTS_Template但不是根的内嵌元素,以及任何在模板分支外发现的GTS_Replacement元素
遍历限制在64层深度和1,000,000个节点,它记录访问到的每个元素的对象号和代代号,这样遇到循环或重复引用会报告而不是跟下去。这些数字不是性能调优。结构树是攻击者掌控的对象图,一个没有上限就递归的校验器,是带文件扩展名的栈溢出
编写模板,以及API拒绝变通的约束
PDFlibPas通过一个成对(bracketing)API暴露编写能力,在写入时就强制结构规则,而不是等到保存时才发现问题。SetPDFVCRMode把文档切进这个profile,内部要求ISO 15930-7的PDF/X-4基础模式,并打开mark-info标记,因为一份没有标记内容的PDF/VCR-1文件,占位符没有东西可指。从那里开始,BeginPDFVCRTemplate接收字段列表和页面选择字段,它在设计数据schema之前就值得知道的方面相当严格。字段名要过PDFVCRValidFieldName,只接受ASCII字母、数字、下划线、连字符和句点,因为这些字符序列化成PDF name时没有转义歧义。PDFVCRNormalizeFieldList保持列表区分大小写,直接拒绝重复项,页面选择字段本身必须出现在声明的列表里
var
  Lib: TPDFlib;
  Diag: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.NewDocument;

    if Lib.SetPDFVCRMode(1) <> 1 then
      raise Exception.Create('PDF/VCR mode was refused');

    Lib.NewPage;
    if Lib.BeginPDFVCRTemplate('Salutation,FullName,AccountNo',
                               'AccountNo') <> 1 then
      raise Exception.Create('Field list rejected');

    // 一个占位符恰好绑定一个已声明字段。
    Lib.BeginPDFVCRPlaceholder('FullName', 72, 690, 320, 712);
    Lib.DrawText(72, 694, 'SAMPLE NAME');
    Lib.EndPDFVCRPlaceholder;

    Lib.EndPDFVCRTemplate;

    Diag := Lib.GetPDFVCRDiagnostics;
    if Diag <> '' then
    begin
      Writeln('PDF/VCR blockers: ', Diag);
      Exit;
    end;

    Lib.SaveToFile('campaign-template.pdf');
  finally
    Lib.Free;
  end;
end;注意成对结构给你换来什么。BeginPDFVCRPlaceholder在模板未激活或tag栈深度不是恰好一层时拒绝打开,PDFlibPas正是靠这个保证占位符是模板根的直接子节点、永远不会彼此嵌套。坐标也做校验,拒绝NaN、无穷大和颠倒的矩形,所以坏边界框在调用时就失败,而不是一周后的preflight报告里
为什么占位符需要自己的MCID序列化路径?
因为PDF/VCR-1要/K是裸整数,而通用tagged PDF写入器不是这样序列化结构元素与内容之间的链接的。按ISO 32000-1 §14.6,结构元素通常通过两种方式引用标记内容:元素已通过/Pg标识页面时用直接MCID整数,或者通过显式命名页面的标记内容引用字典。一个为多种用途输出tagged内容的库倾向于统一用字典形式,因为它跨页面组合更好
PDFlibPas在这里选了窄选项而不是通用选项。SetCurrentStructElemDirectMCIDKid给当前结构元素打标记,只有带这个标记的元素把/K序列化为直接MCID、页面放在/Pg上;其他一切保持现有MCR字典路径不动。这是一个刻意的取舍,而且是值得大声说出来的那种:加一个profile不应该改变其他tagged文档本来就会产出的字节,所以profile得到自己的路径,而不是一个全局开关。每一份现有tagged文件的序列化保持不变,回归面只有新功能那么大
一次遍历,两个消费者
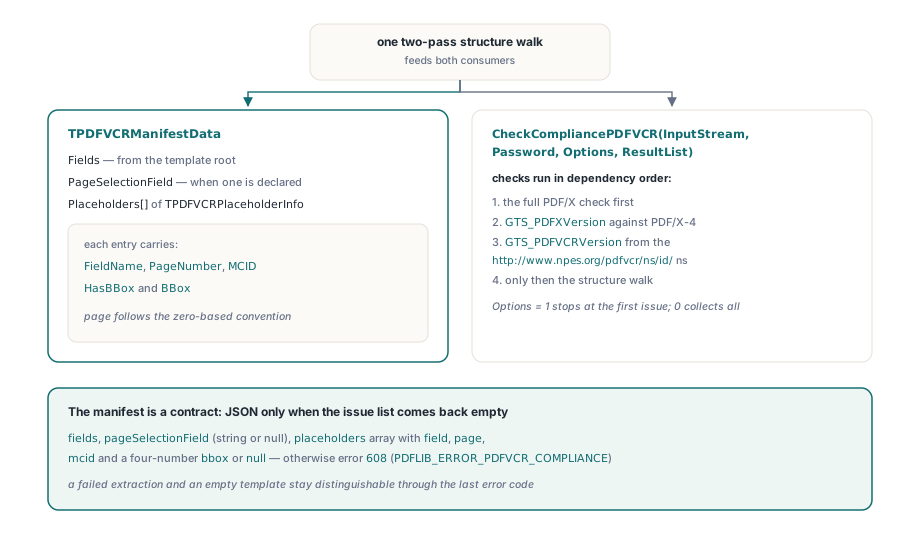
PDFlibPas从同一次两遍遍历推导出替换manifest和合规结论,这正是manifest可以作为作业计划被信任的原因。遍历在校验的同时填充一个TPDFVCRManifestData记录:来自模板根的Fields、声明了就用上的PageSelectionField,以及一组TPDFVCRPlaceholderInfo条目的Placeholders数组,条目携带FieldName、PageNumber、MCID、HasBBox和BBox。合规入口是CheckCompliancePDFVCR(InputStream, Password, Options, ResultList),它按依赖顺序跑检查而不是一拥而上:先完整PDF/X检查,再拿GTS_PDFXVersion对PDF/X-4,然后从http://www.npes.org/pdfvcr/ns/id/命名空间读GTS_PDFVCRVersion,最后才做结构遍历。把Options传1让它停在第一个问题,这是批量关卡里想要的;传0收集全部,这是报告里想要的
// 验证你收到的模板,而非自己生成的
var
  Issues: TStringList;
  Stream: TFileStream;
  I: Integer;
begin
  Issues := TStringList.Create;
  Stream := TFileStream.Create('supplier-template.pdf',
                               fmOpenRead or fmShareDenyWrite);
  try
    if CheckCompliancePDFVCR(Stream, '', 0, Issues) <> 100 then
      for I := 0 to Issues.Count - 1 do
        Writeln('PDF/VCR: ', Issues[I]);
  finally
    Stream.Free;
    Issues.Free;
  end;
end;
manifest是一份契约,所以它只对合规文件存在
BuildPDFVCRManifest只在问题列表为空时返回JSON,否则返回空字符串。这不是为了防御而防御的代码。manifest被合成引擎消费,引擎会用真实输出来驱动它,而把从带两个模板根的文件里提取的部分字段列表交回去,等于请引擎把不合规结构当成可信替换计划。通过文档API,GetPDFVCRManifest(InputFileName, Password)包装同一个调用,文件不合格时把最后的错误码设为PDFLIB_ERROR_PDFVCR_COMPLIANCE(608),这样提取失败和空模板可以区分。JSON报告fields、作为字符串或null的pageSelectionField,以及一个placeholders数组,条目给出field、page、mcid和四数bbox或null
var
  Lib: TPDFlib;
  Manifest: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Manifest := Lib.GetPDFVCRManifest('campaign-template.pdf', '');
    if Manifest = '' then
      // 608 表示文件不符合 PDF/VCR-1 规范,
      // 401 表示文件无法打开
      Writeln('No manifest, error ', Lib.LastErrorCode)
    else
      Writeln(Manifest);
  finally
    Lib.Free;
  end;
end;有一个细节要带进你的消费者:page值遵循库全局的零基页面约定,而不是人在查看器里看到的一基编号。把两者搞混是安静的差一错误,内容会落到错误的页上,而且任何校验器都抓不住它,因为两个数字结构上都合法
边界在哪里
PDFlibPas对PDF/VCR-1的支持覆盖模板编写、保存关卡、独立preflight和manifest提取。它不执行替换。把数据代入占位符、产出个性化实例是合成步骤,它刻意留在库外,因为manifest正是让合成引擎可以独立编写的接口。保存关卡也是拒绝而不是修复。有些profile里错误的注释标记可以被悄悄规范化,而PDFVCRReadyForSave强制的每条PDF/VCR-1约束都不一样,在这里猜一下就会改变文档的含义:凭空造一个模板根,或者替一个未绑定占位符挑选它属于哪个字段,产出的文件校验通过却在撒谎。同样的修复与拒绝分界线,PDF/E-1作者模式与有界preflight针对另一个profile讨论过,对同一份文档跑多项一致性检查的工作流见合规与签名工作台
编写、有界结构遍历、保存关卡和manifest提取器都随PDFlibPas Delphi PDF库发布,这意味着模板可以在profile下生成,然后通过一条从未见过写入器状态的独立代码路径验证,而这种分离正是合规声明还有价值的唯一原因