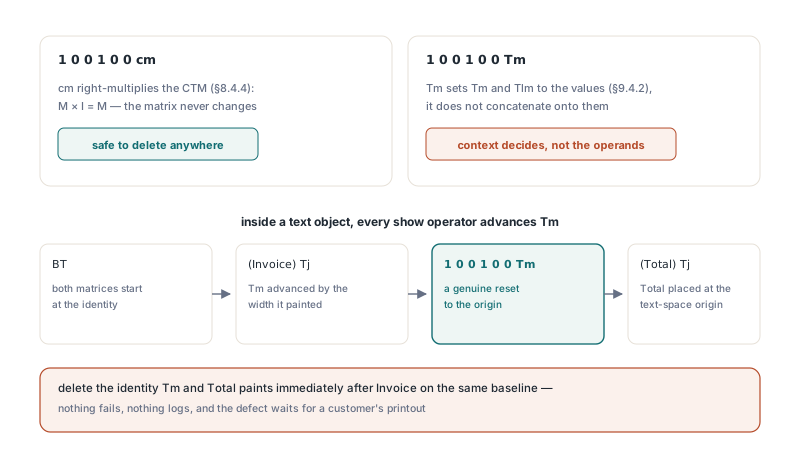
拿一个报表生成器可能写出的内容流 BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET,把 1 0 0 1 0 0 Tm 剥掉,因为它那六个数字拼出来的是单位矩阵。渲染结果里 "Total" 不再从文本空间原点开始,而是从 "Invoice" 结束的地方开始,在同一条基线上。单位 Tm 只在文本矩阵和文本行矩阵已经持有单位阵时才是多余的:紧跟 BT 之后,或紧跟另一个单位 Tm 之后
删除很诱人,因为同样这六个数字在 cm 面前确实是不折不扣的死重。把两个操作符一视同仁的内容流优化器能正确缩小大量流。然后它会撞上一个拿单位 Tm 当回车用的生成器,文字就动了
为什么 1 0 0 1 0 0 Tm 不总是空操作?
两个操作符做的算术不同。ISO 32000-1 §8.4.4 把 cm 定义为把操作数与当前变换矩阵级联;任何矩阵乘单位阵都得原矩阵,所以 1 0 0 1 0 0 cm 在任何位置都能删。Tm 是赋值。按 §9.4.2 它把文本矩阵和文本行矩阵都设成自己的操作数并丢弃它们原有的东西,所以它是否改变什么,完全取决于它前面的操作符
§9.4.1 说 BT 把两个矩阵都置为单位阵。从那里起,文本对象里几乎一切都会移动其中至少一个。Td、TD、T* 和非单位 Tm 重定位文本行矩阵。每个文字显示操作符(Tj、TJ、' 和 ")按刚绘制的字形宽度前进文本矩阵,后两个还先起一条新行。其中任何一个跑过之后,单位 Tm 就是一次真刀真枪的跳回原点。上面那张发票流依赖的正是这次跳跃
手工追踪一条流很快就有答案。把发票示例喂给 内容流 CTM 与文本矩阵状态跟踪器,记录显示 cm 向 CTM 级联而 Tm 整体覆盖两个文本矩阵——同样的操作数背后藏着两条不同的更新规则
PDF Library for Delphi 如何决定丢弃哪个单位 Tm
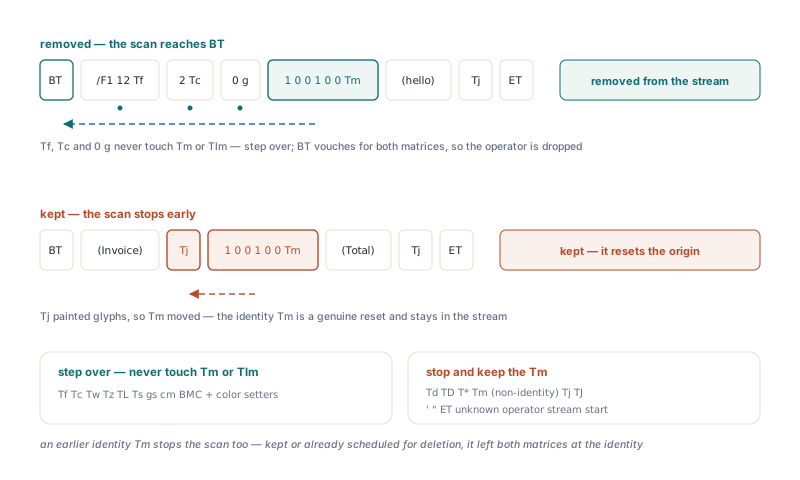
PDF Library for Delphi 在 peephole 遍里丢弃每个单位 cm,而对单位 Tm,只有当从该操作符向后扫描、在遇到任何可能动过文本矩阵的东西之前先碰到 BT 或另一个单位 Tm 时才丢弃。"单位"的判定是数值性的:操作符需要恰好六个数值操作数等于 1、0、0、1、0、0,所以 1.0 0 0 1.0 0 0 Tm 也算数。向后走时,扫描把遇到的每个操作符归入两组之一:
- 停下并保留 Tm:
Td、TD、T*、非单位Tm、Tj、TJ、'、"、ET、解析器不认识的任何操作符,或流的起点 - 跨步略过并继续扫:从不触碰文本矩阵或文本行矩阵的操作符,比如
Tf、Tc、颜色设置、gs、标记内容操作符、Do和cm
更早的单位 Tm 会让扫描以删除告终,无论优化器是保留它还是已把它排进删除队列。不管哪种,它都把两个矩阵留在了单位阵上,与 BT 留下的状态相同。这就是为什么 BT 之后连续三个单位 Tm 会缩成乌有
保守的停下点是刻意的。未知操作符可能是为所欲为的厂商扩展,扫描拒绝越过它推理。ET 之后没有打开的文本对象,坐在那里的单位 Tm 没有任何 BT 为矩阵值背书。扫描还一次只看一条内容流。这对 /Contents 是数组的页面很重要:PDF 允许文本对象在一条流里开始、在下一条流里继续,所以在文本对象中间打开、自己没有 BT 的图层,即便上一层会让它变得多余,它的单位 Tm 也保留
我们认为宁可错在这边。跨流边界跟踪矩阵、或模拟未知操作符,每个怪文件最多换回十四个字节的未压缩文本;弄错了,打印出来的发票上一个字形就挪了位。代价和风险不在一个量级上
有一个连带效应值得知道,因为它改变你在输出里看到的东西。同一遍还会移除内部空空如也的文本对象,所以 BT 1 0 0 1 0 0 Tm ET 消失得干干净净:单位 Tm 先走,它留下的 BT/ET 对是空的
在内容流片段上试跑优化器
优化器作用于同一个解析后的 TPDFContentProgram 模型——你按指令级编辑页面文字时用的就是它,见 字符到内容字节映射走查。这使得在对整份文档托付信任之前,先在一个字符串上试这条规则变得容易。下面的辅助函数解析一条已解码的流,跑 TPDFContentPeepholeOptimizer,然后每行一条指令地输出结果。在 Parse 之前设 CanonicalNumbers,与保存时的那遍一致——后者按固定精度重写每个数字
uses
  PDFlibContentModel, PDFlibContentOptimize;

function OptimizeSnippet(const Source: AnsiString): AnsiString;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
begin
  Result := Source;
  Prog := TPDFContentProgram.Create;
  try
    Prog.CanonicalNumbers := True; // 与保存时那遍相同的数字处理
    if not Prog.Parse(Source) then
      Exit; // 结构性重创:字节原样留着
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run; // 返回移除的指令数
    finally
      Optimizer.Free;
    end;
    Result := Prog.Emit; // 每行一条指令,以 #10 分隔
  finally
    Prog.Free;
  end;
end;

// 被移除:紧跟 BT 的 Tm,以及连续两个单位 Tm 中的第二个
//   OptimizeSnippet('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET')
// 保留:Td 之后的 Tm、Tj 之后的 Tm、非单位 Tm 之后的 Tm,或 BT 之外的 Tm
//   OptimizeSnippet('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET')
把发票流喂进去,单位 Tm 活下来,因为向后扫描远在碰到 BT 之前就撞上了 Tj。在 BT 和单位 Tm 之间放上 /F1 12 Tf、2 Tc 和 0 g,它照样被删,因为那些都不碰文本矩阵。有趣的是 BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm:恰好只丢一个操作符。第一个单位 Tm 撤销了 Td 的移动,只有第二个是多余的
Parse 只在重创时返回 False,比如未闭合的字符串或字典。未知操作符解析无碍、留在程序里,在那里充当扫描的硬停止点
peephole 优化器究竟什么时候运行?
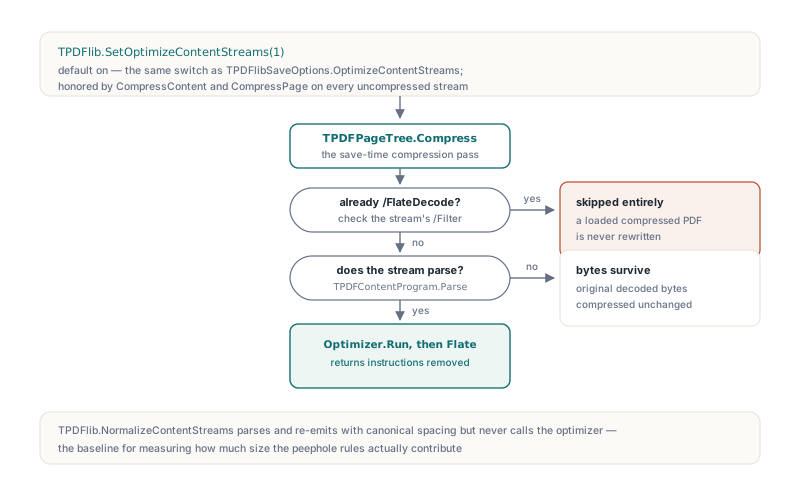
优化器只在压缩遍里运行,且只作用于尚未 Flate 压缩的页面内容流。TPDFlib.SetOptimizeContentStreams(1) 是默认值,同一开关也以 OptimizeContentStreams 字段出现在 TPDFlibSaveOptions 里;CompressContent 和 CompressPage 都遵循它。/Filter 已经是 /FlateDecode 的流整体跳过,所以加载一份典型已压缩的 PDF 再保存,它的操作符分毫不动。未压缩存储的流被解码、优化、然后 Flate 压缩。流解析失败时,其原始解码字节按原样压缩
var
  Lib: TPDFlib;
  Options: TPDFlibSaveOptions;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('report.pdf', '') <> 1 then
      Exit;
    // 未压缩页面流先过 peephole 规则,再 Flate
    Lib.SetOptimizeContentStreams(1);
    Lib.CompressContent;
    Lib.SaveToFile('report-optimized.pdf');

    // 经打包的保存选项做同样的选择;False 表示退出
    Options.CompressContent := True;
    Options.CompressFonts := True;
    Options.CompressImages := True;
    Options.Linearize := False;
    Options.KeepModDate := False;
    Options.OptimizeContentStreams := False;
    Options.GarbageCollect := False;
    Options.PackObjectStreams := True;
    Lib.SaveToFileOptions('report-plain.pdf', Options);
  finally
    Lib.Free;
  end;
end;
默认值留着别关。这一遍里的每个变换都是输出等价的,而单位矩阵规则针对的是许多生成器都会输出的模式——用 BT 1 0 0 1 0 0 Tm 打开每个文本对象。把它关掉主要在两种时候有意义:你想拿自己的未压缩输出跟自己写的内容做 diff,或者你需要一个基线。要那个基线,TPDFlib.NormalizeContentStreams 用规范化的间距和数字解析并重新输出内容,但从不调用优化器,于是归一化保存与优化保存之间的体积差就是 peephole 规则贡献的部分。与 配合字体子集化的 PDF 文件体积优化 里那些更大的收益相比,预期它是温和的
覆盖一种形态的测试定义不了规则
把 BT 1 0 0 1 0 0 Tm (hello) Tj ET 喂给优化器、断言不再有 Tm 的测试,只钉住一种形态:紧跟 BT 的单位 Tm 会被移除。它对 Td 之后、显示文字之后的单位 Tm 什么都没说。把这一条断言读成"单位 Tm 总是可移除"是个容易犯的错误,而且代价高昂,因为无论正确答案如何这个样本都能通过。任何这类规则的测试,都需要把保留形态与可移除形态并排写下来
下面的辅助函数统计存活下来的 Tm 操作符,然后对着一张输入表检查。把 ExpectTm 换成你测试框架的断言;它不属于库
uses
  SysUtils, PDFlibContentModel, PDFlibContentOps, PDFlibContentOptimize;

function TmCountAfterOptimize(const Source: AnsiString): Integer;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
  I: Integer;
begin
  Result := -1; // -1 表示解析失败
  Prog := TPDFContentProgram.Create;
  try
    if not Prog.Parse(Source) then
      Exit;
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run;
    finally
      Optimizer.Free;
    end;
    Result := 0;
    for I := 0 to Prog.Count - 1 do
      if Prog[I].Op = coTextMatrix then
        Inc(Result);
  finally
    Prog.Free;
  end;
end;

// 你自己的检查辅助,这里仅作示意;换成真正的断言
procedure ExpectTm(const Source: AnsiString; Expected: Integer);
var
  Actual: Integer;
begin
  Actual := TmCountAfterOptimize(Source);
  if Actual <> Expected then
    raise Exception.CreateFmt('%s: expected %d Tm, got %d',
      [string(Source), Expected, Actual]);
end;

procedure CheckIdentityTmRule;
begin
  // 可移除的形态
  ExpectTm('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET', 0);
  ExpectTm('BT 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  ExpectTm('BT /F1 12 Tf 2 Tc 0 g 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  // 必须保留单位 Tm 的形态
  ExpectTm('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET', 1);
  ExpectTm('BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 1);
  ExpectTm('BT 2 0 0 2 5 5 Tm (a) Tj 1 0 0 1 0 0 Tm (b) Tj ET', 2);
  ExpectTm('1 0 0 1 0 0 Tm (a) Tj', 1);    // 没有包住的 BT
  ExpectTm('BT ET 1 0 0 1 0 0 Tm', 1);     // 在 ET 之后
end;
最后两行看着傻,直到你想起分层的 /Contents 数组产出的恰恰就是这些碎片。从文本对象中间开始的流没有 BT,ET 之后的单位 Tm 不属于任何文本对象。两个都保留。末行的空 BT ET 对被空文本对象规则移除,所以计数检查的是 Tm 操作符而不是比较整条字符串
这条规则放弃的是文本对象中间偶发的单位 Tm,在 Flate 看到它们之前每页几个字节。换来的是优化器设计所立足的保证:这一遍里没有任何变换改变可见页面。一个会挪动文字的体积优化器,就是一个压缩比不错的渲染 bug
如果你在 Delphi 或 C++Builder 里生成或后处理 PDF 内容,PDF Library for Delphi and C++Builder 随库提供内容流解析器、这一 peephole 遍和上面展示的保存选项,外加用于产出干净、未优化基线以供对照的 NormalizeContentStreams