v3.539.24 之前,PDF Library for Delphi 的 Free Pascal 构建按 64 KB 分块压缩大流,每个分块都带上自己的 zlib 头和校验和,于是一个 1 MiB 的附件变成了十六个首尾相接的 zlib 成员。ISO 32000-1 的 FlateDecode 期望的恰好是一条 zlib 流,标准解码器停在第一个流结束标记上,也就是说头 65,536 字节之后的一切都被无声地丢掉了。修法是让 DeflateStream 和 InflateStream 在所有分块之间保住同一个 zlib 状态
这个 bug 只存在于单元的 FPC 一侧,而且只在分块流式路径上——这也正是它能活下来的原因:Delphi 分支从来都是对的,基于字符串的辅助函数从来都是对的,小尺寸的测试数据又根本走不到分块代码。它是五个被 Delphi 长期掩盖的 FPC 移植缺陷的近亲,只不过这一次 Delphi 构建并没有替谁打掩护:FPC 分支只是照着一个关于「zlib 流是什么」的错误心智模型写出来的
为什么分块写的 zlib 流会被其他 PDF 阅读器截断?
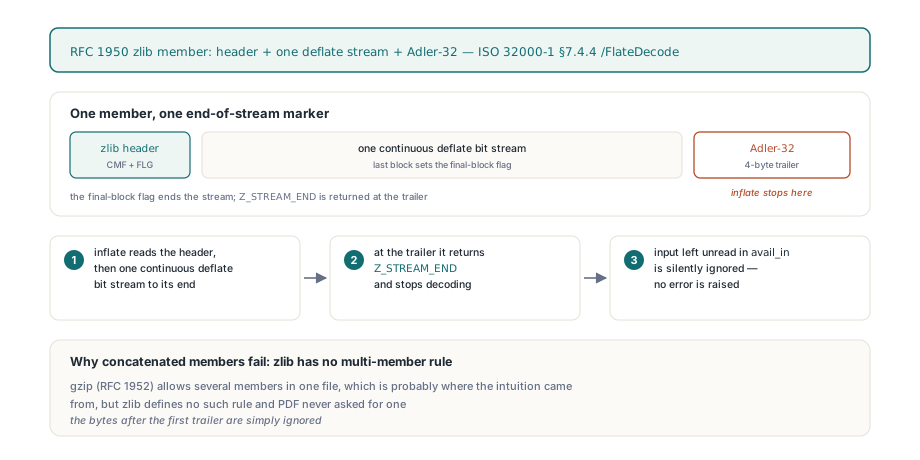
因为 RFC 1950 定义的 zlib 流是一个容器,不是一串容器,守规矩的 inflater 把第一个 Adler-32 trailer 当作数据的终点。这个格式是:两字节头,一段连续的 RFC 1951 deflate 位流(最后一个块带 final-block 标志),再加一个对全部未压缩字节算出的四字节 Adler-32 校验和。ISO 32000-1 §7.4.4 正是用这些术语定义 /FlateDecode 的。当 inflate 走到 trailer 时,它返回 Z_STREAM_END,把剩余输入原封不动留在 avail_in 里。从它的视角看什么问题都没有,所以它不报错,trailer 之后的字节就被直接忽略了。拼接成员在 gzip 里是合法概念(RFC 1952 允许一个文件里有多个成员),这个直觉多半是从那儿来的,但 zlib 没有这条规则,PDF 也从来没有要求过
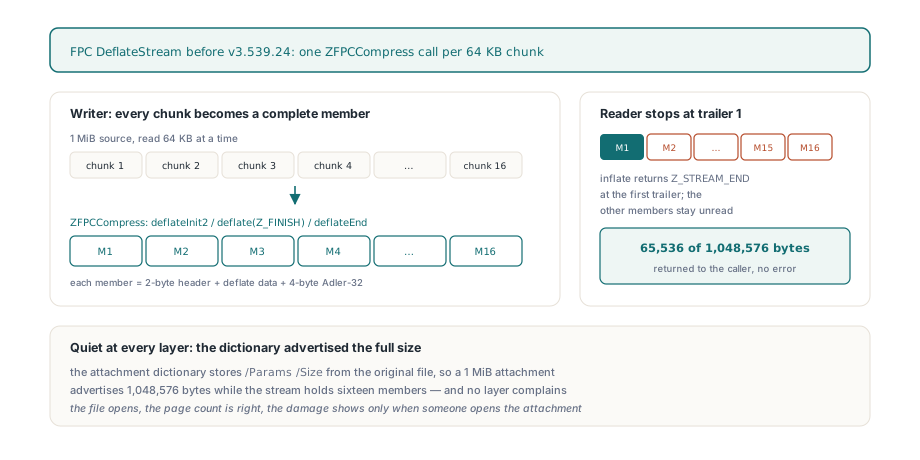
旧的 FPC DeflateStream 每次 64 KB 地读源,把每个分块交给 ZFPCCompress——一个自己跑 deflateInit2、用 Z_FINISH 压缩、再调 deflateEnd 的辅助函数。于是每个分块出来都是一条完整、合法、自终止的 zlib 流,函数再把它们拼进一个 AnsiString 写出去。结果看起来像 Flate 数据,头是对的,解码也不报错,但它只解出头 65,536 字节。读取一侧的 InflateStream 有镜像版的缺陷:每 64 KB 压缩输入调一次 ZFPCInflate,而每次调用都重新 inflateInit2。第二个分块从一条 deflate 位流的中间开始、没有 zlib 头,新的 inflater 直接拒绝它,于是来自任何其他生成器的完全正常的单成员流,也只有它头 64 KB 压缩字节能覆盖的部分被解了出来
// v3.539.24 之前的 FPC DeflateStream(简化):
// ZFPCCompress 会做 deflateInit2 / deflate(Z_FINISH) / deflateEnd,
// 所以每个 64 KB 分块都变成一个独立的 zlib 成员
Repeat
  ReadCount:= Source.Read(Input[1], ChunkSize);
  If (ReadCount> 0) Then
    Compressed:= Compressed+ ZFPCCompress(Copy(Input, 1, ReadCount), 6, False);
Until (ReadCount< ChunkSize);
If (Compressed<> '') Then
  Target.WriteBuffer(PAnsiChar(Compressed)^, Length(Compressed));
PDF Library for Delphi 里哪些调用会走到分块路径?
在 FPC 上,任何 1 MiB 以上的嵌入文件都会被写错,任何通过流式 API 抽取的 Flate 流只要压缩尺寸超过一个分块就会被读错。TPDFStream.ReadFromStream 决定如何编码进来的数据:Deflate 为真且 Stream.Size >= 1048576 时,它经由 DeflateStream 流式处理;低于这个阈值时,它把整个源读进内存并调用 DeflateStr——那个从未受影响的一次性辅助函数。ASCII85 加 Flate 的过滤器链跳过尺寸测试、永远走 DeflateStream,所以在这条路径上任何超过 64 KB 的负载早已被拆成多个成员。开着压缩把数据喂给 ReadFromStream 的公开入口是嵌入文件写入器:
TPDFlib.EmbedFile和TPDFlib.AddEmbeddedFile,它们把磁盘上的文件读进/EmbeddedFile流TPDFlib.AddAssociatedFileFromStream和TPDFlib.AddAssociatedFileFromFile,用于电子发票 XML 等源数据的 PDF/A-3 关联文件写入器- 读取一侧的
TPDFlib.GetEmbeddedFileContentToStream和GetEmbeddedFileContentToFile,它们经TPDFStream.WriteDecodedToStream再经InflateStream解码
每一层的失败都是安静的。写入器保存 /Params /Size 和一个从原始文件算出的 MD5 /CheckSum,于是附件字典宣告的是完整尺寸,而流里装着十六个成员。同一份库的 Delphi 构建去读这个文件,会在第一个 Z_STREAM_END 处干净利落地停下,恰好返回 65,536 字节。GetEmbeddedFileContentToStream 返回 1,因为它报告的是解码有没有出错,而不是输出是否与 /Size 一致。追过 GB 级 PDF 的合并与拆分这类大文档问题的人都见过这个套路:文件能打开,页数也正确,损害只在有人打开附件时才现形
所有分块共用一个 deflate 状态
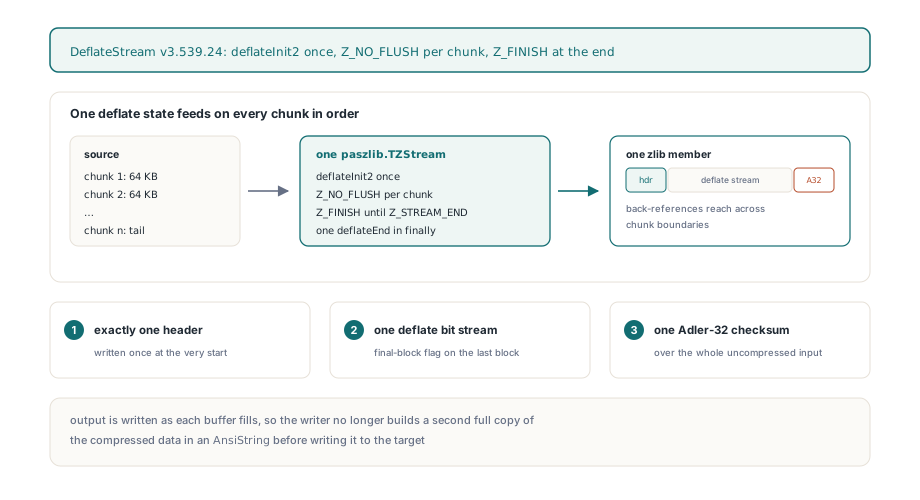
修好的 DeflateStream(在 PDFlibZLib.pas 里)初始化一个 paszlib.TZStream,把每个分块带着 Z_NO_FLUSH 喂给 deflate,直到最后才用 Z_FINISH 排空压缩器,直到它返回 Z_STREAM_END。这样产出的恰好是一个头、一段 back-reference 可以跨过分块边界的连续 deflate 位流,以及对整个输入算出的一个 Adler-32。FPC 分支现在拥有 Delphi 分支一直以来的那种结构。它还边产出边写出,而不是先把整个压缩结果拼进一个 AnsiString,所以写入器不再在把数据拷给目标之前先在内存里造出压缩数据的第二份完整副本
// v3.539.24 起的 FPC DeflateStream(错误处理路径已省略)
If (deflateInit2(strm, Level, Z_DEFLATED, 15, 8, Z_DEFAULT_STRATEGY)<> Z_OK) Then
  Exit;
Try
  Repeat
    ReadCount:= Source.Read(Input[0], ChunkSize);
    If (ReadCount> 0) Then
    Begin
      strm.next_in:= Pointer(Input);
      strm.avail_in:= ReadCount;
      While (strm.avail_in> 0) Do
      Begin
        strm.next_out:= Pointer(Output);
        strm.avail_out:= ChunkSize;
        Status:= deflate(strm, Z_NO_FLUSH);   // 同一个状态,不在此切断成员
        Produced:= ChunkSize- strm.avail_out;
        If (Produced> 0) Then
          Target.WriteBuffer(Output[0], Produced);
        If (Status<> Z_OK) Then
          Break;
      End;
    End;
  Until (ReadCount< ChunkSize);
  Repeat                                    // 整个输入只有一个 trailer
    strm.next_out:= Pointer(Output);
    strm.avail_out:= ChunkSize;
    Status:= deflate(strm, Z_FINISH);
    Produced:= ChunkSize- strm.avail_out;
    If (Produced> 0) Then
      Target.WriteBuffer(Output[0], Produced);
  Until (Status= Z_STREAM_END);
Finally
  deflateEnd(strm);
End;
InflateStream 得到了对称的重写:一个 inflateInit2,一个在当前分块耗尽且输出缓冲不再满时持续调用 inflate 的内层循环,以及在 Z_STREAM_END 处停止。有一个副作用值得知道:旧的分块写入器把级别硬编码成 6,新实现尊重 PLDeflateLevel,所以通过 TPDFlib.SetCompressionLevel(1..9) 设定的级别现在在 FPC 上也能作用到大型嵌入文件。如果你已经在按在 Delphi 中减小 PDF 文件体积的思路为归档输出调压缩,这一点对你有用
怎么验证一条 Flate 流是单个 zlib 成员?
用一个普通的 zlib 解码器去 inflate,返回 Z_STREAM_END 时检查两件事:解码出的长度等于源长度,且 avail_in 为零。结束标记之后还剩输入,就是拼接流的签名。修复就是这样验证的:200 KB 测试数据横跨四个 64 KB 分块,经新的 DeflateStream 压缩后得到一个 534 字节的单条 zlib 流,一个现成的 zlib 解码器收回了全部 200,000 字节且无剩余输入,同一项检查在 i386 交叉编译的 FPC 目标上也通过了。下面的例程就是这个检查的 FPC 版本,直接构建在 paszlib 上,因此不信任被测代码本身
uses Classes, SysUtils, paszlib, PDFlibZLib;

function IsSingleZlibMember(Packed: TMemoryStream; out Decoded: Int64): Boolean;
var
  strm: TZStream;
  Buf: array[0..65535] of Byte;
  Status: Integer;
begin
  Result:= False;
  Decoded:= 0;
  FillChar(strm, SizeOf(strm), 0);
  if inflateInit2(strm, 15) <> Z_OK then
    Exit;
  try
    strm.next_in:= Packed.Memory;
    strm.avail_in:= Cardinal(Packed.Size);
    repeat
      strm.next_out:= @Buf;
      strm.avail_out:= SizeOf(Buf);
      Status:= inflate(strm, Z_NO_FLUSH);
    until Status <> Z_OK;
    Decoded:= strm.total_out;
    // 单个成员恰好终止在最后一个输入字节上
    Result:= (Status = Z_STREAM_END) and (strm.avail_in = 0);
  finally
    inflateEnd(strm);
  end;
end;

// 用默认 64 KB 分块把 200,000 字节灌进 DeflateStream
// 并要求只有一个成员,且能解码回完整长度
Source.Position:= 0;
DeflateStream(Source, Packed);
if not (IsSingleZlibMember(Packed, Decoded) and (Decoded = Source.Size)) then
  raise Exception.Create('DeflateStream produced more than one zlib member');
在应用层,有用的断言是库不会替你做的那一个:把附件解出来的内容与写入时记录的 /Params /Size 比一比。tag 为 5 的 GetEmbeddedFileIntProperty 返回那个记录的尺寸,嵌入文件索引从 1 开始计数,而负载至少要 1 MiB 才会走流式路径。在你随库交付的每一个编译器上都跑一遍同样的测试,因为原始缺陷在 Delphi 上是通过的、只在 FPC 上才失败
procedure CheckLargeAttachmentRoundTrip(const PayloadFile, OutFile: string);
var
  PDF: TPDFlib;
  Extracted: TMemoryStream;
  I, Declared: Integer;
begin
  PDF:= TPDFlib.Create;
  try
    PDF.NewDocument;
    PDF.AddStandardFont(4);
    PDF.DrawText(80, 100, 'Large attachment round trip');
    // 1 MiB 以上会走 ReadFromStream 里的分块 DeflateStream 路径
    if PDF.EmbedFile('Payload', PayloadFile, 'application/octet-stream') <> 1 then
      raise Exception.Create('EmbedFile failed');
    if PDF.SaveToFile(OutFile) <> 1 then
      raise Exception.Create('SaveToFile failed');
  finally
    PDF.Free;
  end;

  PDF:= TPDFlib.Create;
  Extracted:= TMemoryStream.Create;
  try
    if PDF.LoadFromFile(OutFile, '') = 0 then
      raise Exception.Create('LoadFromFile failed');
    for I:= 1 to PDF.EmbeddedFileCount do
    begin
      Extracted.Clear;
      if PDF.GetEmbeddedFileContentToStream(I, Extracted) <> 1 then
        raise Exception.CreateFmt('Attachment %d could not be decoded', [I]);
      Declared:= PDF.GetEmbeddedFileIntProperty(I, 5);   // /Params /Size
      if Extracted.Size <> Declared then
        raise Exception.CreateFmt('Attachment %d truncated: %d of %d bytes',
          [I, Extracted.Size, Declared]);
    end;
  finally
    Extracted.Free;
    PDF.Free;
  end;
end;
这次修复没有改什么?
FPC 分支保留它宽松的解码规则,也不会去修早先 FPC 构建已经写出的文件。到达 MaxOutput 时,FPC 的 InflateStream 在限制处截断并返回,而 Delphi 分支抛 ERangeError;当 inflate 报告数据错误时,FPC 仍然接受部分解码的输出,因为有些 PDF 生成器写出的流本来就是截断的或校验和损坏的。由 v3.539.24 之前的 FPC 构建写出的 PDF 仍含有拼接成员,而修正后的读取器和其他所有读取器一样在第一个 Z_STREAM_END 处停下。不要试图在库内部把这样的流解码再重编码来治愈它,那只会把 64 KB 截断变成永久的;正确做法是从原始来源重新嵌入附件。FPC 循环也仍然在第一次读不满一个分块时结束——这对 TFileStream 和 TMemoryStream 这类流来说等于数据结束信号,所以传给 AddAssociatedFileFromStream 的自定义 TStream 最稳妥的做法是先拷进一个 TMemoryStream。Delphi 分支、DeflateStr 和 InflateStr 辅助函数、以及普通 Flate 路径上小于 1 MiB 的每一条流,行为都与从前完全一致
修正后的 FPC DeflateStream 和 InflateStream 随 PDF Library for Delphi v3.539.24 发布,它从同一份源码树同时面向 Delphi、C++Builder 和 Free Pascal,大型附件从 FPC 构建里出来现在应当逐字节复原,正如它一直以来在 Delphi 里那样