设想一份文件,信息字典写着 /Title (Annual Maintenance Report),而它的 XMP 包里根本没有 dc:title。阅读器毫无怨言地显示标题,PDF/A 校验器却拒收这份文件,因为两份元数据对不上。另一份文件看起来同样健康,但 XMP 里没有 pdfaid:part 条目,校验器的回答是几十条错误:它把文件当普通 PDF 判定,把所声称子集的每条规则都报为失败——全部源于缺失的一行
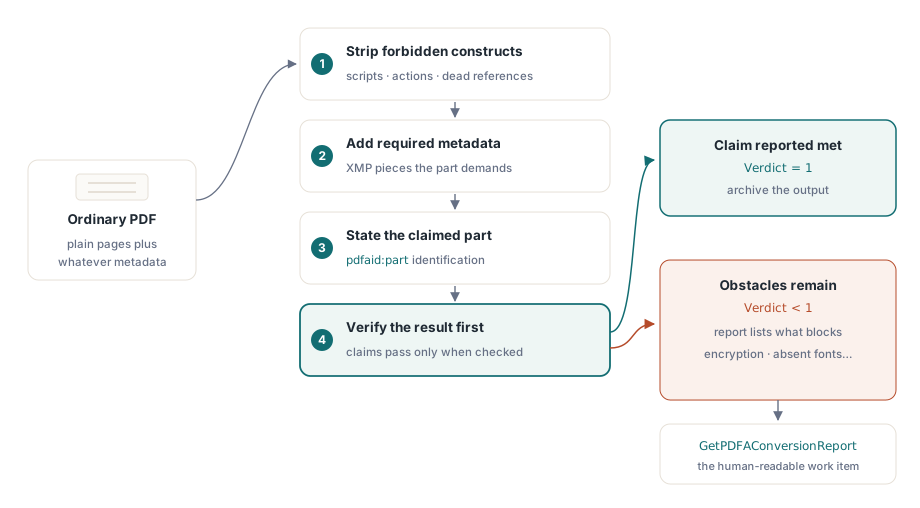
这两个问题需要的工作量天差地别。调和元数据是一个窄修复,任何文件都能跑。把任意的 PDF 变成归档级的,意味着剥掉目标子集禁止的、补上要求的、声明所声称的子集,然后校验实际产出的那些字节。我们刻意把转换围绕最后一步构建。ConvertToPDFA(随 Enterprise 版 TPDFlibEnterprise 交付,连同 GetPDFAConversionReport)把转换后的文档存进内存,对那些字节跑 PDF/A 检查,只有检查通过才返回 1
打开一切正常的 PDF 为什么过不了 PDF/A 检查?
两种失败都来自元数据规则。PDF 在文档信息字典里记录标题、作者、生成器和日期,PDF/A 还要求同样的事实出现在 XMP 元数据包里;ISO 19005-1 §6.7.3 要求两者等价,PDF/A-2 和 PDF/A-3 保留这条规则。在这条规则上翻车的文件里,常见的样子是生成器填了信息字典、却从没写 XMP 那一半,于是校验器在一处找到标题、在另一处一无所获
缺失的标识更安静。pdfaid:part 和 pdfaid:conformance 条目是标记一份文件为 PDF/A 的东西,没有它们文件照样完全良构。我们最常见到的情况是应用自带 XMP 包、替换了 PDF 写入器生成的那个;自定义包带着应用自己的字段、没有任何 pdfaid 条目,于是错误列表指向离真正原因十万八千里的地方
RepairDocumentMetadata 两类都处理,返回它改动的条目数。它在所有版本中可用,SetPDFAMode 和 SanitizeDocument 也是。修复遍历 Title、Author、Subject、Keywords、Creator、Producer、CreationDate 和 ModDate。只有 XMP 带值时,信息字典从它填补,已记录的东西不会被扔掉;两边都有值且不同时,信息字典赢。我们这样定是因为信息字典是生成器最常设置的那一半,更有可能是作者意图的忠实记录
如果你的 XMP 才是权威副本(比如在文档管理系统里精心维护过),先用 SetInformation 把你要的值推进信息字典,然后再跑修复。反过来做,你精心维护的 XMP 标题会被原始生成器写的东西覆盖
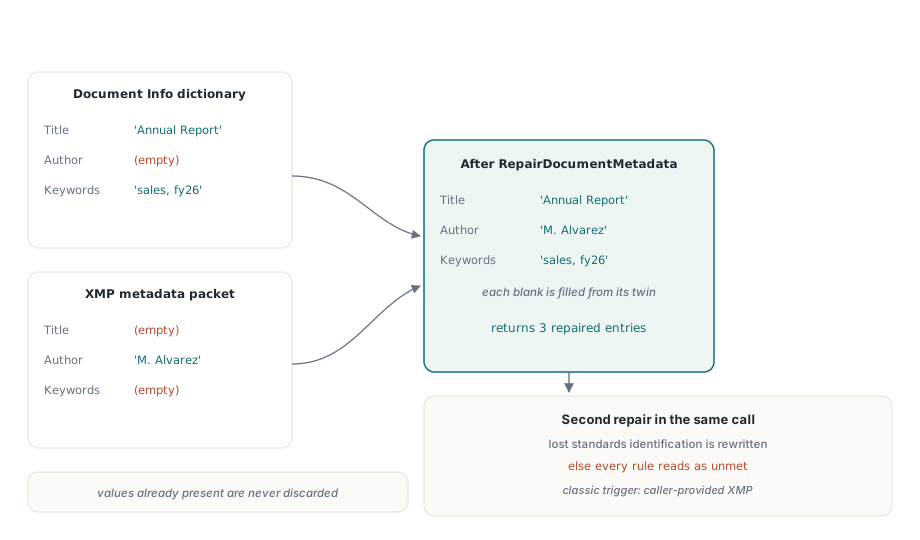
标识修复需要你做一件事:文档得知道自己瞄准哪个子集。新加载的文件没有设 PDF/A 模式,所以修复前先调 SetPDFAMode。模式就位后,RepairDocumentMetadata 写入匹配的 pdfaid 条目,为 part 4 模式补上 2020 年的 pdfaid:rev,并把 dc:format 设为 application/pdf——校验器也查这个
uses
  SysUtils, PDFlibrary;

procedure RepairIncoming(const InName, OutName: string);
var
  Lib: TPDFlib;
  Fixed: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      raise Exception.CreateFmt('Cannot open %s', [InName]);

    // 精心维护的标题先进信息字典,
    // 因为两半不一致时这份赢
    Lib.SetInformation(2, 'Annual Maintenance Report 2025');

    Lib.SetPDFAMode(3);                  // 3 = PDF/A-2b,见下表
    Fixed := Lib.RepairDocumentMetadata;
    Writeln(Format('%d metadata entries brought into agreement', [Fixed]));

    Lib.SaveToFile(OutName);
  finally
    Lib.Free;
  end;
end;
选择目标子集及其模式号
按文档必须承载什么来挑子集,然后再查号码。SetPDFAMode 和 ConvertToPDFA 共用一套编号,而它并不按子集名字暗示的顺序排列
| 模式 | 子集与级别 | 说明 |
|---|---|---|
| 1 | PDF/A-1a | PDF 1.4,带标签 |
| 2 | PDF/A-1b | PDF 1.4 |
| 3 | PDF/A-2b | PDF 1.7 |
| 4 | PDF/A-2a | PDF 1.7,带标签 |
| 5、6、7 | PDF/A-3b、3a、3u | 允许任意类型的嵌入文件 |
| 8 | PDF/A-2u | PDF 1.7,要求 Unicode 文本 |
| 9、10、11 | PDF/A-4、4e、4f | PDF 2.0;4e 增加 3D 与富媒体,4f 允许嵌入文件 |
模式 3 是 PDF/A-2b,模式 4 是 PDF/A-2a。这个倒置专门坑那些从 1a 数上来、以为 a 级永远在前的人。PDF/A-2u 出现在 8,排在 part 3 各模式之后
真正有后果的选择是附件。Part 1 和 2 禁止嵌入文件,所以 ConvertToPDFA 在模式 1 到 4 和模式 8 下移除它们。把一份 Factur-X 或 ZUGFeRD 发票转到模式 3?输出里结构化 XML 发票没了,连同这份文件存在的理由。凡带附件的,目标定在模式 5(PDF/A-3b)——那些发票格式正是定义在这个子集上——需要 PDF 2.0 就用模式 11。part 3 或 part 4 文件里的每个附件必须经 /AFRelationship 声明它与文档的关系,PDF Library for Delphi 在这些模式下为保存的每个嵌入文件写出该条目
Part 4 的自我标识不同。普通 PDF/A-4 没有合规字母,两个扩展用 E 或 F,并要求带其子集发布年份的 pdfaid:rev。ConvertToPDFA 在模式 9 到 11 把文件抬到 PDF 2.0,因为 ISO 19005-4 §6.1.2 把该子集构建在 PDF 2.0 上,检查也按 PDF 2.0 而不是 1.7 判定这类文件
ConvertToPDFA 在文件里改了什么
ConvertToPDFA 按固定顺序执行一串修复,把每一步记进纯文本报告,把结果存进内存并校验那些字节。检查失败返回 0;模式不在 1 到 11 也返回 0,那是在写任何报告之前就返回。这串顺序值得了解,因为每一步都是输出会失去或得到的东西:
- 密码未知的加密文档立即以一行
blocked:叫停转换;里面的东西什么都读不了,更谈不上修复 - 文档级 JavaScript 和运行它的 open action 被移除,连同每个附加动作条目和任何子集都不允许的动作类型,其中有 Launch、Sound、Movie、ResetForm、ImportData、Hide、SetOCGState、Rendition 和 Trans。GoTo 和 URI 链接保留,导航照常工作
- 对禁止嵌入文件的子集,嵌入文件被移除,如上所述
- 隐藏或设为永不显示的注释被删除。PDF/A 要求注释可见可打印,而显示它们会改变页面的样子,所以我们选择移除
- 表单字段外观在
/NeedAppearances标志被清除前重新生成,已填的值保持可见 - 用到但未嵌入的字体从本机安装的字体嵌入
- 不再被任何东西引用的对象被丢弃;文件没有 sRGB 输出意图时会补上一个
- 最后在 XMP 里声明子集与级别,然后校验字节
在服务器上,最可能让转换卡住的是字体那一步。文档用的字体在转换主机上无处可寻时,无法从文件内部修复,报告会如实说。把文档实际用到的字体装到转换机上;给现有 PDF 嵌入缺失字体的实操指南单独讲了这一步
批处理作业该如何应对一次失败的转换?
把返回值当闸门、把报告当工单。返回 1 的文件归档,其余连同报告转给一个人。不要因为失败转换的输出看起来比输入干净就把它存进归档。那份文件现在带着一个检查拒绝确认的 PDF/A 声明,这正是校验步骤存在要防止的局面
GetPDFAConversionReport 的报告每个动作一行,每行以动词开头:removed:、regenerated:、repaired:、embedded:、added:、stated:,加上叫停时出现的 blocked:,和收尾的一行 result:。裁决背后的检查在第一个失败处停止,所以文件失败时,转换会把检查完整重跑一遍,报告一次性列出所有问题。按前缀分流只要几行代码
uses
  Classes, SysUtils, PDFlibrary, PDFlibEnterprise;

function ArchiveOne(const InName, ArchiveDir, ReviewDir: string): Boolean;
var
  Lib: TPDFlibEnterprise;
  Report: TStringList;
  I: Integer;
  Blocked: Boolean;
begin
  Result := False;
  Lib := TPDFlibEnterprise.Create;
  Report := TStringList.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      Exit;
    Result := Lib.ConvertToPDFA(5) = 1;      // 5 = PDF/A-3b,保留附件
    Report.Text := Lib.GetPDFAConversionReport;
    if Result then
      Lib.SaveToFile(IncludeTrailingPathDelimiter(ArchiveDir) + ExtractFileName(InName))
    else
    begin
      Blocked := False;
      for I := 0 to Report.Count - 1 do
        if Pos('blocked:', Report[I]) = 1 then
          Blocked := True;
      // 原件保持不动;随行的只有报告
      Report.SaveToFile(IncludeTrailingPathDelimiter(ReviewDir) +
        ChangeFileExt(ExtractFileName(InName), '.pdfa-report.txt'));
      if Blocked then
        Writeln(InName, ': needs a password or a rebuilt source file');
    end;
  finally
    Report.Free;
    Lib.Free;
  end;
end;
blocked: 一行通常意味着解法在 PDF 之外:一个密码、另一份源文件、或重跑生成文档的那个东西。完整转换之后仍然剩下的普通校验问题,更多是承载着意义、不能一删了之的内容,那些才是必须由人来定夺的情形
读取文件已带有的 PDF/A 标记
转换之前,先查文档已经对自己做了什么声明。扫描仪、办公套件和其他 PDF 工具产出的文件常常已带 PDF/A 标记;把一份有效的 PDF/A-3 文件转成 part 2 会白白让它失去附件
坑在于 XMP 允许同一属性两种写法。有的生成器把子集写成子元素 <pdfaid:part>2</pdfaid:part>;有的写成 rdf:Description 上的属性 pdfaid:part="2"。两者都是普通的合法 XMP。只搜一种形式的探测器会判定另一族生成器的文件没有标记,这样建的检查器最终会拿 part 1 去判一份有效的 PDF/A-2 文件、报告它无标记且 PDF 版本过高——与事实恰好相反。PDF Library for Delphi 里的校验器两种形式都读。你要自己嗅探标记的话,也请这样做:
function DeclaredPDFAPart(Lib: TPDFlib): string;
const
  ElemTag = '<pdfaid:part>';
  AttrDQ  = 'pdfaid:part="';
  AttrSQ  = 'pdfaid:part=''';
var
  Packet: string;
  P: Integer;
begin
  Result := '';
  Packet := Lib.GetDocumentMetadata;
  P := Pos(ElemTag, Packet);                   // 元素形式
  if P > 0 then
    Exit(Copy(Packet, P + Length(ElemTag), 1));
  P := Pos(AttrDQ, Packet);                    // 属性形式,双引号
  if P = 0 then
    P := Pos(AttrSQ, Packet);                  // 属性形式,单引号
  if P > 0 then
    Result := Copy(Packet, P + Length(AttrDQ), 1);
end;
空结果意味着两种形式都没有标记。一个数字告诉你生成器想表达哪个子集,在决定是否转换之前,先拿它与你的目标比对
文件进归档前先做脚本净化
归档转换与安全净化通常一起跑,因为安全策略想清除的内容与 PDF/A 禁止的重合度很高。SanitizeDocument 接受 SANITIZE_* 标志的位掩码,返回执行了多少次移除。ConvertToPDFA 自己的第一步就是带 SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION 调它
有一个细节对校验器要紧。文档级脚本住在目录 /Names 字典下的 /JavaScript 名称树里,最后一个脚本被移除时,空了的树也一并移除。空树仍然宣告这份文档有脚本,有些检查器看见键就反应,根本不数键下还有什么
不管净化出自哪个工具,都用一次全新加载来校验保存后的文件,别信内存状态。重新打开很便宜:
var
  Lib, Check: TPDFlib;
begin
  Lib := TPDFlib.Create;
  Check := TPDFlib.Create;
  try
    Lib.LoadFromFile('upload.pdf', '');
    Lib.SanitizeDocument(SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION);
    Lib.SaveToFile('upload-clean.pdf');

    Check.LoadFromFile('upload-clean.pdf', '');
    if Check.GlobalJavaScriptCount > 0 then
      raise Exception.Create('Document-level scripts survived the save');
  finally
    Check.Free;
    Lib.Free;
  end;
end;归档流水线的相邻步骤见这些指南:PDF/A 与 PDF/UA 预检、真涂黑与内容移除,以及 面向 Factur-X 的 PDF/A-3 XMP 扩展模式——归档文档还要携带结构化发票数据时,元数据那边由它接手
这里展示的转换、元数据修复和校验全部跑在你自己的 Delphi、C++Builder 或 Lazarus 进程里,链路上没有外部转换器或命令行校验器。PDF Library for Delphi 产品页列出了 PDF/A 子集、版本与目标平台