PDF Library for Delphi(PDFlibPas)通过AddWebCaptureCommand把Web Capture命令元数据写进文档的catalog,填充ISO 32000-1 §14.10定义的/SpiderInfo字典。每条命令记录被抓取的URL、抓取向下钻了几层,以及一小撮标记位。它记录的是意图——它并不真正抓取任何东西
正是这个区别让这个API容易被误读。技术支持工程师递给你一份从某个厂商的在线文档拼出来的PDF,问你第40页是从哪来的。如果生成方填了/SpiderInfo,答案就摆在catalog里:一个URL、一个抓取深度,也许还有产生这一页的POST请求体。如果生成方没填,你把content stream翻烂了也找不出来。写这种溯源信息很便宜,结构上却相当繁琐,所以几乎总被跳过
Catalog /SpiderInfo字典到底记录了些什么?
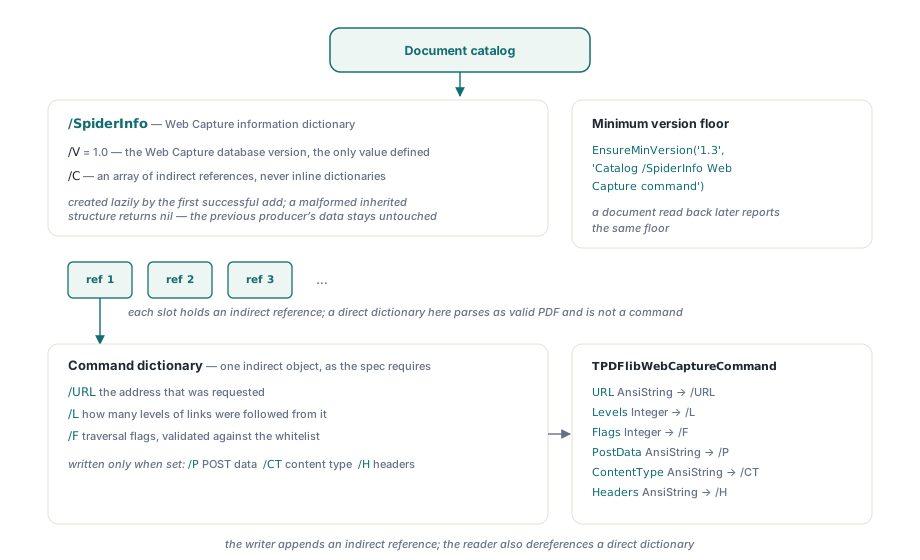
/SpiderInfo是挂在文档catalog上的Web Capture信息字典,里面装着PDF Library for Delphi关心的两样东西:/V,一个数值型的Web Capture数据库版本,库总是写成1.0;以及/C,一个命令字典数组。这个版本号不是PDF版本——它标识的是Web Capture数据模型本身,而1.0是ISO 32000-1 §14.10定义的唯一取值。真正有意思的东西都在/C里。每条命令字典携带/URL(被请求的地址)、/L(从它出发跟了几层链接)和/F(遍历标记)。当请求不是普通的GET时,还有三个可选键描述请求本身:/P放POST数据、/CT放那部分数据的content type、/H放附加请求头。PDF Library for Delphi把六个键全部映射到一个记录TPDFlibWebCaptureCommand上,字段是URL、Levels、Flags、PostData、ContentType和Headers,除了两个Integer计数器外全是AnsiString。/SpiderInfo的存在还会抬高文档的最低版本:AddWebCaptureCommand调用EnsureMinVersion('1.3', 'Catalog /SpiderInfo Web Capture command'),而PDF Library for Delphi里的版本检测规则注册了对应的PDF 1.3规则,之后回读文档时报告同样的下限
为什么Web Capture命令必须是间接对象?
唯一会绊倒人的结构性规则是:命令字典在进/C之前必须注册为间接对象,因为ISO 32000-1 §14.10规定/C是指向命令字典的间接引用数组,不是字典数组。把直接字典塞进这个数组,得到的东西能解析成合法PDF,作为Web Capture记录却毫无意义——查看器或归档工具顺着命令列表走,在应该是引用的地方发现一个内联对象,这一条就不是命令。PDF Library for Delphi在AddWebCaptureCommand内部处理这件事:它先构建字典,交给OnNewIndObj拿到对象号和代代号,把这一对包装成间接引用,再把引用追加进数组。如果OnNewIndObj没能给出正的对象号,函数返回0,数组保持原样。规范坚持间接性的原因是单条命令可以被共享——同一次抓取可以在Web Capture结构的多处被引用——而PDF里可共享的对象,按定义就是间接对象
怎么在Delphi里加一条Web Capture命令?
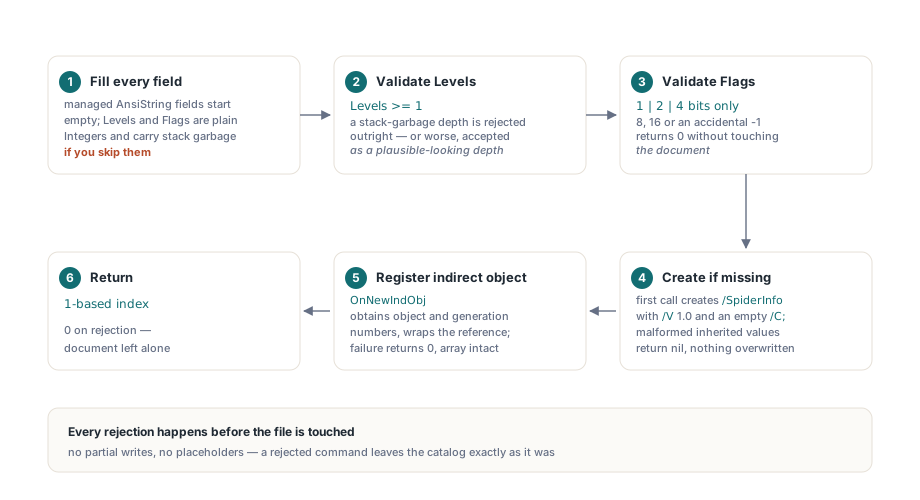
把记录填完整,然后调用AddWebCaptureCommand,它返回新命令的1-based下标,校验不过就返回0。在这里完整性比平时更关键。Delphi会把局部记录里受管理的AnsiString字段初始化为空,但Integer字段——Levels和Flags——没有这种待遇,所以你忘了填的记录会带着栈上的残留值出场。AddWebCaptureCommand要求Levels至少为1、Flags非负,而一个栈残留值要么直接被拒,更糟的是被当作看似合理的深度悄悄收下
var
  Lib: TPDFlib;
  Command: TPDFlibWebCaptureCommand;
  Index: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('captured-site.pdf', '') = 1 then
    begin
      // 逐个字段赋值:Levels 和 Flags 是普通整数,
      // 跳过它们就会携带栈上的垃圾数据。
      Command.URL := 'https://example.com/docs/index.html';
      Command.Levels := 2;
      Command.Flags := PDF_WEB_CAPTURE_SAME_SITE or PDF_WEB_CAPTURE_SAME_PATH;
      Command.PostData := '';
      Command.ContentType := '';
      Command.Headers := '';

      // 返回新的 1-based 命令索引,被拒绝时返回 0。
      Index := Lib.AddWebCaptureCommand(Command);
      if Index = 0 then
        raise Exception.Create('Web Capture command rejected');

      Lib.SaveToFile('captured-site.pdf');
    end;
  finally
    Lib.Free;
  end;
end;第一次成功的调用同时也是创建结构的地方。AddWebCaptureCommand向内部的WebCaptureCommands(True)助手要命令数组,这个助手只在缺少时才会创建带/V条目的/SpiderInfo和随后的空/C数组。它对已有的东西刻意保守:如果catalog里已经有/SpiderInfo键但值不是字典,或者/C键但值不是数组,助手返回nil而不是覆盖现有对象。一个格式错误的继承结构只会让添加失败,不会让PDF Library for Delphi毁掉前一个生成方写的东西
标记白名单:三个已定义位,别的都不行
AddWebCaptureCommand按白名单校验Flags,只要在PDF Library for Delphi定义的三个常量之外置了任何位就拒绝:PDF_WEB_CAPTURE_SAME_SITE = 1(只跟留在同一站点的链接)、PDF_WEB_CAPTURE_SAME_PATH = 2(只跟同一路径下的链接)、PDF_WEB_CAPTURE_SUBMIT = 4(这个请求是表单提交而不是普通取回)。传8、16,或者不小心传个-1,调用直接返回0,文档动都不动
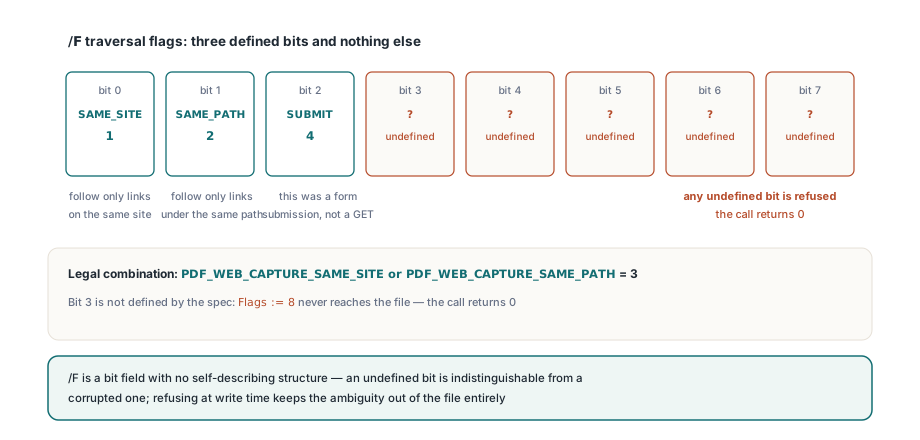
这比PDF解析器通常的做法更严格,而且是故意的。/F是一个没有自描述结构的位域,未定义位与损坏位无法区分,之后把值读回去的消费者也没法分辨是未来扩展还是手滑打错。在写入时拒绝,歧义就被完全挡在文件外面。另外注意,/P、/CT和/H只在对应记录字段非空时才写出,所以一次普通GET产生的是三键命令字典——/URL、/L、/F——没有空字符串占位符碍眼,这也是解析文件的读取方对无请求体请求的预期
// 一次表单提交:POST 请求体加上其内容类型。
Command.URL := 'https://example.com/search';
Command.Levels := 1;
Command.Flags := PDF_WEB_CAPTURE_SUBMIT;          // 4
Command.PostData := 'q=iso32000&scope=all';
Command.ContentType := 'application/x-www-form-urlencoded';
Command.Headers := 'Accept-Language: en-US';
if Lib.AddWebCaptureCommand(Command) = 0 then
  raise Exception.Create('submission command rejected');

// 同站加同路径是合法组合:1 或 2 = 3。
Command.Flags := PDF_WEB_CAPTURE_SAME_SITE or PDF_WEB_CAPTURE_SAME_PATH;

// Bit 3 规范未定义,所以这一位永远不会写入文件。
Command.Flags := 8;
if Lib.AddWebCaptureCommand(Command) <> 0 then
  raise Exception.Create('undefined flag bit should have been refused');
把命令读回来:一个键,两种合法表示
GetWebCaptureCommand成功返回1,否则返回0,它必须比写入方更宽容,因为它读的是别的生成方写的文件。两处不对称值得注意。第一,读取方接受间接引用或直接字典形式的命令条目,需要时就解引用——PDF Library for Delphi总是写规范要求的间接形式,但拒绝读一个粗糙的文件对谁都没好处。第二,/P既允许是字符串也允许是流,而这一点远不止适用于Web Capture。ISO 32000-1反复允许单个键在值可能任意大时容纳字符串或流两种形式——这里是POST请求体,同样的模式在格式的其他地方也出现在元数据和内嵌负载上。因此GetWebCaptureCommand内部的ReadString助手带一个AllowStream标志,只有读/P时传True:流值会经过它的filter链解码,作为PostData字段返回,而/URL、/CT和/H保持纯字符串,因为规范没给它们流的选项。如果你自己写PDF读取代码,这个习惯值得偷师——去查规范里哪些键是双类型的,别想当然地假设是字符串
var
  Lib: TPDFlib;
  Command: TPDFlibWebCaptureCommand;
  I, Total, Removed: Integer;
begin
  Total := Lib.GetWebCaptureCommandCount;
  // 公开索引是 1-based,与 Delphi 版 PDF Library 的其他部分一致。
  for I := 1 to Total do
    if Lib.GetWebCaptureCommand(I, Command) = 1 then
      Writeln(Format('%s  levels=%d  flags=%d  post=%d bytes',
        [Command.URL, Command.Levels, Command.Flags, Length(Command.PostData)]));

  // 移除整个 /SpiderInfo 字典,并报告有多少
  // 条命令被丢弃;没有可清除内容时返回 0。
  Removed := Lib.ClearWebCaptureCommands;
  Writeln(Format('cleared %d command(s)', [Removed]));
end;ClearWebCaptureCommands先数出命令条数,然后把整个/SpiderInfo键从catalog里清掉,而不是只把/C清空。留下一个带空命令数组的/SpiderInfo,等于宣称这份文档有Web Capture溯源、只是什么都没抓——这和"没记录溯源"是完全不同且错误的主张。同样的直觉适用于所有catalog元数据——一个空壳字典是一句陈述,不是中性的残留。如果你在改写文档前想审计它已有的声明,从现有PDF中读回大纲和注释动作里的自省模式,和这里的先读后清配合得正好
写元数据不等于实现Web Capture
对自己直说边界:AddWebCaptureCommand保存的是一条打算抓或已抓完的记录,仅此而已。PDF Library for Delphi不执行HTTP请求,不跟Levels值描述的链接,也不遵守SAME_SITE或SAME_PATH标记——那些标记记录的是某个爬虫当时的行为,不是库要执行的指令。你自己的抓取代码,不管是什么,完全是你的问题
ISO 32000-1 §14.10还有两块内容也不在这个API范围内。Web Capture定义了内容集(content sets)——把页面片段和它们来源素材绑在一起的/Contents结构——以及一个把数字标识映射到这些内容集的name tree。PDF Library for Delphi两个都不维护。你拿到的是命令列表:对"这份文档从哪里抓来的、爬了多深"这种顶层问题的答案,而出于溯源、审计和归档入库的目的,这通常正是大家真正会问的部分。如果你需要URL对读者可点击,而不只是给审计者记录在案,那是另一份工作——动作那一侧看构建GoToR、GoToE和Launch动作,在打开或关闭时触发行为看文档与页面生命周期动作触发器。这里描述的Catalog /SpiderInfo命令元数据是PDF Library for Delphi的一部分,它是面向Delphi和C++Builder的原生PDF库