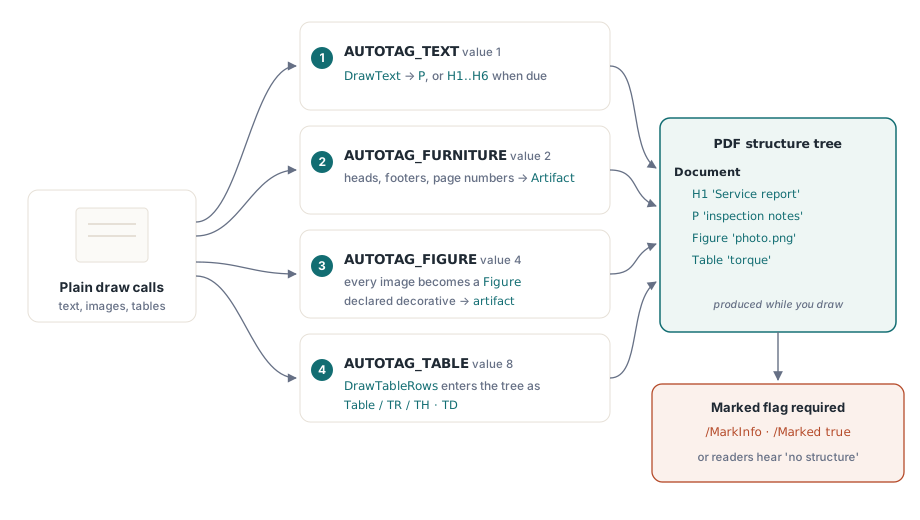
用屏幕阅读器打开一份生成的报表,常见的失败一分钟内就冒出来:每一页都要念一遍“第 3 页,共 40 页”,公司 logo 被通报成“图形”然后再无下文,一张表格被读成一长串没有列名的数字。PDF Library for Delphi 用自动结构标签避开这三件事:调一次 SetAutoTagMode,普通的绘图调用就会在绘制文档的同时产出段落、标题、插图、表格和可跳过的页面装饰
手工路线仍然存在。你可以把每个绘图调用都包进 BeginTag 和 EndTag,对结构不寻常的文档这是合适的工具。但对普通的报表、发票或对账单来说,手工打标签意味着无障碍性取决于:产品的整个生命周期里、每一条会画东西的代码路径上,没有人忘记过任何一对标签。合规要求我们不会押在这种事上
SetAutoTagMode 打开了什么
SetAutoTagMode 接受一个位掩码,返回调用之前生效的模式。每个位对应一类内容:
AUTOTAG_TEXT(1):文本成为段落;若已注册标题则成为标题AUTOTAG_FURNITURE(2):页眉、页脚和页码成为阅读器跳过的 artifactAUTOTAG_FIGURE(4):绘制的图像成为插图;若你声明它是装饰则成为 artifactAUTOTAG_TABLE(8):绘制的表格把行和单元格带进结构树AUTOTAG_DEFAULT(15):全部四项,也是我们建议任何新报表代码使用的值
打开这个模式还会把文档标记为 tagged,这一步比看上去重要。按 ISO 32000-1 §14.7.1,除非 catalog 的 /MarkInfo 字典写明 /Marked true,阅读器会把文件当成未打标签。一份文件可以带着完整、正确的结构树,却被通报成完全没有结构——因为告诉辅助技术去找结构的那一个标志缺失了。树在那里。没有任何东西去读它
文本标签按调用生效。每个 DrawText、DrawWrappedText 或 DrawTextBox 调用成为一个元素,所以用五次 DrawText 一行一行画的段落,到阅读器那里就是五个单行段落。如果你的排版代码本来就在自己断行,这一点值得改:把整段交给 DrawWrappedText,让一次调用产出一段
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;
  try
    Lib.SetOrigin(1);                          // 左上角原点,y 向下增长
    Lib.SetDocumentLanguage('en-US');
    Lib.SetAutoTagMode(AUTOTAG_DEFAULT);       // 在任何 RegisterHeading 调用之前
    Lib.AddStandardFont(4);

    Lib.SetTextSize(18);
    Lib.RegisterHeading(1, 'Annual service report');
    Lib.DrawText(72, 96, 'Annual service report');        // 标记为 H1

    Lib.SetTextSize(11);
    Lib.DrawWrappedText(72, 130, 450,
      'Every unit installed before 2024 was inspected. ' +
      'Units that failed the torque check were serviced on site.');  // 一个 P

    // ... 其余页面 ...

    // 会作用于所有已有页面,所以等页面画完再调
    Lib.AddPageFooter('', 'Page &P of &N', 36, 1.0, 1);  // 分页 artifact
    Lib.SaveToFile('report.pdf');
  finally
    Lib.Free;
  end;
end;第三行上那条注释是有原因的。RegisterHeading 只在文本标签已开启时才把标题级别排进队列,而 SetAutoTagMode 运行时会清空所有排队中的级别。先注册标题、后开模式,标题出来就是一个普通段落,任何地方都不会有错误来提醒你
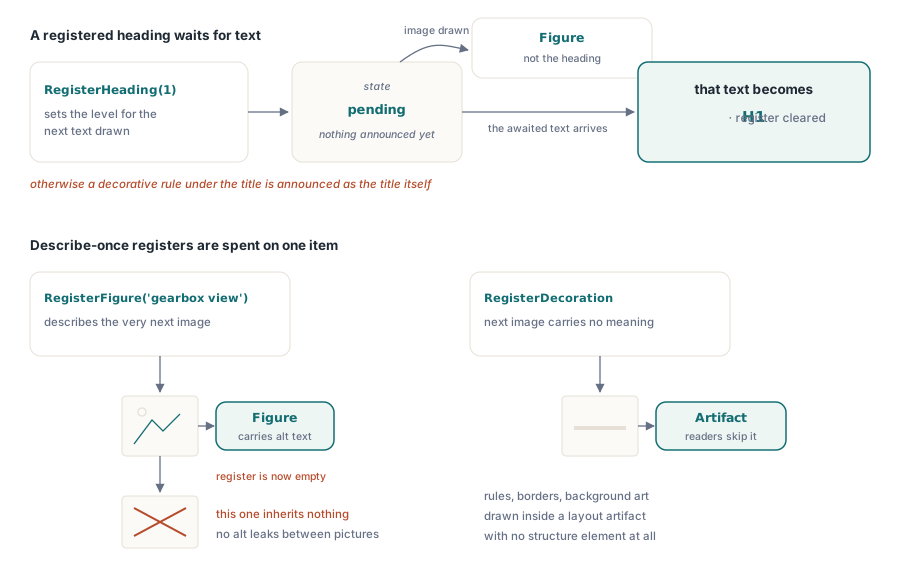
标题为什么会等它前面画的图像先过?
RegisterHeading 为下一段文本指定级别,而且只有文本能把它消耗掉。如果中间画了一张图像,图像成为插图,标题继续排队等后面的文本。想当然的实现会让任何标签消耗排队的级别,于是“注册一节标题、画一张横幅图、再画标题”这个常见序列,就会产出被标成 H2 的横幅和被降级为段落的真标题。按标题导航的阅读器会落在一幅图片上
队列的工作方式还带来两件事。标题级别附着在下一段文本上,与你传给 RegisterHeading 的字符串无关:如果你的排版在标题上方画一个小小的“第 3 节”眉题,眉题就成了标题。超过六级的级别写成 H6,因为阅读器对更深的东西一无所知。Title 参数仍然做它自己的事:喂给大纲,DrawTOC 之后把它变成目录
图像得到同样的“一次消耗”待遇。RegisterFigure 为下一张图像提供描述文本,RegisterDecoration 声明下一张图像是没有含义的线条、边框或背景,随后作为 Layout artifact 写出(ISO 32000-1 §14.8.2.2)。每条声明恰好被一张图像消耗,所以后面的图像绝不会继承为前面那张写的描述。贴错图片的替代文本比没有更糟,因为阅读器会字正腔圆地陈述一个错误的事实
我们刻意不去猜测哪些图像是装饰。一张图像要么是阅读器应当描述的内容,要么是它应当跳过的内容,只有调用代码知道答案。要避免的是第三种情况:什么声明都没有的图像会变成没有描述的插图,过不了 PDF/UA,还会让屏幕阅读器停下来说一声“图形”然后陷入沉默。在报表代码里 grep DrawImage,每一处命中的上方都应该有一行 RegisterFigure 或 RegisterDecoration
Lib.RegisterHeading(2, 'Gearbox inspection');   // 排队等下一段文本

Lib.RegisterFigure('Exploded view of the gearbox assembly');
Lib.AddImageFromFile('gearbox.png', 0);       // 加载并选中图像
Lib.DrawImage(72, 160, 360, 270);             // 成为带标签的 Figure

Lib.RegisterDecoration;                       // 无含义的线条
Lib.AddImageFromFile('divider.png', 0);
Lib.DrawImage(72, 450, 360, 4);               // 画在 layout artifact 之内

Lib.DrawText(72, 480, 'Gearbox inspection');  // 直到这时 H2 才出现
描述文本值得比文档里任何其他字符串更多的用心。非视觉读者拿它代替图片,而且这就是他们的全部。“图表”什么也告诉不了他们;“按地区分列的季度营收,第三季度东区最高”则把视觉读者两秒钟从图里看出的东西讲给他们
表格:表头行靠声明,从不靠猜
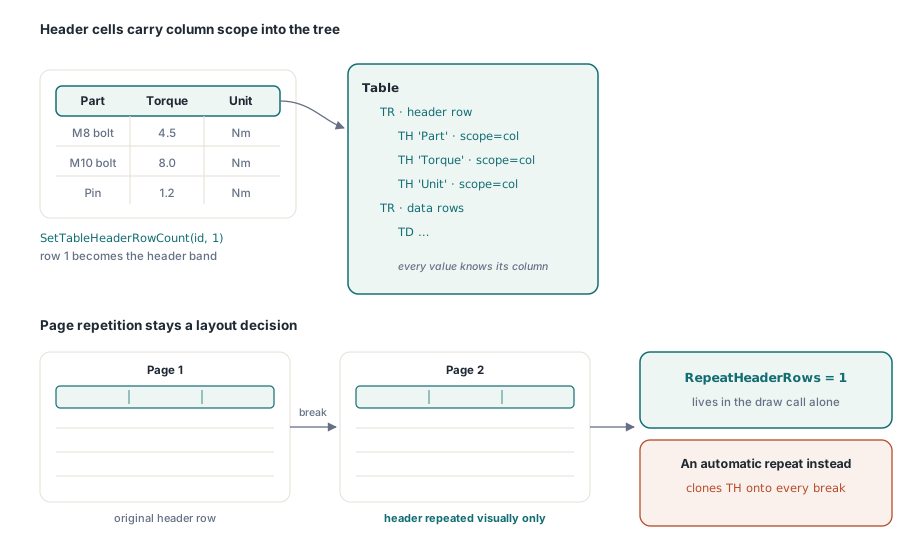
表格位打开后,DrawTableRows 会把表格、行和单元格写进结构树,阅读器因此能说清一个值坐在哪一列,而不是把整片网格当不相干的文本读出来。SetTableHeaderRowCount 声明开头几行是表头。这些行写成带列作用域的 TH 单元格,用户移到一个值上时,阅读器才能先报出“扭矩”再报值
表头行数默认为零,这是刻意的选择。表格第一行通常确实是表头,靠猜大多数时候也能猜对。但猜错的代价不对称:一行数据被当成表头,就会被在它那一列的每个值前面朗读一遍,这比一张完全没有表头的表格困惑得多。你写一行代码,比这种失败便宜
声明表头行与在每页重复表头是两个独立的决定。SetTableHeaderRowCount 是语义层面的,页面上什么都不改。重复是布局层面的事,归 DrawTaggedTableRows 的 RepeatHeaderRows 参数管。如果两者合成一个设置,请求正确的表头标签就会顺带画出你从没要过的重复表头带,逐页核对过的版式随之移动。传给 RepeatHeaderRows 的行同样会被标为表头,所以同一件事不必说两遍
var
  TableID: Integer;
begin
  TableID := Lib.CreateTable(40, 3);
  Lib.SetTableHeaderRowCount(TableID, 1);       // 第 1 行是表头带
  Lib.SetTableCellContent(TableID, 1, 1, 'Part');
  Lib.SetTableCellContent(TableID, 1, 2, 'Torque');
  Lib.SetTableCellContent(TableID, 1, 3, 'Unit');
  // ... 填充数据行 ...
  // 将第 1..40 行绘制到 600pt 带区中,每页重复一行表头
  Lib.DrawTaggedTableRows(TableID, 72, 150, 600, 1, 40, 1);
end;
自动文档里的手工标签段落
只要你手工打开的标签还没关,自动标签就靠边站。这让你的代码自己描述文档的一部分,其余交给库,两者互不嵌套——大多数真实文档要的正是这种安排。封面页和签名区块的结构只有你自己懂;两者之间那两百页正文的结构不需要你懂
无论怎么混用,三条规则保证输出有效。artifact 之内不打任何标签,因为 artifact 的 marked-content 序列没法同时携带结构元素,硬要尝试的文件过不了 PDF/UA 验证。空文本不开元素,所以一个误写的空串 DrawText 不会留下一个被阅读器念成空白的元素。内部会调用其他绘图函数的库调用,只在外层开一个标签,所以它的各个部分不会自己再嵌进第二个元素
保存之后,先把树读回来再谈信任。读取 API 从 1 起始,这一点坑过我们自己:第一版检查循环从 0 跑到 StructTreeItemCount - 1,开头读到一个空记录,最后一个元素永远够不着,有一阵子我们坚信一个段落丢了。什么都没丢。只是循环两端各差了一
var
  I: Integer;
begin
  // 手工标签的引文块;自动标签不掺和
  Lib.BeginTag('BlockQuote', '', '');
  Lib.DrawWrappedText(72, 520, 450,
    'All readings were taken with the unit at operating temperature.');
  Lib.EndTag;
  Lib.SaveToFile('report.pdf');

  // 把树读回来:索引从 1 到 StructTreeItemCount
  if Lib.LoadFromFile('report.pdf', '') = 1 then
    for I := 1 to Lib.StructTreeItemCount do
      Writeln(Lib.GetStructTreeItemText(I, 2), '  ',    // 解析后的类型
              Lib.GetStructTreeItemText(I, 4));         // /Alt,如果有的话
end;
这样一份清单是快速的健全性检查,不是终审判决。你想看到的是:第一段之前有一个 H1,每张插图带着自己的描述,没有哪张插图的 /Alt 是空的
当绘制顺序与阅读顺序分道扬镳
自动标签按内容绘制的顺序登记元素。如果你的排版代码先画侧栏再画正文,树里就是这个顺序,屏幕阅读器读的也是这个顺序。视觉顺序与阅读顺序确实不同、或需要其他结构类型、逐元素语言设置的文档,手工标签 API 更合适,tagged PDF 与无障碍结构一文详细讲了角色、作用域与表头绑定
对不是你自己画的页面——比如没有 marked content 的导入页——AutoTagPages 可以事后补标签:它把所给页面上的文本尺寸中位数当作正文,明显更大的文本串当标题,其余绘制标记为 artifact。对无法重新生成的内容,这是合适的工具。凡是自己代码画的东西,我们更主张在绘制时就打标签,因为那样库是被明确告知什么是标题,而不是从字号去猜
文档完成之后,送进检查器验证,不要想当然:PDF/A 与 PDF/UA preflight 的笔记演示了如何对你产出的结构拿到一个结论,数据集驱动的报表导出一文则展示这些调用在一台从数据构建版式的报表引擎里坐在什么位置
PDF Library for Delphi 以原生 Pascal 编写,面向 Delphi、C++Builder 和 Lazarus,无需随附任何外部 PDF 运行时,tagged 输出来自画页面的同一份代码。完整 API 参考与平台清单见 PDF Library for Delphi 产品页