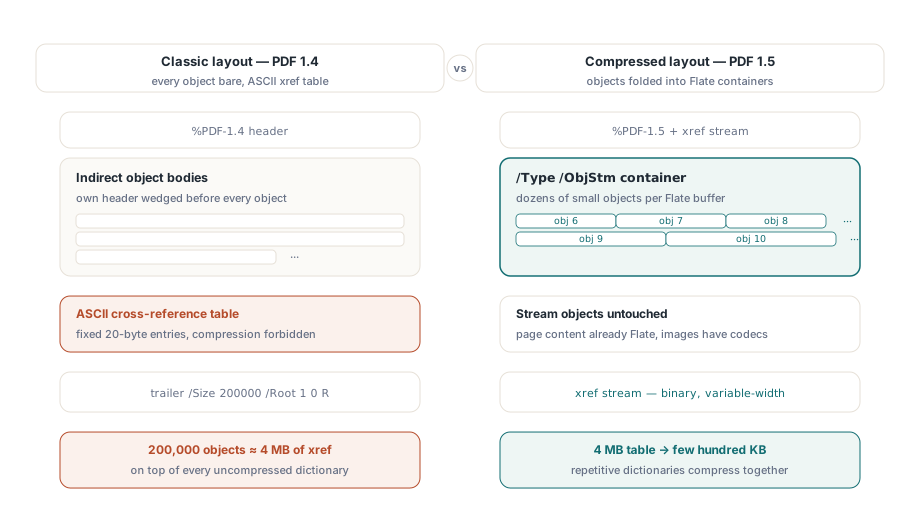
PDF 1.5 giới thiệu hai cấu trúc lưu trữ mà định dạng tệp trước đó không có cách nào diễn đạt: object stream và cross-reference stream (luồng tham chiếu chéo). Một object stream là một container nén Flate duy nhất, được gắn thẻ /Type /ObjStm, chứa nhiều đối tượng gián tiếp nhỏ được đóng gói nối tiếp nhau thay vì rải rác chúng khắp thân tệp. Một cross-reference stream là bảng tra cứu của tệp được viết lại thành nhị phân đã nén với các trường có độ rộng thay đổi, thay cho bảng ASCII có độ rộng cố định đã khép lại mọi PDF cho đến phiên bản 1.4. Chúng đi cùng nhau. Một khi các đối tượng được gấp vào một luồng, bảng văn bản cũ không còn có thể định địa chỉ chúng, nên xref nhị phân phải đi kèm với nó
Đặt nó cạnh bố cục cổ điển và chi phí mà nó loại bỏ rất dễ nhận thấy. Trong một tệp PDF 1.4, mọi đối tượng gián tiếp nằm không nén sau tiêu đề obj riêng của nó, và bảng ở cuối tệp tiêu tốn đúng 20 byte ASCII cho mỗi mục, không được phép nén. Một tài liệu với 200.000 đối tượng mang theo khoảng 4 MB dữ liệu tham chiếu chéo trước khi một glyph duy nhất được vẽ, cùng với tất cả các thân dictionary không nén xếp chồng lên trên. PDF 1.5 tấn công cả hai con số cùng lúc: các dictionary được gấp vào các container Flate, và bảng 4 MB thu nhỏ xuống còn vài trăm kilobyte nhị phân. ISO 32000-1 định nghĩa hai cấu trúc này trong §7.5.7 và §7.5.8
Khoản tiết kiệm thực sự rơi vào đâu
Object stream chỉ chạm vào các đối tượng không phải luồng (non-stream), nên chúng nén cấu trúc, không phải điểm ảnh. Nội dung trang đã được nén Flate từ trước 1.5, và dữ liệu ảnh mang theo codec riêng của nó, đó là lý do tại sao một tờ rơi nhiều ảnh hầu như không nhúc nhích. Các tệp co lại mạnh nhất là các tệp nặng về cấu trúc: AcroForm với hàng nghìn dictionary trường, cây outline sâu, các phần tử cấu trúc tagged-PDF. Những đối tượng đó nhỏ, nhiều, và gần như giống hệt nhau, và sự lặp lại đó chính xác là điều Flate khai thác một khi chúng nằm trong một bộ đệm duy nhất thay vì rải khắp thân tệp với các tiêu đề chen vào giữa
Rất dễ đánh giá thấp việc một tệp cũ có bao nhiêu chi phí trên đầu (overhead). Một kho lưu trữ biểu mẫu đã hấp thụ nhiều năm chỉnh sửa có thể tiêu tốn hơn một nửa số byte của nó vào các tiêu đề dictionary, phần đệm xref, và các phiên bản mà không trình đọc nào từng nhìn vào. Hai tính năng ở đây thu hồi hai khoản đầu tiên trong số đó. Khoản thứ ba, các phiên bản tích lũy, chỉ nhường bước trước việc nén gọn (compaction), một khi tệp không còn phải ghi nhớ lịch sử của chính nó
Trong HotPDF bạn bật cả hai thông qua một cặp thuộc tính, và cách chúng phụ thuộc lẫn nhau quan trọng hơn thứ tự bạn viết chúng:
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.FileName := 'catalog-2026.pdf';
    Pdf.UseXRefStream := True;      // xref nhị phân, điều kiện tiên quyết cho ObjStm
    Pdf.UseObjectStreams := True;   // đóng gói đối tượng vào /Type /ObjStm
    Pdf.BeginDoc;
    Pdf.CurrentPage.SetFont('Arial', [], 11);
    Pdf.CurrentPage.TextOut(50, 760, 0, 'Compressed structure demo');
    Pdf.EndDoc;                     // phát ra các container XRefStm + ObjStm
  finally
    Pdf.Free;
  end;
end;
UseObjectStreams cần UseXRefStream được đặt thành True. Một đối tượng đã nén được tiếp cận thông qua một mục xref kiểu 2, mục này ghi lại một số hiệu object stream cộng với một chỉ mục, và một dòng văn bản 20 byte cổ điển không có chỗ để lưu cặp giá trị đó. Vì vậy UseObjectStreams đứng một mình sẽ không làm gì thấy được; cả hai cờ, được đặt trước BeginDoc, mới là cấu hình hoạt động. Đặt chúng sau BeginDoc và HotPDF đã cam kết với bố cục cũ hơn rồi
Tại sao cả hai mặc định đều tắt
HotPDF để cả hai thuộc tính là False ngay từ đầu, và lý do thể hiện rõ trong các tích hợp với mã hạ nguồn cũ. Một trình đọc chỉ hiểu PDF 1.4 không thông báo rằng nó không thể xử lý các đối tượng đã nén. Nó gặp một xref stream, không tìm thấy bất kỳ từ khóa trailer nào nó mong đợi, và báo cáo một bảng tham chiếu chéo bị hỏng hoặc đơn giản là từ chối mở tệp. Nếu đầu ra của bạn chảy vào một cổng fax cũ kỹ, một máy in phần cứng chạy một trình thông dịch nhúng, hoặc một trình phân tích cú pháp ai đó đã viết theo đặc tả 1.4 cách đây một thập kỷ, hãy giữ cả hai cờ tắt cho kênh đó và chấp nhận tệp lớn hơn. Đối với lưu trữ và phân phối web, nơi mọi trình xem phổ biến đã đọc được PDF 1.5 suốt hai mươi năm, bật chúng lên là khoản nén gần như miễn phí
Có một hiệu ứng bậc hai đáng nói với đội hỗ trợ của bạn. Một khi các dictionary được đóng gói vào các object stream, việc so sánh hai tệp được tạo ra byte theo byte không còn có ý nghĩa gì nữa, vì thay đổi một trường duy nhất có thể nén Flate lại toàn bộ container và xáo trộn mọi thứ sau nó. Hãy diff các tệp như vậy theo nội dung đối tượng, không phải bằng so sánh nhị phân
Cập nhật gia tăng và các offset byte mà chúng bảo vệ
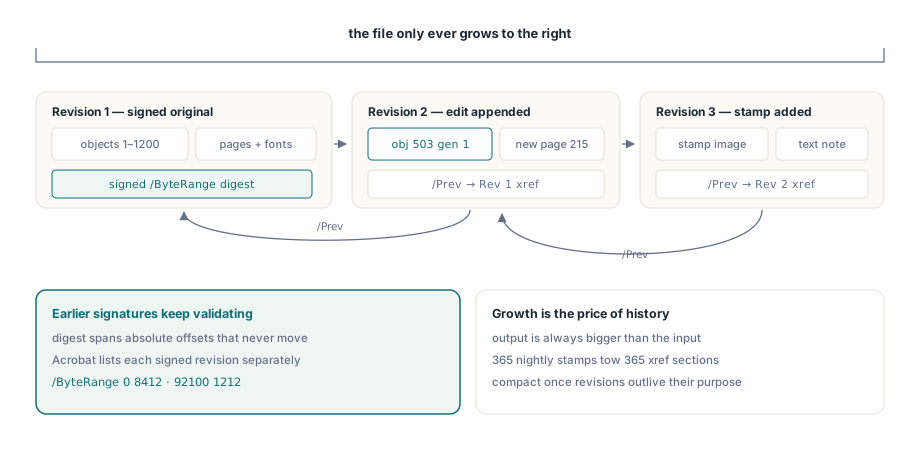
Một chữ ký số bao phủ một /ByteRange tường minh: hai đoạn của tệp vật lý, được cho dưới dạng offset byte tuyệt đối, mà bản digest CMS được tính trên đó. Ghi lại tệp, ngay cả thành thứ gì đó trông giống hệt trên màn hình, và tất cả các offset đó đều dịch chuyển. Bản digest ngừng khớp và chữ ký đọc như bị hỏng. Đó chính xác là vấn đề mà ISO 32000-1 §7.5.6 giải quyết bằng các bản cập nhật gia tăng. Các đối tượng mới và đã thay đổi được nối thêm sau %%EOF hiện có, sau đó một phần tham chiếu chéo mới được ghi mà mục /Prev của nó trỏ ngược lại phần trước đó. Các byte gốc không bao giờ bị xáo trộn, nên một phiên bản đã ký vẫn có thể xác minh được và Acrobat có thể trình bày từng phiên bản đã ký riêng biệt trong bảng chữ ký
HotPDF phơi bày điều này thông qua điểm vào riêng của nó:
Pdf.BeginIncrementalUpdate('contract-signed.pdf');
Pdf.AddPage;
Pdf.CurrentPage.SetFont('Arial', [], 10);
Pdf.CurrentPage.TextOut(50, 760, 0, 'Addendum recorded 2026-06-11');
Pdf.SaveIncrementalUpdate('contract-updated.pdf');  // chỉ nối thêm phần chênh lệch
Có hai điều khiến người ta vấp phải. BeginIncrementalUpdate phải nhận tên tệp gốc, vì phần xref được nối thêm ghi lại các offset chỉ có ý nghĩa khi đối chiếu với chính xác các byte gốc đó; trỏ nó vào một bản sao đã đổi tên hoặc đã lưu lại và các offset sẽ mô tả một tệp không còn tồn tại nữa. Và việc lưu chỉ-nối-thêm theo cấu trúc, nên đầu ra luôn lớn hơn đầu vào. Sự tăng trưởng đó không phải là lãng phí cần điều chỉnh bớt đi. Đó chính là đặc tính giữ cho các phiên bản đã ký trước đó nguyên vẹn
Sửa đổi một tệp đã tải đi qua LoadFromFile
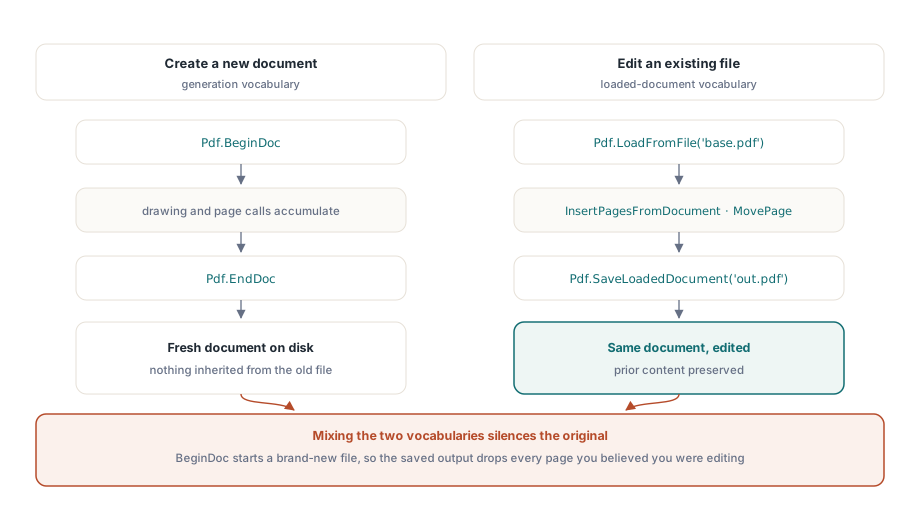
Các nhà phát triển lần đầu gặp HotPDF thông qua API tạo tài liệu của nó thường va phải một bức tường cụ thể. BeginDoc mở một tài liệu hoàn toàn mới, đây là công cụ sai khi bạn có ý định thay đổi một tài liệu đã tồn tại. Chỉnh sửa một tệp hiện có thay vào đó đi qua các lệnh gọi tài liệu-đã-tải:
PageCount := Pdf.LoadFromFile('base.pdf');
Pdf.InsertPagesFromDocument(OtherDoc, '1-3', 5);  // trang 1-3 sau trang 5
Pdf.MovePage(2, 5);
Pdf.SaveLoadedDocument('modified.pdf');
Trộn lẫn hai cái và triệu chứng là một tệp đầu ra chứa nội dung mới của bạn và không có gì của bản gốc, vì BeginDoc đã vui vẻ xây dựng một tài liệu hoàn toàn mới bên cạnh tài liệu bạn tin rằng mình đang chỉnh sửa. Hãy đọc LoadFromFile cùng với SaveLoadedDocument như một bộ từ vựng và BeginDoc cùng với EndDoc như một bộ khác. Một quy trình chạm vào cả hai bộ trên cùng một tệp gần như luôn luôn sai
Khi nào nên nén gọn một tệp đã được nối thêm
Việc lưu chỉ-nối-thêm mang theo một chi phí âm thầm tích lũy. Một tác vụ chạy hàng đêm đóng dấu một dòng trạng thái lên cùng một PDF sẽ tạo ra 365 phiên bản trong một năm, và mỗi phiên bản kéo theo một phần xref mới phía sau nó. Khi lịch sử đó đã hết giá trị sử dụng, và không có chữ ký nào trong tệp cần được giữ lại, bạn có thể làm phẳng toàn bộ bằng cách tuần tự hóa lại nó thông qua đường tài liệu-đã-tải:
Pdf.LoadFromFile('stamped.pdf');
Pdf.SaveLoadedDocument('compacted.pdf');
Việc lưu lại này là một lần ghi lại toàn bộ. Nó cố ý loại bỏ các phiên bản trước đó và phá vỡ bất kỳ chữ ký nào còn trong tệp, nên hãy đặt nó sau cùng một cổng chính sách mà bạn áp dụng cho bất kỳ bước phá hủy nào khác. Một quy tắc sản xuất đã được chứng minh: nén gọn khi số lượng phiên bản vượt qua một ngưỡng, hoặc khi chi phí nối thêm tích lũy vượt quá một tỷ lệ nào đó của tệp gốc, và không bao giờ nén gọn một tài liệu mà bảng chữ ký của nó có bất cứ thứ gì trong đó
Kiểm tra đầu ra trước khi phát hành
Xác minh cặp tính năng này khá cụ thể và dễ chịu. Mở kết quả trong Adobe Acrobat và xác nhận ba điểm: thuộc tính tài liệu báo cáo PDF 1.5 hoặc mới hơn một khi object stream được bật; bảng chữ ký vẫn xác thực mọi phiên bản đã ký trước đó sau một lần cập nhật gia tăng; và số trang cùng bookmark đi qua một chu trình tải, sửa đổi, và lưu mà không bị tổn hại. Đối với đầu ra lưu trữ, hãy đẩy tệp qua veraPDF nữa, vì một xref đã nén chính xác là loại cấu trúc mà một trình xác thực nghiêm ngặt xem xét kỹ lưỡng hơn nhiều so với bất kỳ trình xem khoan dung nào từng làm. Nếu công việc của bạn cũng liên quan đến các đầu vào rất lớn, các phương pháp kiểm tra trong bài hướng dẫn của chúng tôi về Direct File API cho các quy trình PDF lớn kết hợp một cách tự nhiên với việc lưu gia tăng, và cơ chế chữ ký đằng sau các phạm vi byte ở trên được trình bày chi tiết trong bài viết về chữ ký số và PAdES của HotPDF
Cả hai tính năng đều được phát hành như một phần của HotPDF Delphi Component cho Delphi và C++Builder, bên cạnh các API tạo tài liệu, biểu mẫu, mã hóa, và ký được trình bày ở nơi khác trên blog này. Trang sản phẩm liên kết đến tài liệu tham khảo API đầy đủ nếu bạn muốn đối chiếu các lệnh gọi ở trên với pipeline tài liệu của riêng bạn