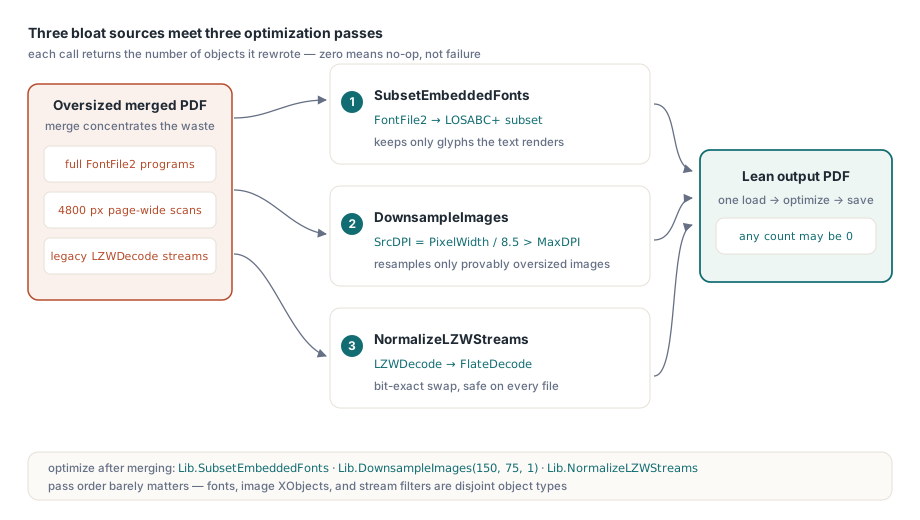
Để giảm kích thước tệp PDF trong Delphi, losLab PDF Library cung cấp ba API nhắm vào ba nguồn phình to lớn nhất: SubsetEmbeddedFonts ghi lại mọi chương trình font TrueType nhúng, thu về đúng những glyph mà tài liệu thực sự render, DownsampleImages lấy mẫu lại các ảnh raster vượt quá mức DPI mục tiêu, còn NormalizeLZWStreams thay nén LZWDecode cũ bằng FlateDecode. Mỗi hàm trả về số object nó đã thay đổi, nên giá trị không cho bạn biết lượt xử lý là vô tác dụng chứ không phải thất bại âm thầm
Vì sao PDF sau khi gộp lại lớn hơn các tệp nguồn của nó?
Một tệp PDF được gộp hoặc sinh bằng chương trình thường phình to vì một trong ba lý do: font nhúng đầy đủ, ảnh được lấy mẫu ở mức cao hơn nhiều so với độ phân giải hiển thị, và stream vẫn nén bằng bộ lọc LZW cũ. ISO 32000-1 §9.9 cho phép bộ sinh nhúng nguyên chương trình font, và phần lớn bộ sinh làm đúng như vậy vì đó là mặc định an toàn. Một font Arial FontFile2 đầy đủ chiếm hàng trăm kilobyte; nhúng nó vào một tá tệp nguồn, gộp chúng lại, và bạn đang mang theo một tá bản sao đường viền glyph cho những ký tự chẳng ai gõ. Bản thân việc gộp không tạo ra lãng phí, nó chỉ dồn lãng phí vào một tệp duy nhất nơi tổng số cuối cùng trở nên lộ rõ
Ảnh là thủ phạm thứ hai. Một bản quét rộng 4800 pixel đặt vào khung chiếm một phần tư trang mang theo lượng dữ liệu điểm ảnh nhiều gấp khoảng 40 lần so với mức một pipeline in 300 DPI có thể dùng. Thủ phạm thứ ba lặng lẽ hơn: stream lọc bằng LZWDecode. ISO 32000-1 §7.4.4 đặc tả cả LZWDecode lẫn FlateDecode, và ghi nhận rằng Flate thường nén ít nhất là tốt ngang bằng; trên thực tế đầu ra của Flate luôn nhỏ hơn trên cùng một dữ liệu, còn LZW chủ yếu sống sót trong những tệp từng đi qua công cụ thời thập niên 1990 ở đâu đó trong lịch sử của chúng. Phần còn lại của bài viết này đi qua ba lượt xử lý của losLab PDF Library khắc phục từng vấn đề, rồi kết hợp chúng thành một pipeline
Lấy tập con font với SubsetEmbeddedFonts
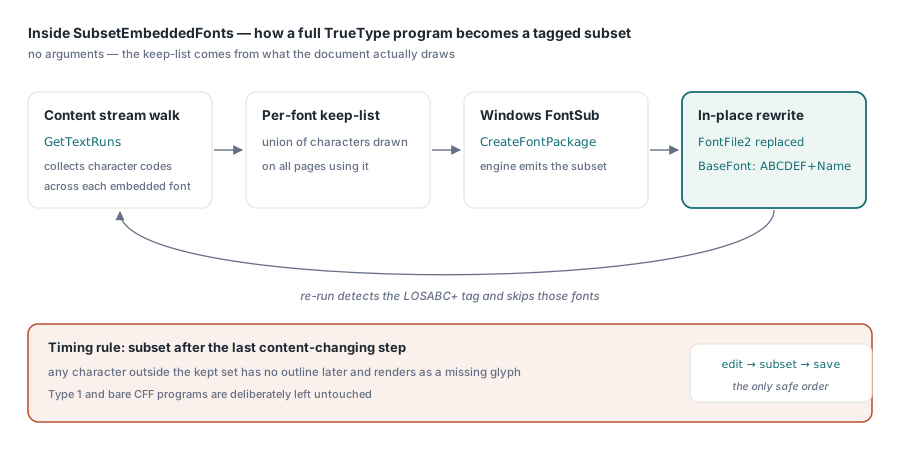
SubsetEmbeddedFonts thu nhỏ mọi font TrueType nhúng trong tài liệu đã nạp về đúng những ký tự tài liệu thực sự dùng, và nó không cần tham số vì tự rút ra danh sách giữ lại từ chính các content stream. Bên trong, lượt xử lý này duyệt content stream của từng trang bằng GetTextRuns, thu thập các mã ký tự được tham chiếu dưới mỗi tài nguyên font, dựng danh sách giữ lại, rồi trao chương trình font gốc cho engine FontSub của Windows (CreateFontPackage) để tạo ra một tập con. Chương trình được ghi lại thay thế stream FontFile2 tại chỗ, và tên BaseFont nhận thêm thẻ LOSABC+, quy ước sáu chữ in hoa cộng dấu cộng mà ISO 32000-1 §9.6.4 định nghĩa cho font tập con. Tiền tố đó cũng là thứ khiến lệnh gọi này idempotent: chạy lượt xử lý hai lần thì các font đã lấy tập con được nhận ra và bỏ qua, nên đưa nó vào một tác vụ hàng loạt có thể xử lý lại cùng tệp là an toàn
var
  Lib: TPDFlib;
  Fonts: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('merged-report.pdf', '') = 1 then
    begin
      Fonts := Lib.SubsetEmbeddedFonts;
      // Fonts = số chương trình FontFile2 đã được ghi lại;
      // 0 nghĩa là không có gì được nhúng, hoặc mọi thứ đã lấy tập con rồi
      Lib.SaveToFile('merged-report-subset.pdf');
    end;
  finally
    Lib.Free;
  end;
end;
Có hai chi tiết cài đặt đáng biết vì chúng giải thích ranh giới của API. Thứ nhất, lượt xử lý nhắm vào FontFile2, nên nó bao phủ các chương trình TrueType nhúng; font nhúng dạng Type 1 hoặc CFF trần được để nguyên thay vì đem ra mạo hiểm. Thứ hai, nó dựa vào FontSub, điều này khiến SubsetEmbeddedFonts chỉ chạy trên Windows. Một điểm tinh tế hơn từ phần cài đặt: việc một font có đủ điều kiện hay không được quyết định bằng cách thực sự phân giải chuỗi tham chiếu FontDescriptor → FontFile2, chứ không phải bằng cách tin vào một cờ nhúng theo phỏng đoán, bởi font trong tài liệu đã nạp chưa từng đi qua khâu ghi sổ phía tạo tài liệu vốn đặt các cờ như vậy. Nếu stream phân giải được tồn tại, font là ứng viên; nếu không, nó bị bỏ qua mà không báo lỗi
Đánh đổi thẳng thắn: một font tập con chỉ chứa những glyph có mặt tại thời điểm lấy tập con. Nếu một công cụ phía sau, hoặc chính mã của bạn, sau đó thêm chữ bằng cùng font ấy, mọi ký tự nằm ngoài tập con đều không có đường viền và sẽ hiện ra như một glyph thiếu. Hãy lấy tập con ở bước cuối cùng làm thay đổi nội dung, không bao giờ trước một giai đoạn chỉnh sửa. Cùng lời cảnh báo đó áp dụng nếu bạn định lấy font ra dùng lại về sau; bài viết về trích xuất văn bản, ảnh và font bằng PDF Library for Delphi nói rõ một chương trình font tập con trích ra được có thể và không thể cho bạn những gì
DownsampleImages quyết định thu nhỏ ảnh nào ra sao?
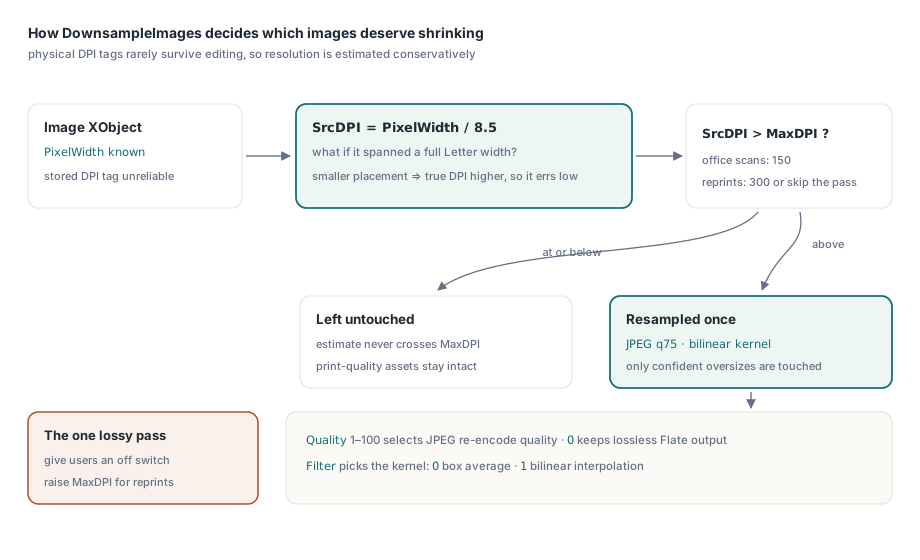
DownsampleImages(MaxDPI, Quality, Filter) chỉ lấy mẫu lại những ảnh nó có thể tự tin gọi là dư mẫu, dùng một ước lượng DPI cố ý thận trọng. Một image XObject của PDF lưu kích thước tính bằng pixel nhưng không có độ phân giải vật lý đáng tin, và mọi thẻ DPI từ ảnh nguồn hiếm khi sống sót qua một chu trình nạp, sửa, lưu. Vì vậy lượt xử lý ước lượng SrcDPI = PixelWidth / 8.5, tức là đang hỏi: nếu ảnh này trải hết chiều rộng một trang Letter, độ phân giải của nó sẽ là bao nhiêu? Chỉ những ảnh có ước lượng vượt MaxDPI mới bị đụng tới. Thiên lệch này là có chủ đích: một ảnh đặt nhỏ trên trang có DPI thật cao hơn ước lượng, nên lượt xử lý thà bỏ sót còn hơn làm hỏng một tài sản chất lượng in mà nó không đo được
Quality từ 1 tới 100 chọn chất lượng mã hóa lại JPEG, còn 0 giữ đầu ra ở dạng Flate không mất mát kiểu PNG; Filter chọn nhân lấy mẫu lại, 0 cho trung bình hộp và 1 cho song tuyến. Với giấy tờ văn phòng quét vào, DownsampleImages(150, 75, 1) là điểm khởi đầu hợp lý; với bất cứ thứ gì có thể được in lại, hãy nâng MaxDPI lên 300 hoặc bỏ hẳn lượt xử lý này. Hạ mẫu là bước duy nhất có mất mát trong ba bước, nên nó thuộc về một tùy chọn mà người dùng của bạn có thể tắt đi
Chuyển stream LZW cũ bằng NormalizeLZWStreams
NormalizeLZWStreams là phần lợi miễn phí: nó giải nén không mất mát mọi stream LZWDecode rồi nén lại bằng FlateDecode, ngay tại chỗ, và trả về số stream đã chuyển. Nó xử lý được cả một mục /Filter /LZWDecode đơn lẻ lẫn LZW xuất hiện bên trong một mảng chuỗi bộ lọc, nơi chỉ mắt xích LZW bị thay còn phần còn lại của chuỗi được giữ nguyên. Các tham số predictor (Predictor, Columns, Colors, BitsPerComponent) được đọc từ DecodeParms của stream và chuyển tiếp cho bộ giải nén, nhờ đó dữ liệu ảnh mã hóa bằng predictor đi vòng trở lại đúng nguyên trạng. Vì cả hai bộ lọc đều là codec chính xác đến từng bit, các byte giải mã ra là như nhau trước và sau; chỉ phần nén của vỏ chứa thay đổi, và đó là lý do lượt xử lý này an toàn khi chạy vô điều kiện trên mọi tệp
Với một tài liệu không có stream LZW nào, lệnh gọi đơn giản trả về 0 và không đụng tới thứ gì, điều mà bộ kiểm thử hồi quy của thư viện kiểm tra tường minh: một tệp mới tạo chỉ dùng Flate phải báo không có chuyển đổi nào. Bảo đảm vô tác dụng đó quan trọng khi lượt xử lý nằm trong một pipeline xử lý hàng nghìn tệp không đồng nhất, có tệp từ năm 2024 và có tệp từ năm 1998
Pipeline tối ưu kích thước đầy đủ trong Delphi
Ba lượt xử lý kết hợp thành một hàm nạp, tối ưu rồi lưu, và thứ tự ít quan trọng hơn bạn tưởng vì chúng làm việc trên những kiểu object rời nhau: font, image XObject và bộ lọc stream. Chạy lấy tập con trước vẫn là lựa chọn gọn gàng, vì đó là lượt xử lý có ràng buộc về thứ tự chỉnh sửa
function OptimizePDF(const Src, Dst: string): Boolean;
var
  Lib: TPDFlib;
  Fonts, Images, Streams: Integer;
begin
  Result := False;
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(Src, '') <> 1 then
      Exit;
    Fonts   := Lib.SubsetEmbeddedFonts;        // TrueType FontFile2 -> tập con
    Images  := Lib.DownsampleImages(150, 75, 1); // >150 DPI -> JPEG q75, song tuyến
    Streams := Lib.NormalizeLZWStreams;        // LZWDecode -> FlateDecode
    Result := Lib.SaveToFile(Dst) = 1;
    // Ghi log Fonts/Images/Streams: ba số không nghĩa là tệp vốn đã gọn
  finally
    Lib.Free;
  end;
end;
Hãy kiểm chứng pipeline theo đúng cách thư viện tự kiểm chứng: đi vòng trở lại. Bộ kiểm thử hồi quy v3.130 tạo một tài liệu, lưu nó, nạp lại, chạy tối ưu, lưu lần nữa, rồi khẳng định ba điều: đầu ra nhỏ hơn, các số trả về khớp kỳ vọng, và việc nạp lại tệp đã tối ưu vẫn phân tích và render được. Tái dựng vòng tạo, tối ưu, nạp lại đó trên một mẫu tệp sản xuất của chính bạn, và so sánh văn bản trích xuất trước và sau, là khoản đầu tư một giờ giúp bắt lỗi tích hợp từ rất lâu trước khi một khách hàng mở phải hóa đơn hỏng
// Kiểm tra vòng lặp: tệp đã tối ưu vẫn phải nạp được sạch sẽ
Lib := TPDFlib.Create;
try
  Assert(Lib.LoadFromFile('merged-report-opt.pdf', '') = 1);
  Assert(Lib.GetPageCount > 0);
finally
  Lib.Free;
end;
Pipeline này nằm ở đâu trong một quy trình gộp tệp? Sau khi gộp, không phải trong lúc gộp. Gộp trước rồi tối ưu kết quả duy nhất nghĩa là mỗi font nhúng chỉ được lấy tập con một lần dựa trên hợp của mọi ký tự được dùng, thay vì làm theo từng tệp nguồn. Nếu thông lượng gộp là nút thắt cổ chai, PDF Library for Delphi có một đường tắt ở mức byte tránh phân tích object đầy đủ, được mô tả trong bài viết về gộp PDF nhanh bằng dịch tham chiếu byte; còn với đầu vào quá lớn để giữ trọn trong bộ nhớ, gộp và tách bằng truy cập trực tiếp cho PDF lớn trình bày hướng đi theo dòng. Cả hai đều đi rất tự nhiên cùng một lượt tối ưu cuối trên đầu ra đã gộp
Ba lượt xử lý này sẽ không làm gì
Bộ ba tối ưu của losLab PDF Library cố ý loại trừ bất cứ thứ gì làm thay đổi ngữ nghĩa tài liệu. SubsetEmbeddedFonts không hợp nhất các font trùng lặp từ nhiều nguồn đã gộp thành một chương trình duy nhất, nó thu nhỏ từng font một cách độc lập; khử trùng lặp là một phép biến đổi khác và rủi ro hơn. DownsampleImages sẽ bỏ qua một ảnh có ước lượng DPI thận trọng nằm dưới ngưỡng ngay cả khi mắt người thấy rõ nó quá lớn so với khung của nó. Và không lượt nào đụng tới cấu trúc tài liệu, nên một tệp phình to vì hàng nghìn object mồ côi cần một lần lưu kiểu ghi lại toàn bộ chứ không phải các lượt ở mức stream này. Trong những giới hạn đó, sự kết hợp giữa lấy tập con font, hạ mẫu ảnh và chuẩn hóa LZW sang Flate loại bỏ ba nguồn phình to kinh điển của PDF, mỗi nguồn chỉ bằng một lệnh gọi API có thể đoán trước. Ba hàm này là một phần của losLab PDF Library cho Delphi, C# và VB.NET, bên cạnh các API gộp, trích xuất và render đã bàn ở trên