PDFium Component перевіряє еквівалентність метаданих Info та XMP у PDF/A через TPdf.InspectPdfAMetadata і лагодить її через TPdf.NormalizePdfAMetadata. ISO 19005-1 (з поправками Cor.1) вимагає, щоб кожен із вісьмох відображених записів Info, від Title до ModDate, ніс те саме значення, що й його властивість XMP, а не просто існував; перевірка читає правильну форму RDF, зіставляє простори імен за URI і порівнює дати як моменти часу
Баґ-репорт, який зазвичай починає цю розмову, виглядає нешкідливо. Система документообігу штампує новий /ModDate у словник Info при кожному інкрементальному збереженні, лишає XMP-пакет у спокої, і за пів року аудитор архіву мічить тисячі файлів невідповідними. Обидві дати на місці. Вони просто перестали збігатися з першої правки, а перевірка присутності цього не помітила. Правки Title через Info-only API і рядок Author на кшталт Finance; Controlling, який десь інструмент розрізав на два елементи dc:creator, фейлять так само
Чому PDF/A відхиляє метадані, які є в обох місцях?
PDF/A відхиляє їх, бо ISO 19005-1 §6.7.3 — це правило значення, а не правило присутності: Таблиця 1 відображає вісім ключів Info на властивості XMP, і щойно ключ Info присутній, відображена властивість XMP мусить тримати еквівалентне значення. Байтовий сканер, описаний у preflight-валідації PDF/A з PDFium Component, лише підтверджує, що xmp:CreateDate і xmp:ModifyDate існують (pvaiMissingXmpDates). Від v3.72.0 TPdf.ValidatePdfA додатково запускає повне порівняння значень і додає pvaiInfoXmpValueMismatch до набору проблем, коли XMP-пакет є, але розходиться з Info (пакет, який не парситься, рахується розбіжним). Відсутній пакет далі звітується як pvaiMissingXmpMetadata, тож дві проблеми ніколи не рахують той самий дефект двічі
Якої форми RDF потребує кожна відображена властивість XMP?
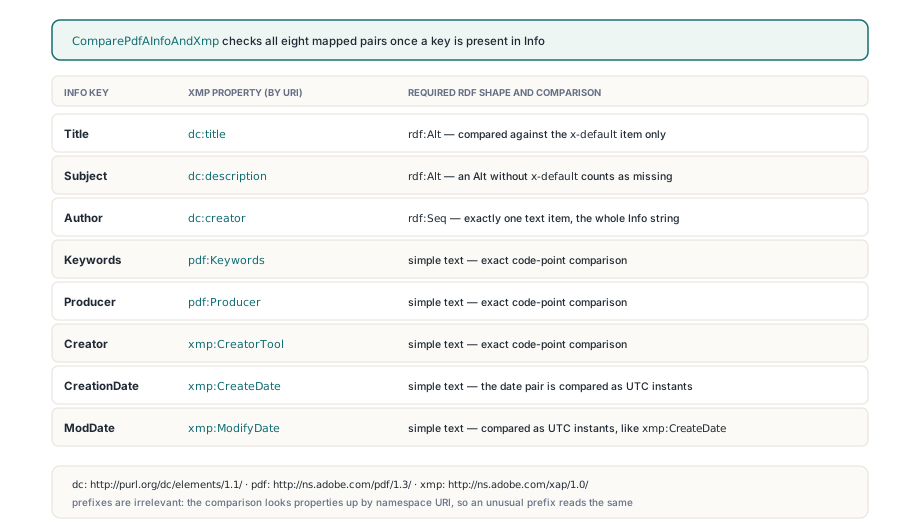
Кожне з вісьмох відображень має фіксований тип XMP, і коректне значення не в тому контейнері все одно фейлить. ComparePdfAInfoAndXmp у FPdfPdfa.pas шукає властивості за URI простору імен, тож пакет, який прив'язує http://purl.org/dc/elements/1.1/ до незвичайного префікса, читається точно так само, як пакет із dc. Потрібні форми такі:
- Title →
dc:titleі Subject →dc:description: альтернатива мовrdf:Alt, порівнювана лише з її елементомx-default(тег мови звіряється без урахування регістру); Alt безx-defaultрахується відсутнім - Author →
dc:creator:rdf:Seqрівно з одним текстовим елементом, що тримає весь рядок Info, тож список авторів через крапку з комою лишається одним записом - Keywords →
pdf:Keywordsі Producer →pdf:Producer(простір іменhttp://ns.adobe.com/pdf/1.3/): прості текстові властивості - Creator →
xmp:CreatorTool, CreationDate →xmp:CreateDate, ModDate →xmp:ModifyDate(простір іменhttp://ns.adobe.com/xap/1.0/): прості текстові властивості
<dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report 2026</rdf:li></rdf:Alt></dc:title>
<dc:creator><rdf:Seq><rdf:li>Finance; Controlling</rdf:li></rdf:Seq></dc:creator>
<pdf:Producer>PDFium Component</pdf:Producer>
Текстові значення порівнюються як точні послідовності кодових точок Unicode, без обрізання, складання регістру чи нормалізації. Пробіл у кінці, або препознована é з одного боку проти розкладеної e з комбінуючим наголосом з іншого — це справжня розбіжність. Сторона Info завжди походить з власного декодування PDFium тексту PDFDocEncoding і UTF-16 через FPDF_GetMetaText, що не дає бібліотеці перевтілювати декодування рядків і помилятися непомітно; сторона XMP чиста настільки, наскільки чисті байти, які її породили, — саме тому кодові сторінкові пастки, що псують метадані XMP під Free Pascal, мають значення і тут
Коли дата PDF і дата XMP рівні?
Дата PDF і дата XMP рівні, коли описують той самий момент з точністю до секунди, з однаковим знанням часового поясу з обох боків. Обидва парсери приймають легально скорочену точність, тож D:2026 і 2026 обидва означають 1 січня 2026, 00:00:00. Коли обидва значення несуть пояс, вони конвертуються в UTC перед порівнянням: D:20260827093659+08'00' дорівнює 2026-08-27T01:36:59Z. Коли пояс не несе жодне, локальні компоненти порівнюються як написано. Коли пояс є лише в одного боку, результат — pamsValueMismatch, бо вигадати зсув означало б вгадувати. Ненульова дрібна частка секунди на кшталт .250 в XMP також примушує розбіжність, бо дата PDF не має способу її виразити, а мовчазне округлення сховало б справжню розбіжність; .000 приймається. Непарсабельні значення звітуються окремо як pamsInvalidInfoDate чи pamsInvalidXmpDate
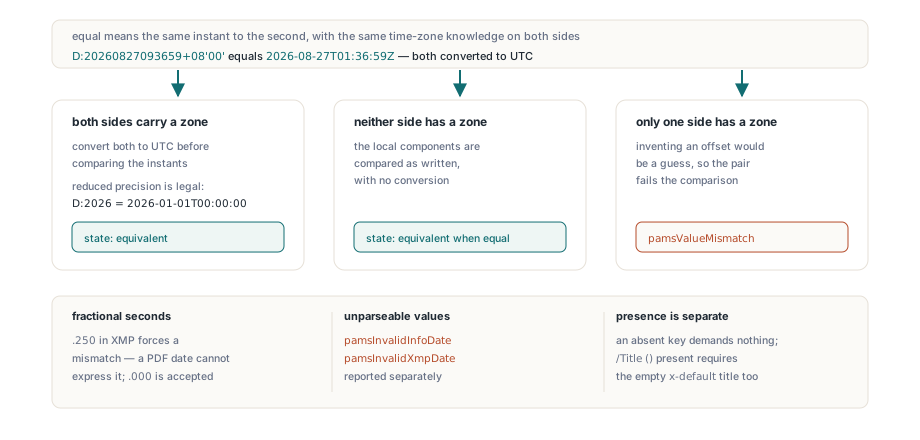
Присутність має власне правило. TPdfAMetadataValues.Present — це набір, який наповнюється обходом словника /Info активного trailer, і він тримає «ключа немає» порізно з «ключ є з порожнім рядком». Відсутній ключ дає pamsNotRequired і нічого не вимагає від XMP; /Title () присутній, тож XMP-пакет мусить нести порожній заголовок x-default так само
Як оглянути метадані Info та XMP перед збереженням?
TPdf.InspectPdfAMetadata повертає TPdfAMetadataReport з одним TPdfAMetadataComparison на поле, кожен тримає значення Info, значення XMP і TPdfAMetadataState, тож невдачу можна пояснити, не реверс-інженерячи жодного прапорця валідації. MismatchFields підсумовує набір провалів, HasXmpPacket каже, чи пакет знайдено, а XmpParseError несе повідомлення парсера, коли пакет є, але не читається
uses
  System.SysUtils, PDFium, FPdfPdfa;

const
  FieldNames: array[TPdfAMetadataField] of string = (
    'Title', 'Author', 'Subject', 'Keywords',
    'Creator', 'Producer', 'CreationDate', 'ModDate');
  StateNames: array[TPdfAMetadataState] of string = (
    'not required', 'equivalent', 'XMP missing', 'XMP type mismatch',
    'value mismatch', 'invalid Info date', 'invalid XMP date');

procedure ReportMetadata(Pdf: TPdf);
var
  Report: TPdfAMetadataReport;
  Item: TPdfAMetadataComparison;
begin
  Report := Pdf.InspectPdfAMetadata;
  if Report.XmpParseError <> '' then
    Writeln('XMP packet unreadable: ', Report.XmpParseError)
  else if not Report.HasXmpPacket then
    Writeln('No XMP packet at all');
  for Item in Report.Comparisons do
    if not Item.IsEquivalent then
      Writeln(Format('%-12s %-18s Info="%s" XMP="%s"',
        [FieldNames[Item.Field], StateNames[Item.State],
         Item.InfoValue, Item.XmpValue]));
end;
Що міняє NormalizePdfAMetadata і чого він відмовляється?
TPdf.NormalizePdfAMetadata трактує словник Info як джерело істини і переписує лише ті властивості XMP, чиї поля потрапили в MismatchFields; все інше в пакеті виживає. Title і Subject пишуться в елемент x-default, поки інші мовні альтернативи лишаються недоторканими, Author стає rdf:Seq з одним елементом, невідомі простори імен і неспоріднені властивості зберігаються, а властивості XMP для відсутніх ключів Info лишаються в спокої. Дата Info з поясом пишеться як канонічна UTC-дата XMP з суфіксом Z; дата без поясу тримає свої локальні компоненти. Перевантаження з файлом зберігає через тимчасовий файл і атомарну заміну, а саме оновлення XMP додається як інкрементальний апдейт
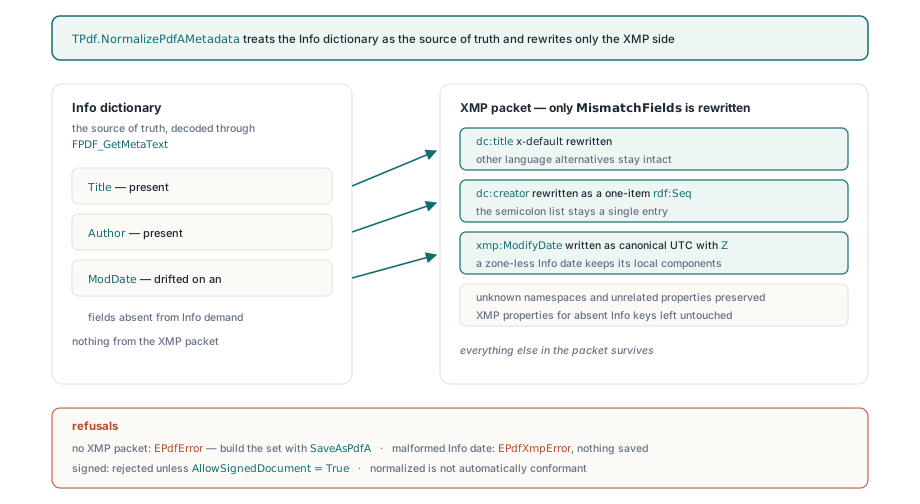
Відмови навмисні. Без XMP-пакета метод піднімає EPdfError, бо збудувати повний набір ідентифікації та метаданих PDF/A — це робота SaveAsPdfA, яку покриває створення архівних файлів PDF/A з PDFium Component. Крива дата Info піднімає EPdfXmpError замість запису правдоподібно виглядуваного неправильного значення, і нічого не зберігається. Підписані документи відхиляються, якщо викликач не передасть AllowSignedDocument = True. Еквівалентність — це лише одне правило ISO 19005-1, тож нормалізований файл не є автоматично відповідним
uses
  System.SysUtils, PDFium, FPdfPdfa, FPdfXmp;

procedure NormalizeArchive(const Source, Target: string);
var
  Pdf: TPdf;
  Report: TPdfAMetadataReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := Source;
    Pdf.Active := True;
    Report := Pdf.InspectPdfAMetadata;
    if Report.IsEquivalent then
      Exit;                      // вже узгоджено, лиши файл у спокої
    if not Report.HasXmpPacket then
      raise Exception.Create('No XMP packet: convert with SaveAsPdfA instead');
    try
      if not Pdf.NormalizePdfAMetadata(Target) then
        raise Exception.Create('Normalized save failed');
    except
      on E: EPdfXmpError do      // крива дата Info чи непарсабельний пакет
        raise Exception.CreateFmt('Cannot normalize %s: %s', [Source, E.Message]);
    end;
  finally
    Pdf.Free;
  end;
end;
Запуск порівняння на власному XMP-пакеті
ComparePdfAInfoAndXmp і SynchronizePdfAInfoToXmp — прості функції в FPdfPdfa, які працюють на TPdfXmpPacket без завантаженого документа, що пасує юніт-тестам і pipeline-ам, які збирають XMP з шаблону. Єдина пастка — Present: запис, ініціалізований через Default(TPdfAMetadataValues), має порожній набір, тоді кожне поле звітує pamsNotRequired, і порівняння проходить вакуумно, чого б ви туди не вписали
uses
  System.SysUtils, System.IOUtils, FPdfPdfa, FPdfXmp;

procedure AlignTemplate(const TemplateFile: string);
var
  Info: TPdfAMetadataValues;
  Packet: TPdfXmpPacket;
  Changed: TPdfAMetadataFields;
begin
  Info := Default(TPdfAMetadataValues);
  Info.Title := 'Quarterly Report 2026';
  Info.Author := 'Finance; Controlling';
  Info.ModDate := 'D:20260827093659+08''00''';
  // Present вирішує, які поля обов'язкові; самі значення ігноруються
  Info.Present := [pamfTitle, pamfAuthor, pamfModDate];

  Packet := TPdfXmpPacket.Parse(TFile.ReadAllText(TemplateFile, TEncoding.UTF8));
  try
    Changed := SynchronizePdfAInfoToXmp(Info, Packet);
    // xmp:ModifyDate тепер 2026-08-27T01:36:59Z, dc:creator — rdf:Seq з одним елементом
    if Changed <> [] then
      TFile.WriteAllBytes(TemplateFile, Packet.ToUtf8);
  finally
    Packet.Free;
  end;
end;
Якщо ваш pipeline архівує документи, які інші системи продовжують редагувати, пару нічного проходу InspectPdfAMetadata із NormalizePdfAMetadata для файлів, що сповзли, і тримайте ValidatePdfA як гейт перед тим, як що-небудь поїде в довгострокове сховище. Типізований звіт, шлях лагодження і решта інструментарію PDF/A їдуть у PDFium Component for Delphi and C++Builder