PDFium Component версії 3.117.0 зшиває таблицю, розірвану межею сторінки, коли або обидва фрагменти торкаються країв аркуша, або під першим фрагментом і над другим немає жодного тексту тіла документа, причому колонтитули ігноруються. ExtractDocumentTables застосовує цей тест за вмістом як альтернативу старішому тесту за відступом від краю, відкидає фрагмент на наступній сторінці, чий перший рядок — одна клітинка-підпис на всю ширину, і зберігає один рядок, який переповз на наступну сторінку, як частину свого ланцюжка продовження
Стаття про виявлення й вилучення таблиць подавала продовження як чотири строгі ворота й трактувала «торкається краю аркуша» як одні з них. Той опис був точний для релізу, який він покривав, і водночас хибний для більшості таблиць, які люди справді згодовують компоненту. Ця стаття — виправлення: на яких документах тест за відступом не працює, що його замінило і які два побічні випадки виправлення потягло за собою
Чому тест за відступом від краю аркуша не працює на експорті з Word?
Тест за відступом не працює, бо текстовий процесор припиняє розкладати рядки на нижньому відступі, а не на краю паперу. З типовим ContinuationMargin у 36 пунктів початкове правило вимагало, щоб нижній край ранішого фрагмента лежав у межах 36 пунктів від низу сторінки, а верхній край пізнішого — у межах 36 пунктів від верху сторінки. Документ, експортований із Word із його типовими дюймовими полями, ставить останній рядок щонайменше за 72 пункти над низом сторінки, а з колонтитулом — ще вище, тож умова ніколи не виконувалася. Кожна довга таблиця в такому документі поверталася як незалежні фрагменти з ContinuationGroup рівним нулю, і виклик знову мав зшивати все вручну. Тест усе ще має сенс для того, під що його проєктували: звіти, які генерують рушії верстки, що заповнюють сторінку до фіксованого контентного блока й починають наступну сторінку впритул до верху. Це не погане правило, це неповне правило, саме тому версія 3.117.0 зберегла його й додала другий шлях замість того, щоб замінити
Що натомість перевіряє тест за вмістом?
Тест за вмістом перевіряє, чи займає простір між двома фрагментами щось, крім таблиці, користуючись прямокутниками слів на кожній сторінці, а не геометрією сторінки. Проходячи документ, ExtractDocumentTables запам'ятовує для кожної сторінки найнижчий нижній край будь-якого слова, чий верх лежить над смугою колонтитула, і найвищий верхній край будь-якого слова, чий низ лежить під смугою верхнього колонтитула. Обидві смуги завглибшки ContinuationMargin пунктів, тож та сама опція тепер відіграє подвійну роль — запасу від краю сторінки й висоти зон колонтитулів. Пара фрагментів проходить, коли нижній край ранішого лежить на рівні найнижчого тексту тіла на його сторінці або нижче, а верхній край пізнішого — на рівні найвищого тексту тіла на наступній сторінці або вище, кожен у межах AlignmentTolerance. Простими словами: таблиця була останнім на сторінці N і першим на сторінці N+1, а номер сторінки чи заголовок документа у смузі колонтитула не рахуються. Це виключення не довільне. ISO 32000-1 §14.8.2.2 класифікує колонтитули як артефакти пагінації — вміст, що існує через розрив сторінки, а не всупереч йому, — і та сама ідея, яка дозволяє тегованому читачу їх пропускати, дозволяє й таблиці продовжуватися крізь них. Стаття про marked content розповідає, як теговані файли оголошують ці артефакти явно; тут класифікація виводиться з позиції, бо більшість експортованих таблиць не несе жодних тегів
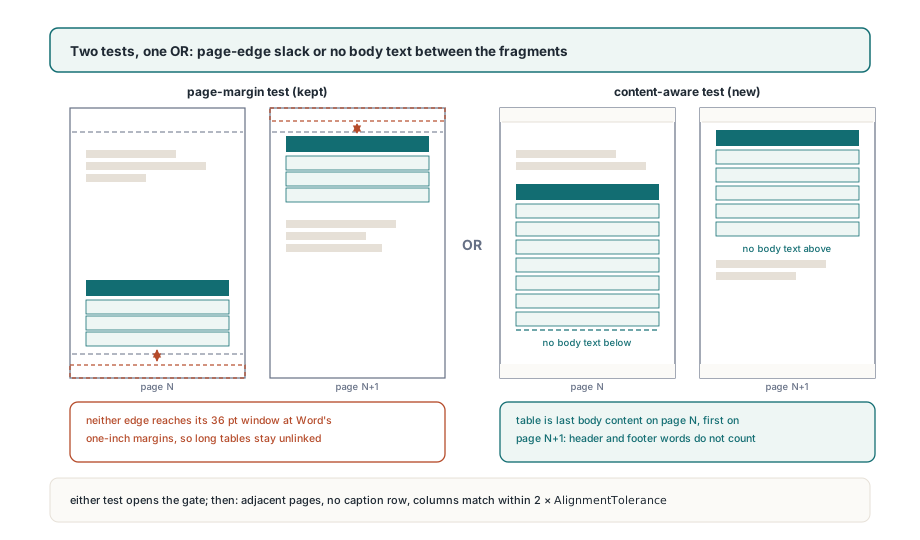
Два тести поєднуються через OR. Звіт від рушія верстки, чиї таблиці доходять до краю паперу, проходить перший; експорт із Word, чиї таблиці спиняються на відступі, проходить другий; документ, який робить і те, й те, проходить двічі. І лише після того, як один із них спрацював, виконуються решта воріт, і виконуються вони у фіксованому порядку: номери сторінок мусять бути суміжними, пізніший фрагмент не повинен відкриватися рядком-підписом, а межі колонок мусять збігатися в межах подвоєного AlignmentTolerance, тобто 6 пунктів за типових налаштувань. Перелічення — TPdfTableContinuation зі значеннями ptcNone, ptcStart, ptcMiddle і ptcEnd. Фрагмент, позначений ptcEnd, який потім зчіплюється ще з однією сторінкою, підвищується до ptcMiddle, тож таблиця на три сторінки читається як start, middle, end у порядку сторінок. Номери груп починаються з 1, а 0 означає «не зв'язано», і ToJson видає ту саму інформацію як члени continuation і continuationGroup, і саме цю форму варто обирати, якщо зшиванням займається сервіс нижче по потоку
uses
  PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;
    Options.DetectContinuations := True;     // типове значення; показано для ясності
    Options.ContinuationMargin := 54;        // колонтитул на два рядки, завглибшки ~50 пунктів

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d (%d rows)',
          [Tables[I].PageNumber, Tables[I].RowCount]));
      end;
  finally
    Pdf.Free;
  end;
end;
Як рядок-підпис заважає двом таблицям зростися?
Фрагмент на наступній сторінці, чий перший рядок — це одна клітинка на всю ширину, трактується як нова таблиця, ніколи як продовження попередньої. Це правило існує, бо тест за вмістом сам по собі зшиває надто охоче. Випадок, який його викрив, — форма у стилі стенограми: таблиця закінчується ближче до низу сторінки 1, друга таблиця з ідентичними ширинами колонок починається ближче до верху сторінки 2, між ними немає нічого, крім колонтитула, і колонки збігаються до пункта. За тестом за відступом ці дві ніколи не зустрічалися, бо жодна не торкалася краю; за тестом за вмістом вони зчепилися одразу, і форма з розділами стала однією безглуздою сіткою. Те, що їх розділяє, видно в структурі клітинок. Друга таблиця відкривається підписом розділу на кшталт «RECIPIENT INFORMATION», викладеним як одна об'єднана клітинка на всю ширину, і справжнє продовження ніколи так не робить, бо цей підпис належить таблиці, яка вже почалася на попередній сторінці. TableStartsWithCaptionRow кодує саме це: фрагмент має щонайменше дві колонки й містить клітинку з RowIndex = 0, ColumnIndex = 0 і ColumnSpan = ColumnCount. Перевірка виконується лише для пізнішого фрагмента, тож таблиця, чий власний рядок-підпис стоїть на її першій сторінці, не зачеплена; підпис — на сторінці N, і оглядається лише фрагмент зі сторінки N+1
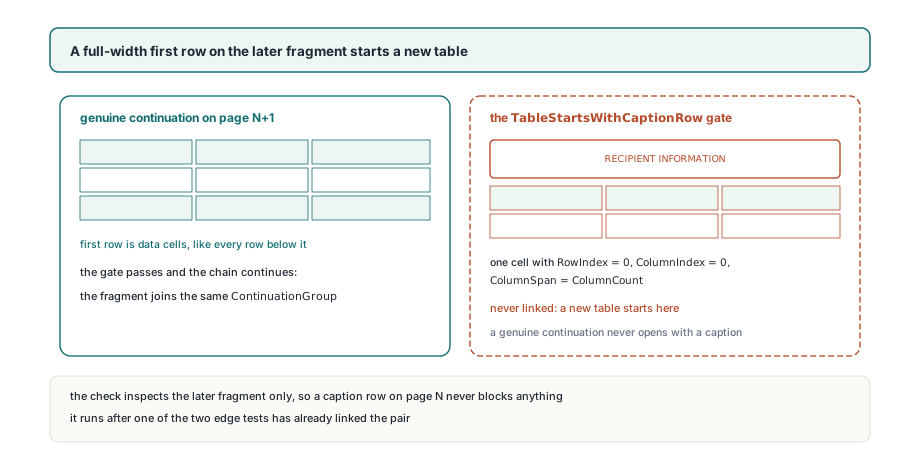
Порівняння колонок, яке йде далі, TablesHaveMatchingColumns, строгіше за «однакова кількість колонок». Воно перебудовує позиції меж кожного фрагмента з прямокутників клітинок, інтерполює межі, які ховають об'єднані клітинки, і відкидає пару, коли будь-яка межа відхиляється більше ніж на допуск. Дві таблиці на чотири колонки з різними пропорціями тому лишаються окремо, навіть коли все інше збігається
Що стається з одним рядком, який переповз на наступну сторінку?
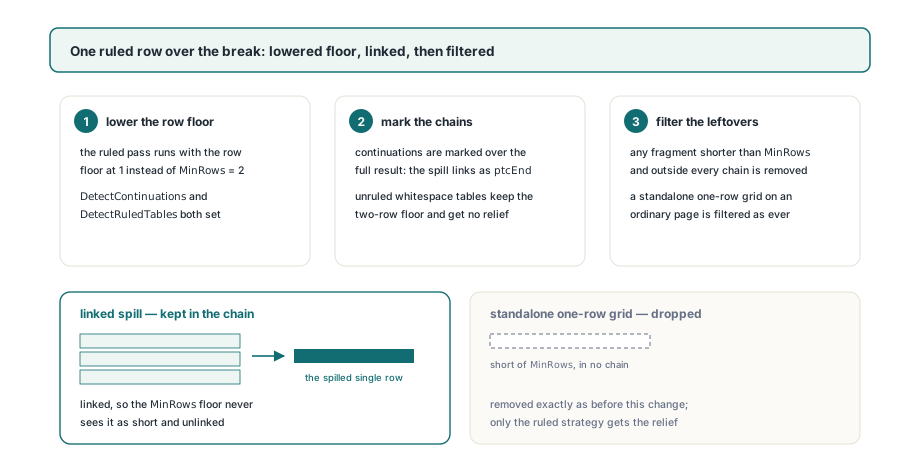
Розлінована сітка, яка несе один рядок на наступну сторінку, тепер виявляється й зчіплюється, за умови що він потрапляє в ланцюжок продовження; сам по собі він відкидається. Типове MinRows, рівне 2, існує, щоб випадкова пара ліній не повідомлялася як таблиця, але останній рядок, витиснутий за розрив, — це справжній рядок, який тверда межа в 2 мовчки викидала, і решта таблиці виглядала повною, коли вона такою не була. Сканування рівня документа обробляє це в три кроки. Коли виставлено і DetectContinuations, і DetectRuledTables, прохід по сторінці запускає детектор розлінованих таблиць із тимчасово опущеною до 1 межею рядків — саме тому ExtractTables тепер приймає MinRows 1 для розлінованих сіток, тоді як виявлення за пробілами тримає внутрішню межу 2. Продовження позначаються по всьому результату. А далі кожна таблиця, коротша за MinRows виклику й не частина жодного ланцюжка, видаляється. Однорядковий фрагмент виживає лише тому, що його зчіпили, а однорядкова сітка посеред звичайної сторінки відфільтровується точно як і раніше
// Перебудувати кожен ланцюжок як один CSV, відкидаючи повторені рядки заголовка
// на фрагментах-продовженнях
procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R: Integer;
  Lines: TStringList;
  Csv: TStringList;
begin
  Csv := TStringList.Create;
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      if Tables[I].Continuation in [ptcNone, ptcStart] then
        Csv.Clear;
      Lines.Text := string(Tables[I].ToCsv);
      if (Tables[I].Continuation in [ptcMiddle, ptcEnd]) and
         (Lines.Count > 1) and (Tables[I].RowCount > 1) then
        Lines.Delete(0);            // заголовок, повторений текстовим процесором
      for R := 0 to Lines.Count - 1 do
        Csv.Add(Lines[R]);
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Csv.SaveToFile(Format('%s\page%d-group%d.csv',
          [Folder, Tables[I].PageNumber, Tables[I].ContinuationGroup]));
    end;
  finally
    Lines.Free;
    Csv.Free;
  end;
end;
Дві деталі в цій процедурі навмисні. Однорядковий переповзок ніколи не зрізається, бо його тримає перевірка на RowCount, а текстовий процесор, який повторює рядок заголовка на кожній сторінці, дає фрагмент, чий перший рядок — знову заголовок, тож відкидання нульового рядка на середніх і кінцевих фрагментах правильне для цього випадку й хибне для генератора, який заголовків не повторює. Перевірте один документ, перш ніж пускати цю процедуру по цілій теці
Де правила все ще спиняються
Тест за вмістом добрий рівно настільки, наскільки добрий текстовий шар, який він читає. На сканованій сторінці без жодного тексту записані крайні точки тексту тіла відкочуються до меж сторінки, умова «між ними нічого» виконується порожньо, і лишаються тільки ворота рядка-підпису та колонок; розлінована сітка на такій сторінці все одно знаходиться як порожній скелет, тож ланцюжок може зчепитися правильно, але нічого про навколишній текст насправді не перевірялося. Додайте текстовий шар першим, якщо це важливо. Колонтитули, відрендерені як зображення, а не текст, невидимі для логіки смуг і нешкідливі з тієї ж причини
Смуги — це одне число. Колонтитул глибший за ContinuationMargin лишає свої нижні рядки в зоні тіла, що змушує раніший фрагмент виглядати так, ніби за ним іде текст, і блокує зв'язок; підніміть опцію до справжньої глибини смуги, як це робить перший приклад. Підніміть занадто — і короткий завершальний абзац ближче до низу сторінки прослизне в смугу й буде проігнорований, що зв'яже таблицю з тим, що йде за нею. Правило підпису має дзеркальний збій: генератор, який пише об'єднаний банер «continued» першим рядком кожного фрагмента-продовження, отримає ці фрагменти відкинутими як нові таблиці, і єдине лікування сьогодні — зшивати самому за ContinuationGroup, не послаблюючи нічого, бо в цього правила немає перемикача
Таблиці, виявлені за пробілами, не отримують жодного полегшення для однорядкового випадку. Стратегія пробілів потребує двох вирівняних рядків, щоб узагалі побачити таблицю, тож нерозлінована таблиця, яка переповзла одним рядком, усе ще повідомляється коротшою на цей рядок. Коли ви на це натрапите, прямокутники слів, що стоять за структурованими текстовими блоками й порядком читання, дадуть вам сирі позиції, щоб його повернути. На наборі зразків, що рухав цю роботу — тринадцять експортів із текстових процесорів і браузерів, — усі п'ять документів зі справжніми багатосторінковими таблицями зчепилися в єдині ланцюжки, а форма-стенограма, яка раніше зросталася, лишилася окремо, і це та планка, за якою міряли реліз, а не обіцянка про кожну верстку
Позначення продовжень, правило підпису й однорядковий прохід — усе це живе в шляху рівня документа, спільному для збірок Delphi, C++Builder і Lazarus; повний API вилучення таблиць описано на сторінці PDFium Component for Delphi