Незрячий користувач відкриває квартальний звіт у вашому блискучому новому переглядачі на Delphi, вмикає NVDA й чує нижній колонтитул сторінки, потім стовпець цифр, потім заголовок, який будь-який зрячий читач прочитав би першим. Або не чує нічого взагалі. На екрані сторінка виглядає бездоганно, і саме в цьому пастка: рендеринг і читання — різні задачі, вирішувані різним кодом. Порядок, у якому PDF малює свої гліфи, ніяк не зобов’язаний збігатися з порядком, у якому людина мала б їх почути, тож переглядач, побудований лише на викликах рендерингу, видає бездоганну картинку й непридатну до використання начитку. PDFium Component, обгортка VCL/LCL навколо рушія PDFium для Delphi, C++Builder і Lazarus, саме тому несе окремий набір API читання. API малювання не можуть відновити порядок читання, якого їм ніколи не давали
Доступний читач тримається чи падає на трьох речах. Він має видобути порядок, який зчитувач з екрана може озвучити, тримати видимий курсор слова прив’язаним до того, що зараз каже голос, і визнавати, коли документ ніколи не був тегований, замість того щоб вгадувати й вдавати. У кожної з них є чіткий API, до якого варто звернутися, і збій, що кусається, якщо пропустити деталь
Порядок читання живе в дереві структури, а не в порядку малювання
ISO 32000-1 §14.8 визначає логічну структуру як дерево елементів, накладене на вміст сторінки. PDF/UA (ISO 14289-1) йде далі й робить це дерево обов’язковим: кожен фрагмент реального вмісту має бути досяжним через нього в порядку читання, з артефактами сторінки, позначеними як такі й пропущеними. Правильно тегований звіт знає, що «Quarterly Results» — заголовок другого рівня, а сітка підсумків — таблиця з клітинками заголовків. Нетегований звіт — це купа позиційованих прогонів гліфів, що випадково виглядають як документ
ReadablePageContent обходить цю структуру, коли вона присутня, і повертає фрагменти, теговані семантичним Kind, значеннями на кшталт cfHeading і cfParagraph, тож інтерфейс може сказати «заголовок» перед словами, а не читати жирний рядок як звичайний текст тіла. Без придатного дерева той самий виклик відкочується до евристичного аналізу макета: виявляти стовпці, кластеризувати базові лінії, впорядковувати зліва направо і згори вниз. Цей запасний варіант годиться для одноколонкової записки й хиткий для інформаційного бюлетеня, багатоколонкової форми, будь-чого з боковою панеллю чи виносною цитатою. Важливо знати, який саме результат ви отримали, і API прямо про це каже. Запис TPdfReadableContent несе поле Source, встановлене в rosStructure, коли порядок походить із тегованого дерева, або rosHeuristic, коли його виведено з геометрії. Покажіть вгаданий порядок так, ніби він перевірений, і ви відвантажили версію доступності значка «пройдено» на збірці, яку ніхто не запускав
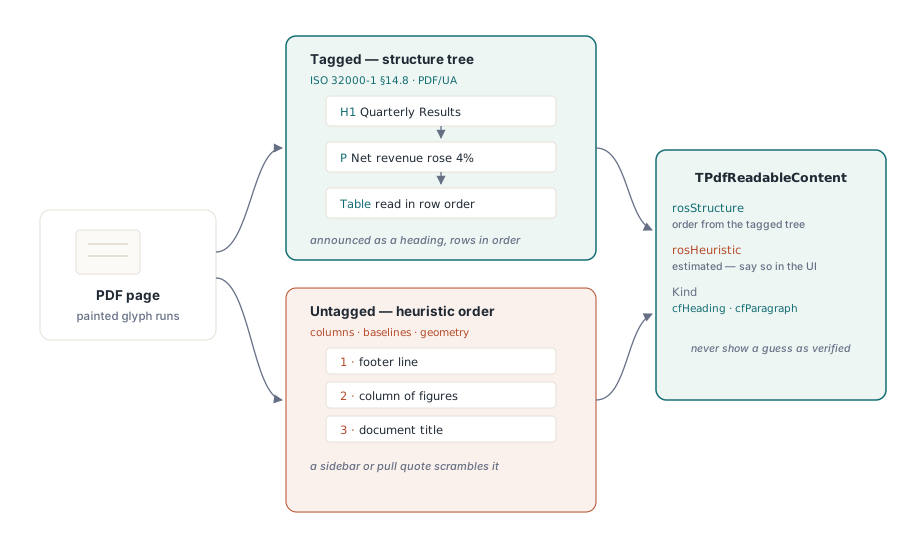
Дешевий хід під час відкриття — прочитати IsTagged і викликати ValidatePdfUa один раз, а потім кешувати відповідь. Провалена перевірка PDF/UA — не привід відмовити файлу. Це привід поставити «приблизний порядок читання» в рядок стану, щоб коли клієнт напише скаргу на сплутану начитку, підтримка вже знала б, чи дивиться вона на проблему тегування у файлі, чи на баг у вашому коді
Від сторінки до черги озвучення через ReadingUnits
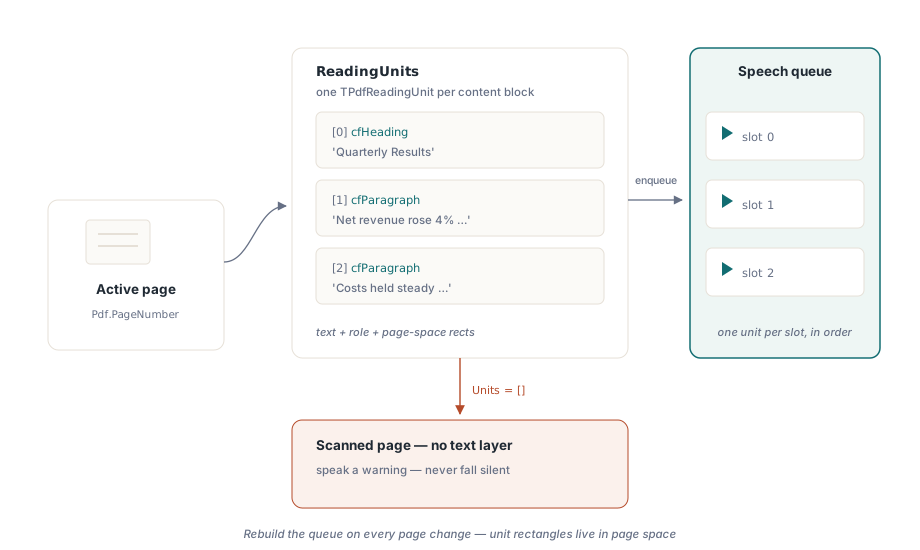
Для синтезу мовлення важку роботу виконує ReadingUnits. Він повертає масив записів TPdfReadingUnit для активної сторінки, кожен з яких тримає текст для озвучення, його семантичну роль і прямокутники, що локалізують його на сторінці. Є супутник на рівні всього документа, DocumentReadingUnits, коли вам потрібне безперервне читання через сторінки. Один запис лягає прямо в один слот черги озвучення:
procedure TReaderForm.QueuePageSpeech(PageNumber: Integer);
var
  Units: TPdfReadingUnits;
  i: Integer;
begin
  Pdf.PageNumber := PageNumber;   // ReadingUnits працює з активною сторінкою
  Units := Pdf.ReadingUnits;
  FSpeechQueue.Clear;
  for i := Low(Units) to High(Units) do
    FSpeechQueue.Add(Units[i]);  // текст + семантика + прямокутники підсвітки
  FCurrentPage := PageNumber;
  SpeakNextUnit;
end;
Дві речі в цьому циклі легко переплутати. Тримайте чергу окремою для кожної сторінки й перебудовуйте її щоразу, коли користувач переходить на іншу, бо одиниці читання несуть прямокутники в координатах сторінки; черга, що лишилася від третьої сторінки, намалює свою підсвітку на четвертій. І трактуйте порожній масив Units на сторінці, що явно має вміст, як ваш детектор «лише зображення». Скановану сторінку — це пікселі без жодного текстового шару під ними, і правильна відповідь — озвучити попередження («ця сторінка не має вилучного тексту»), а не замовкнути так, що слухач не зможе відрізнити це від зависання
Курсор слова, що йде за голосом
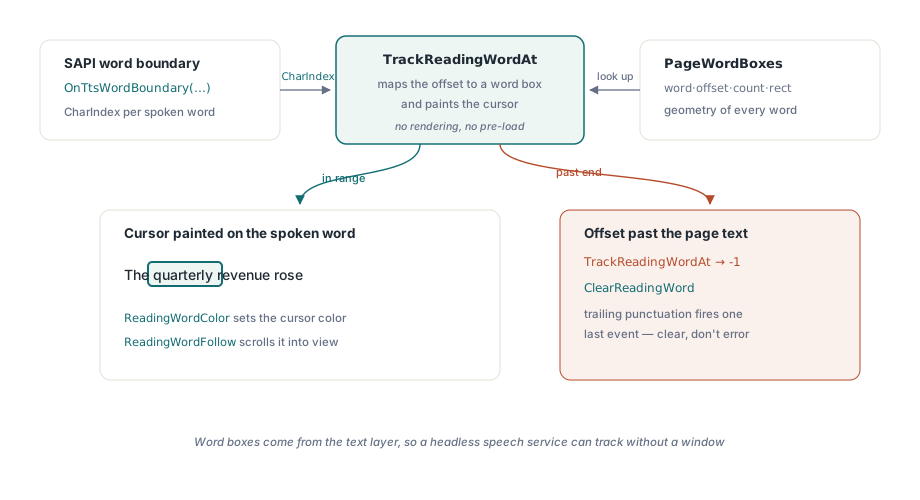
Підсвічування цілого абзацу за раз здається млявим для користувача зі слабким зором, що стежить очима за словами, поки їх читають уголос. Підсвічування на рівні слова, ефект караоке, потребує двох частин: геометрії кожного слова та способу мапувати звіти прогресу рушія TTS на цю геометрію. PageWordBoxes дає вам геометрію як записи TPdfWordBox, кожен із текстом слова, його зсувом символу, кількістю символів і прямокутником у координатах сторінки. TrackReadingWordAt дає вам мапування. Подайте йому позицію символу, яку вже повідомляє подія межі слова SAPI, і він розв’яже цей зсув в індекс у масиві блоків слів та намалює курсор на відповідному слові одним викликом
procedure TReaderForm.PrepareKaraoke(PageNumber: Integer);
begin
  // Блоки слів подання походять зі сторінки, яку показує подання
  // Самого лише встановлення Pdf.PageNumber недостатньо, щоб перемістити подання
  PdfView.PageNumber := PageNumber;
  FWordBoxes := PdfView.PageWordBoxes;
end;

procedure TReaderForm.OnTtsWordBoundary(Sender: TObject; CharIndex: Integer);
var
  WordIdx: Integer;
begin
  // TrackReadingWordAt мапує зсув І малює курсор слова
  WordIdx := PdfView.TrackReadingWordAt(FCurrentPage, CharIndex);
  if WordIdx < 0 then
    PdfView.ClearReadingWord;  // межа вийшла за текст сторінки
end;
Контракт щедрий за одним пунктом і невблаганний за іншим. Щедра частина: TrackReadingWordAt тримає власний кеш блоків слів для сторінки, яку відстежує, тож нічого не треба попередньо завантажувати, і жодного рендерингу взагалі не відбувається, бо блоки слів походять із текстового шару. Безголовий сервіс мовлення без видимого вікна все одно може відстежувати позиції. Невблаганна частина: індекс символу має вказувати в текст, який видобув компонент, а не в якийсь очищений рядок, побудований вами самостійно. Коли CharIndex виходить за кінець тексту сторінки, функція повертає -1 замість того, щоб викликати виняток, що трапляється постійно, коли рушій TTS запускає одну останню подію межі для завершальної пунктуації. Читайте -1 як «очистити курсор», ніколи як помилку
На боці відображення ReadingWordColor встановлює колір курсору. Стандартний бурштиновий добре тримається на більшості фонів сторінки, але перевірте його під кожним фільтром відображення, що пропонує ваш переглядач. Бурштиновий курсор може повністю зникнути під інверсією кольору, а інверсія, що працює одночасно з мовленням, — це рівно те, як працює користувач зі слабким зором, тож саме та комбінація, яку найбільше потрібно налаштувати правильно, — це та, яку швидка демонстрація ніколи не проганяє. Встановіть ReadingWordFollow в True, і подання саме прокрутить вимовлене слово у видиму зону, чого без цього не зробити на масштабованій сторінці, що розтягується через кілька екранів. Пам’ятайте про одне правило області дії: SetReadingWord малює лише на активній сторінці TPdfView. Вирішіть заздалегідь, чи ручна прокрутка призупиняє мовлення, чи поведінка слідування її перекриває, бо не обравши жодного, ви лишите голос читати далі, поки курсор сидить десь поза екраном
Документи, що ламають ваш читач
Жменька форм вводу надійно перемагає наївну реалізацію настільки, що заслуговують на постійне місце як зразки в наборі регресійних тестів, а не як одноразові баги, які ви виправляєте й забуваєте
- Нетеговані, але багаті на текст файли. Евристичний порядок зазвичай правильний для лінійного звіту й неправильний тієї миті, коли з’являється бокова панель чи виносна цитата. Позначайте порядок як приблизний, і в інтерфейсі, і в діагностичному логі, щоб збій був зрозумілим пізніше
- Скани лише із зображень. Жодного текстового шару взагалі. Ловіть їх через порожні одиниці читання й спрямовуйте користувача до кроку OCR вище за течією, замість того щоб дозволяти читачу начитувати порожню сторінку
- Комбіновані символи та змішані писемності. Комбіновані знаки Unicode не завжди згортаються один в один у візуальні слова, тож кількість блоків слів може розходитися з тим, що очікує ваш власний токенізатор. Не індексуйте масив блоків слів зсувами, які ви обчислили, самостійно розбиваючи текст; використовуйте лише індекси, які повертає
TrackReadingWordAt
Тестуйте це як аудитор, а не як демонстрацію
«Воно прочитало мій зразок уголос» нічого не доводить. Прохід, який можна захистити, проганяє три файли крізь готову збірку з підключеним NVDA: один відомо тегований файл, де заголовки оголошуються як заголовки, а таблиця читається в порядку рядків; один відомо нетегований файл, де видимий індикатор приблизного порядку; і скан, де попередження про відсутність тексту справді озвучується. Кожен з них проганяє шлях, який щасливий випадок пропускає
Далі підтвердьте, що курсор слова лишається замкненим на подвійній швидкості мовлення й на половинній, і що прокрутка ReadingWordFollow не бореться з власною прокруткою користувача. Потім запустіть мовлення, поки перемикаєте кожен кольоровий фільтр, і стежте, щоб курсор ніколи не зникав. Стаття про кольорові фільтри для слабкого зору детально розглядає цей шлях рендерингу, а поглиблений розбір курсору мовлення слова розбирає таймінг TTS
API одиниць читання й блоків слів, використані вище, постачаються з PDFium Component для Delphi та C++Builder (VCL) і Lazarus/FPC (LCL). Сторінка продукту містить посилання на повний довідник API, включно з розкладками записів для одиниць читання й блоків слів, що стоять за цими прикладами