Наберіть =NORM.DIST(115,100,15,TRUE) у комірці - і Excel без церемоній поверне 0.8413447. Виклик читається як пошук у таблиці. Це не так. За цим одним числом стоїть кумулятивний нормальний розподіл, інтеграл без замкненої форми, а за CHISQ.INV.RT та BETA.DIST сидять спеціальні функції, які акуратна бібліотека має обчислювати, а не наближати на око. Компонент електронних таблиць, що претендує на сумісність з Excel, має відтворювати ці значення до останньої цифри, яку показує Excel, а це означає відтворювати числові методи, а не лише назви функцій
HotXLS реалізує понад п'ятдесят таких статистичних функцій, і робота, яка робить їх правильними, майже цілком невидима з рядка формул. Це екскурсія тим, як рушій їх обчислює: спільне ядро спеціальних функцій, рішення про гілки, що тримають арифметику стабільною, і одна вада в оберненому нормальному розподілі, яка довго ховалася у хвості, бо поширений випадок ніколи не зачіпав зламаний рядок
Один виклик на аркуші, п'ятдесят розподілів за ним
Ці функції охоплюють ті родини, до яких тягнеться статистична робоча книга. Є нормальна родина, NORM.DIST та NORM.S.DIST зі своїми оберненими; родина гамми й хі-квадрат, GAMMA.DIST, CHISQ.DIST, CHISQ.DIST.RT, CHISQ.INV.RT; родина бети, BETA.DIST та BETA.INV; вибіркові розподіли T.DIST, T.DIST.2T, F.DIST та F.INV; дискретна пара BINOM.DIST і POISSON.DIST; а також помічники для висновків, як-от CONFIDENCE.T та CONFIDENCE.NORM. З місця викликача кожна з них є однією формулою. Ви задаєте входи в комірках, просите робочу книгу обчислити й читаєте результат
var
  wb: IXLSWorkbook;
  sh: IXLSWorksheet;
begin
  wb := TXLSWorkbook.Create;
  sh := wb.Sheets.Add;
  sh.Range['A1', 'A1'].Value := 115;   // спостереження
  sh.Range['A2', 'A2'].Value := 100;   // середнє
  sh.Range['A3', 'A3'].Value := 15;    // стандартне відхилення

  // Парсер формул XLS уживає ';' як роздільник аргументів.
  Writeln(wb.Calculate('=NORM.DIST(A1;A2;A3;TRUE())'));   // 0.8413447
  Writeln(wb.Calculate('=CHISQ.INV.RT(0.05;10)'));        // 18.3070381
  Writeln(wb.Calculate('=BETA.DIST(0.5;2;3;TRUE())'));    // 0.6875
end;
Метод Calculate на робочій книзі компілює й обчислює разову формулу проти живого аркуша й повертає Variant. Одна деталь спотикає людей із першої спроби: парсер формул за Calculate бере крапку з комою як роздільник аргументів, тож пишеться =SUM(A1;B1), а не =SUM(A1,B1). Збережені формули комірок зберігають стандартну для Excel кому. Той самий обчислювач диспетчеризує кожну статистичну функцію нижче, тож щойно одна з них працює в Calculate, решта йдуть тим самим шляхом
Дві функції, на яких побудовано все інше
Більшість кумулятивних розподілів у цьому наборі обчислюються не підсумовуванням чи інтегруванням власних означень. Вони обчислюються з двох спеціальних функцій: регуляризованої нижньої неповної гамми, яку пишуть як P(a, x), і регуляризованої неповної бети, яку пишуть як Ix(a, b). Усередині це ті помічники, на які спираються диспетчери, і ланцюжок короткий. CDF хі-квадрат є CDF гамми з формою df/2 і масштабом 2. CDF гамми є P(a, x) напряму. Кумулятивні функції t, F і біноміальна всі є значеннями регуляризованої неповної бети за відповідних аргументів. CDF Пуассона є верхньою неповною гаммою Q. Реалізуйте функції гамми й бети добре - і дюжина розподілів безкоштовно успадкує їхню точність
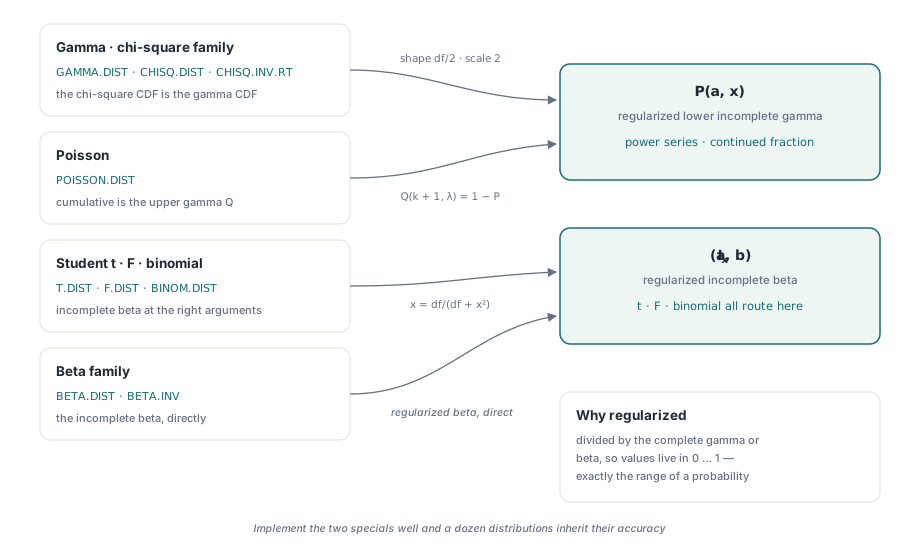
Слово "регуляризована" тут і є всією суттю. Сира неповна гамма росте як факторіал, а сирий інтеграл бети може втратити порядок вниз або вгору задовго до того, як це станеться з відповіддю. Регуляризовані форми поділені на повну гамму чи бету, тож вони живуть цілком в інтервалі від нуля до одиниці, а це рівно той діапазон, який займає ймовірність. Саме ця нормалізація дозволяє одній процедурі обслуговувати хі-квадрат із двома ступенями свободи й із двомастами так, щоб проміжні члени не збігали за межі double. Це також пояснює, чому CDF не обчислюють, додаючи довгий хвіст членів густини: кожен член несе власну похибку округлення, похибки накопичуються, доки ряд біжить, а регуляризована спеціальна функція взагалі оминає суму, обчислюючи натомість швидко збіжний ряд або ланцюговий дріб
Ряд під діагоналлю, ланцюговий дріб над нею
Процедура неповної гамми ухвалює одне рішення до того, як щось обчислити: вона порівнює x із a + 1. Ця межа не є довільною. Розклад P(a, x) у степеневий ряд збігається швидко, коли x малий відносно a, і повільно, зрештою марно, коли x великий. Ланцюговий дріб має протилежну вдачу. Тож рушій уживає степеневий ряд для x нижче a + 1 і ланцюговий дріб за Лентцом для x на рівні a + 1 чи вище, і кожну гілку просять робити лише ту роботу, у якій вона добра
Ланцюговому дробу потрібна одна охорона. Метод Лентца працює, ведучи поточний чисельник і знаменник і обертаючи знаменник на кожному кроці, а якщо будь-який із них наблизиться до нуля, обертання вибухає. Ліками є крихітна підлога: щойно проміжний член падає за модулем нижче приблизно 1e-30, його затискають до 1e-30, і це тримає рекурентність скінченною, не збурюючи збіжного значення. Той самий затиск з тієї самої причини є в ланцюговому дробі для неповної бети. Це маленька константа, що виконує несучу роботу, різниця між стабільним обчисленням і діленням на щось невідрізненне від нуля
Верхній хвіст, Q(a, x), є просто 1 мінус P(a, x), і саме так обчислюється кумулятивна гілка Пуассона: ймовірність щонайбільше k подій із середнім λ дорівнює Q(k + 1, λ). Проведення її через верхню неповну гамму замість підсумовування k + 1 членів Пуассона є, знову ж таки, вибором обчислити один збіжний вираз замість накопичення багатьох дрібних
Дискретні маси без переповнення факторіалів
Дискретні розподіли ставлять іншу небезпеку. Біноміальна маса ймовірності містить біноміальний коефіцієнт, а коефіцієнт для "п'ятдесят два по двадцять шість" є величезним цілим числом. Утворіть його напряму - і чисельник переповнить double ще до ділення, яке повернуло б його до розумної ймовірності. Рушій ніколи його не утворює. Він обчислює факторіали в логарифмічному просторі через функцію логарифма гамми, додає й віднімає логарифми, вплітає логарифми ймовірностей успіху й невдачі й підносить до експоненти один раз у самому кінці
// Біноміальна маса ймовірності, обчислена цілком у логарифмічному просторі.
// LnGammaF(n+1) є ln(n!); три логарифмічні факторіали утворюють ln(C(n,k)),
// і весь показник будується до єдиного виклику Exp.
//   ln P(X=k) = ln(n!) - ln(k!) - ln((n-k)!) + k*ln(p) + (n-k)*ln(1-p)
result := Exp(LnGammaF(nt + 1) - LnGammaF(kk + 1) - LnGammaF(nt - kk + 1)
  + kk * Ln(pp) + (nt - kk) * Ln(1 - pp));
Сама функція логарифма гамми є наближенням Ланцоша, точним по всій додатній осі й дешевим в обчисленні. Оскільки кожна велика величина тримається як її логарифм аж до фінального Exp, найбільшим числом, яке процедура взагалі матеріалізує, є сама ймовірність, а вона щонайбільше дорівнює одиниці. Функція маси Пуассона йде тим самим рецептом, де єдиний член із логарифмом гамми заступає факторіал у знаменнику. Замкнені форми обробляються окремо на краях, де p дорівнює точно нулю чи одиниці, тож код ніколи не викликає Ln(0). HotXLS повертає 0.2460938 для BINOM.DIST(5,10,0.5,FALSE) і 0.6766764 для кумулятивного POISSON.DIST(2,2,TRUE), збігаючись з Excel у всіх цифрах, які той друкує
Обернені функції через охоплення прямої кривої
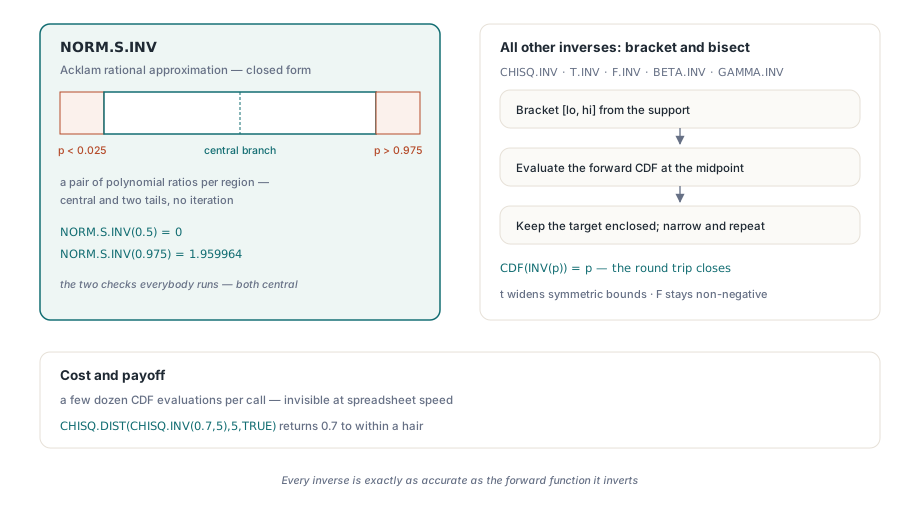
Обернена функція розподілу ставить протилежне питання: за даною ймовірністю знайти те значення, чия CDF їй дорівнює. Лише одна обернена в цьому наборі має швидку пряму формулу. NORM.S.INV, обернений стандартний нормальний розподіл, уживає раціональне наближення Аклама, пару відношень поліномів, точних приблизно до точності double по всьому діапазону, поділеному на центральну ділянку й два хвости. Це обчислення в замкненій формі без жодної ітерації
Інші обернені такої формули не мають, тож рушій обертає їх чисельно. Він охоплює відповідь нижньою й верхньою межами, обраними з носія розподілу, а потім ділить навпіл: обчислює пряму CDF у середині, зсуває ту межу, яка тримає цільову ймовірність усередині, і повторює, доки інтервал не стане вузьким. Для обернених гамми й хі-квадрат охоплення починається з нуля та щедрої верхньої оцінки, побудованої з форми й масштабу, а верхня межа подвоюється, якщо ймовірність ще не охоплена. Обернена t охоплює симетричні межі, що розходяться назовні; обернена F ділить навпіл на невід'ємному інтервалі. Ціною є кілька десятків обчислень CDF на виклик, що на швидкості електронних таблиць непомітно, а вигодою є те, що кожна обернена є рівно настільки точною, як і пряма функція, яку вона обертає. Саме тому повний цикл на кшталт CHISQ.DIST(CHISQ.INV(0.7,5),5,TRUE) повертає 0.7 з точністю до волосини
Десятковий логарифм, що сховався у хвості
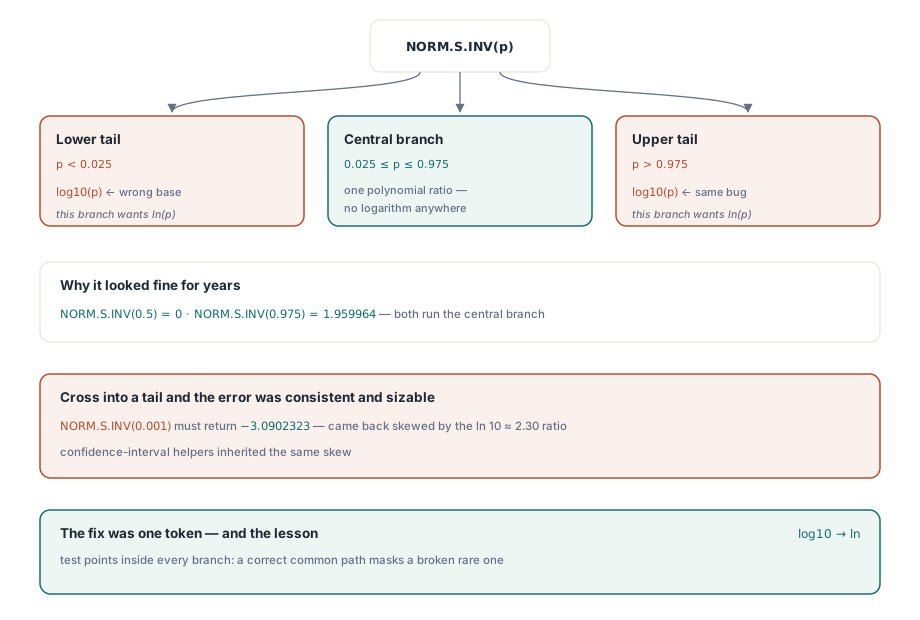
Ось вада, про яку варто розповісти, бо вона з тих, що живуть довго. Процедура оберненого нормального за Акламом має три гілки. Широка центральна гілка, яку вживають щоразу, коли ймовірність лежить приблизно між 0.025 та 0.975, проганяє вхід через відношення поліномів, де логарифма немає ніде. Дві хвостові гілки, для дуже малих чи дуже великих ймовірностей, кожна спершу бере логарифм входу, бо хвіст поводиться як корінь квадратний із мінус натурального логарифма p
Рання версія хвостової гілки брала десятковий логарифм там, де мав бути натуральний. Ці два різняться сталим множником близько 2.30, тож результати у хвості були неправильними на постійну помітну величину. І все ж функція виглядала нормально в кожній побіжній перевірці, бо побіжні перевірки живуть посередині. NORM.S.INV(0.5) дорівнює нулю, NORM.S.INV(0.975) дорівнює підручниковим 1.959964, і обидва проходять через центральний поліном, який взагалі не викликає логарифма. Похибка з'являлася лише тоді, коли ймовірність переходила у хвіст, скажімо NORM.S.INV(0.001), який має повертати -3.0902323, а натомість повертався зсунутим саме на відношення натурального логарифма до десяткового. Будь-яка функція, що залежить від оберненого нормального у своєму хвості, включно з помічниками для довірчих інтервалів, успадкувала той самий перекіс. Урок буденний і дорогий: функції з гіллястою структурою потрібні тестові точки всередині кожної гілки, бо правильний поширений шлях залюбки замаскує зламаний рідкісний. Виправлення було зміною одного токена з десяткового логарифма на натуральний, і значення у хвостах клацнули на значення Excel
Знак x вирішує, який хвіст у розподілу t
Кумулятивна функція t Стьюдента несе тонкість, у якій легко помилитися навпаки. Її значення походить із регуляризованої неповної бети, обчисленої в df / (df + x²), але це значення бети є ймовірністю у хвості за модулем x, а не кумулятивною ймовірністю до x. Симетрична форма розподілу t означає, що перетворення залежить від того, з якого боку від нуля лежить x
// CDF t Стьюдента. ib є регуляризованою неповною бетою в df/(df+x*x),
// яка міряє симетричний хвіст. Кумулятивне значення залежить від
// знака x; повернення ib без перетворення дає не той хвіст.
ib := BetaIF(df / 2, 0.5, df / (df + x * x));
if x > 0 then
  result := 1 - 0.5 * ib        // вище середнього: одиниця мінус пів хвоста
else if x < 0 then
  result := 0.5 * ib            // нижче середнього: пів хвоста
else
  result := 0.5;                // точно на середньому
Для x понад нуль кумулятивна ймовірність дорівнює одиниці мінус половина симетричного хвоста; для x нижче нуля вона дорівнює половині цього хвоста; у нулі вона дорівнює точно половині. Поверніть значення бети напряму - і ви звітуєте не про той бік розподілу, помиляючись на все тіло кривої для будь-якого ненульового x. Правохвостовий і двохвостовий варіанти будуються на тій самій гілці, і саме тому T.DIST.2T(1,1) повертається як 0.5, а T.DIST(1,1,TRUE) як 0.75, а обернена T.INV ділить навпіл проти цієї виправленої CDF, тож повний цикл сходиться
Нічого з цього не видно з комірки, і це задуманий результат. Ви пишете формулу й читаєте число, яке узгоджується з Excel. Якщо ви розширюєте рушій власною логікою, механіку реєстрації функції розглянуто в нашому огляді рушія формул та власних функцій, а те, як формули сягають через аркуші та іменовані діапазони, розглянуто в статті про визначені імена та формули між аркушами. Усе це постачається всередині HotXLS Delphi spreadsheet component для Delphi та C++Builder поряд з API читання, запису, побудови діаграм і форматування, розглянутими в інших матеріалах цього блогу