HotXLS Delphi Component обчислює =1<2<3 як FALSE — та сама відповідь, що й у Excel 16, — бо від v2.384.3 його парсер формул згортає оператори порівняння зліва направо: 1<2 стає TRUE, а TRUE<3 — це FALSE, бо boolean стоїть вище за будь-яке число. Той самий реліз робить порожній операнд рівним і 0, і "", і дозволяє SUMIF розтягнути діапазон суми з однієї комірки до форми діапазону критеріїв. Кожне з цього виглядає як дрібниця, поки книга, обчислена в Delphi, не почне розходитися з тією самою книгою, відкритою в Excel
Розбіжність зазвичай починається з формули, яку людина написала з інтуїції. Хтось вводить =0<B2<100, щоб перевірити, що кількість у діапазоні, Excel тихо відповідає FALSE на кожному рядку, і аркуш їде далі із запеченим багом. Обчислювальний рушій не має права виправляти намір користувача; його робота — видати значення, яке видав би Excel, щоб кешований результат, який HotXLS пише у файл, збігався з тим, що Excel показує після перерахунку. До v2.384.3 HotXLS відповідав TRUE на ту перевірку діапазону на кожному рядку — неправильно у протилежний бік, і звіт, згенерований на сервері, суперечив би тому самому звіту, відкритому на десктопі
Чому =1<2<3 повертає FALSE в Excel?
Excel повертає FALSE, бо читає ланцюжок порівнянь як (1<2)<3, і внутрішній TRUE тоді програває конкурс типового ранжування проти числа 3. Старий парсер HotXLS читав той самий текст як 1<(2<3): TXLSSyntax.Parse_expr у lxFormula.pas парсив один операнд, бачив токен порівняння і рекурсивно заходив у Parse_expr для правої сторони, що робить оператор правоасоціативним. Це дає 1<TRUE, а число нижче за boolean, тож результат був TRUE. Помилка симетрична: =3>2>1 — TRUE в Excel і був FALSE у HotXLS, а =1=1=TRUE — TRUE в Excel і був FALSE до виправлення. Регресійний тест CalculateFormula_ComparisonChainsFoldLeftToRight пришпилює сім таких формул до значень, які повертає Excel 16, і ганяє кожну через обидві архітектури рушія, класичний TXLSWorkbook і XLSX-натівний TXLSXWorkbook, використовуючи метод Calculate, описаний в огляді обчислювального рушія формул HotXLS
const
  Formulas: array [0..6] of string = ('=1<2<3', '=3>2>1', '=(1<2)<3',
    '=1<(2<3)', '=1=1=TRUE', '=3>2>1=TRUE', '=1<2<3=FALSE');
  // Що повертає Excel 16:  FALSE, TRUE, FALSE, TRUE, TRUE, TRUE, TRUE
var
  Classic: IXLSWorkbook;
  Xlsx: TXLSXWorkbook;
  i: Integer;
begin
  Classic := TXLSWorkbook.Create;
  Xlsx := TXLSXWorkbook.Create;
  try
    // TXLSXWorkbook.Calculate обчислює відносно активного аркуша і
    // повертає Null, коли в книзі взагалі немає жодного аркуша
    Xlsx.Sheets.Add('Data');
    for i := 0 to High(Formulas) do
      Writeln(Formulas[i], '  classic=', VarToStr(Classic.Calculate(Formulas[i])),
        '  xlsx=', VarToStr(Xlsx.Calculate(Formulas[i])));
  finally
    Xlsx.Free;
  end;
end;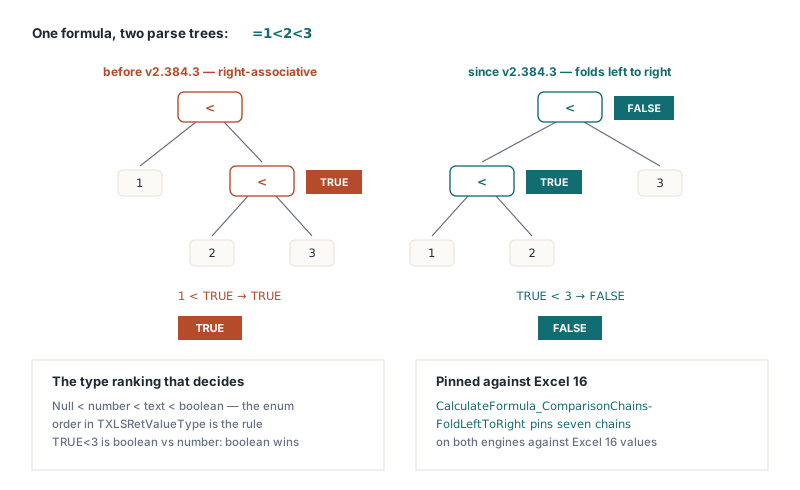
Виправлення перетворює Parse_expr на цикл тієї самої форми, яку Parse_expr1 уже використовує для +, - і &. Він парсить перший операнд через Parse_expr1, і поки наступний токен — один із =, <>, <, >, <= чи >=, створює вузол порівняння, причіплює накопичений лівий результат як першу дитину, парсить наступний операнд через Parse_expr1, а не Parse_expr, і робить новий вузол лівим результатом наступного кола. Дві деталі легко зіпсувати при конвертації рекурсії в ітерацію, і обидві є в нотатках супровідників: накопичений вузол треба передати (lChild := Item; Item := nil) саме в такому порядку, а шлях помилки мусить Exit після звільнення напівзбудованого вузла, а не випадати з циклу й повертати висяче дерево
Як HotXLS ранжує числа, текст і boolean у порівнянні?
HotXLS ранжує змішані типи так, як Excel: кожне число менше за будь-яке текстове значення, а будь-яке текстове значення менше за будь-який boolean. TXLSCalculator.CompareVariants у lxCalc.pas класифікує обидва операнди через GetRetValueType в енумерацію TXLSRetValueType = (xlVariantValue, xlNumberValue, xlStringValue, xlBooleanValue), і коли два класи різні, просто порівнює їхні ординали, тож порядок оголошення того enum — це правило міжтипового порівняння. Усередині одного класу порівняння натуральне, з одним Excel-специфічним завитом для тексту: обидва рядки спершу проходять через lxUpperCase, тож ="abc"="ABC" — TRUE. Це ранжування — причина, чому результат ланцюжка не можна осмислити без нього. TRUE<3 — не приведення TRUE до 1, а boolean, порівняний із числом, і boolean перемагає. Дати для рушія — серійні числа (varDate класифікується як xlNumberValue), тож дата завжди нижча за будь-який текст, зокрема текст, який випадково виглядає як дата
Чому дорівнює порожня комірка в порівнянні?
Порожня комірка як операнд порівняння дорівнює 0, коли інший бік — число, дорівнює "", коли інший бік — текст, і від v2.384.53 дорівнює FALSE, коли інший бік — логічне значення, тож із порожньою A1 =A1=0, =A1="" і =A1=FALSE — усе TRUE. TXLSCalculator.CompareVarValues, який обслуговує всі шість операторів порівняння, підставляє порожнє перед викликом CompareVariants: якщо рівно один операнд — Null, він стає WideString(''), коли партнер — рядок, False, коли партнер — boolean, і 0 в інших випадках. Дві порожні комірки досі порівнюються як рівні одна одній без підстановки. Арифметичний шлях завжди перетворював порожнє на 0, тому =A1+1 давав 1, але CompareVariants тримав Null як власний найнижчий ранг, нижче за будь-яке число, і оператори порівняння брали той ранг напряму
var
  Wb: IXLSWorkbook;
  Sh: TXLSWorksheet;
begin
  Wb := TXLSWorkbook.Create;
  Sh := Wb.Sheets.Add;
  Sh.Range['B1', 'B1'].Value := 5;      // A1 навмисно лишена порожньою

  Writeln(VarToStr(Wb.Calculate('=A1=0')));    // True
  Writeln(VarToStr(Wb.Calculate('=A1=""')));   // True
  Writeln(VarToStr(Wb.Calculate('=A1<B1')));   // True: порожнє порівнюється як 0
  Writeln(VarToStr(Wb.Calculate('=A1<0')));    // False; True до v2.384.3
end;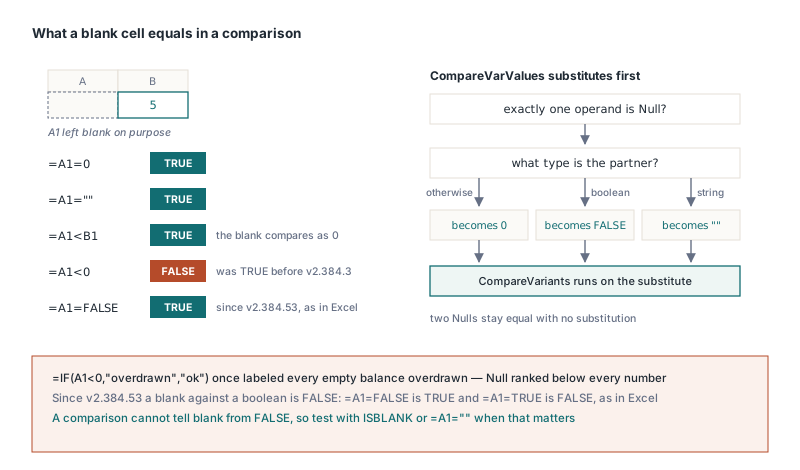
Останній рядок — той, що кусався на практиці. За старим рангом порожнє було менше за будь-яке число, включно з від'ємними, тож =IF(A1<0,"overdrawn","ok") позначав кожну порожню комірку балансу як овердрафт, а =A1=0 було FALSE для комірки, яку будь-який користувач описав би як нуль. Один кордон лишався після v2.384.3: підстановка обирала лише між 0 і порожнім рядком, тож порожнє, порівняне з boolean, ставало 0, що рангується нижче за і TRUE, і FALSE, і =A1=FALSE на порожній A1 обчислювався як FALSE. Від HotXLS 2.384.53 порожнє, порівняне з логічним значенням, трактується як FALSE в обох рушіях, XLS і XLSX, як і в Excel: з порожньою A1 =A1=FALSE і =A1<TRUE повертають TRUE, а =A1=TRUE повертає FALSE. Це також означає, що порівняння не відрізнить порожнє від FALSE — ані в Excel, ані в HotXLS; коли аркушу потрібна та відмінність, тестуйте через ISBLANK або =A1=""
Чому SUMIF з однокомірковим діапазоном суми повертав 0?
SUMIF повертав 0, бо HotXLS затискав ітерацію до меншого з двох діапазонів, тоді як Excel тримає форму діапазону критеріїв, а від діапазону суми бере лише його верхню ліву комірку. =SUMIF(A1:A10,">5",B1) отже означає B1:B10 в Excel — зручність, на яку спирається чимало шаблонів, зібраних руками. Спільний працівник TXLSCalculator.GetValueItemRange2 стискав свої рахунки рядків і колонок до рахунків діапазону значень, що зводило приклад до одного тесту A1 проти B1. v2.384.3 знімає затиск: цикл тепер обходить діапазон критеріїв і читає кожне значення на тому самому зсуві від верхнього лівого кута діапазону суми. Оскільки CalcSumIF і CalcAverageIF обидва викликають того працівника, AVERAGEIF отримує той самий ресайз, а діапазон суми, більший за діапазон критеріїв, підрізається до форми критеріїв з тієї ж причини. Аргумент критерію посередині — аргумент класу значень, а два зовнішні — класу посилань; та відмінність розібрана в статті про implicit intersection і класи аргументів
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  Row: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Sales');
    for Row := 1 to 10 do
    begin
      Sheet.Cells[Row, 1].Value := Row;          // колонка критеріїв: 1..10
      Sheet.Cells[Row, 2].Value := Row * 100;    // суми: 100..1000
    end;
    Sheet.Cells[1, 4].Formula := '=SUMIF(A1:A10,">5",B1)';     // діапазон суми з однієї комірки
    Sheet.Cells[2, 4].Formula := '=SUMIF(A1:A10,">5",B1:B10)'; // явний діапазон суми
    if Book.Recalculate = lxOk then
      // Обидва D1 і D2 — 4000 (600+700+800+900+1000); D1 був 0 до v2.384.3
      Writeln(VarToStr(Sheet.Cells[1, 4].Value), ' ', VarToStr(Sheet.Cells[2, 4].Value));
  finally
    Book.Free;
  end;
end;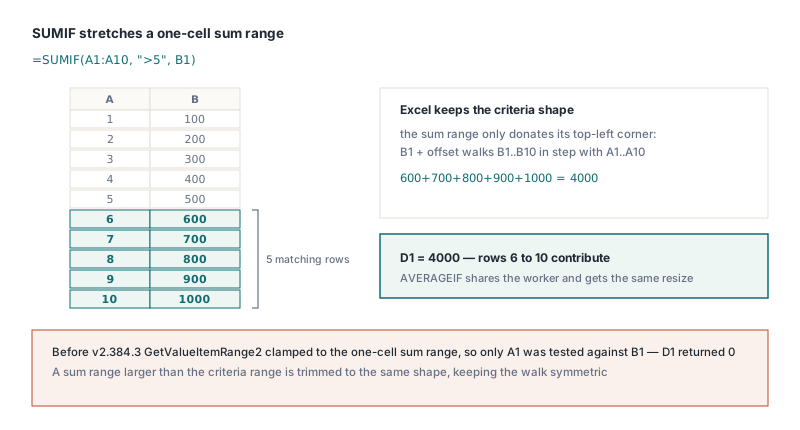
INDIRECT і YEARFRAC: дві тихіші поправки
INDIRECT тепер поважає свій другий аргумент, а текст після валідного посилання — помилка, замість ігнорування. З a1 FALSE текст парситься як абсолютний R1C1, тож =INDIRECT("R2C3",FALSE) читає C2; старий код ігнорував прапорець, читав "R2" як колонку R, рядок 2, і тихо повертав неправильну комірку. Прапорець диспетчеризується за його variant-типом (boolean, число чи текст), бо конвертація рядкового variant напряму в Double підіймає виняток. Відносний текст R1C1 на кшталт R[1]C[1] повертає #REF!, бо INDIRECT не має початку формульної комірки, щодо якої його можна розв'язати, а текст A1 із хвостовими символами, "B2 junk", теж повертає #REF!. YEARFRAC з базисом 0 тепер застосовує правила NASD «останнього дня лютого», які DAYS360 уже реалізував: коли обидві дати — останній день лютого, кінцевий день стає 30, а тоді старт на останньому дні лютого теж стає 30. Від 2024-02-29 до 2025-02-28 рахунок тепер 360 днів — дріб рівно 1, тоді як попередній Days360US рахував 359
Що гарантують ці виправлення, і який із них урок?
Поведінка ланцюжків порівнянь гарантована тестом, який порівнює обидва рушії зі значеннями, знятими з Excel 16, і той тест існує тому, що перший опис виправлення був неправильним. Примітка релізу v2.384.3 спершу казала, що згортання зліва направо робить =1<2<3 рівним TRUE — рівно те, що видавав старий правоасоціативний парсер, і протилежне тому, що повертають і Excel, і новий код. Ніхто не обчислив приклад; його написали з інтуїції, що «1 менше за 2, що менше за 3». Примітку виправили, а тест із сімома формулами додали в наступному commit, і правило, що з нього вийшло, стосується будь-кого, хто документує семантику електронних таблиць: прогоніть приклад в Excel, перш ніж записати очікуване значення. Підстановка порожнього операнда і ресайз SUMIF слідують тій самій поведінці Excel, зокрема випадок порожнє-проти-boolean від v2.384.53, а умовні агрегати, яким треба ще й пропускати відфільтровані чи приховані рядки, слідують окремим правилам із статті про приховані рядки в SUBTOTAL і AGGREGATE
HotXLS — нативний компонент електронних таблиць для Delphi і C++Builder, який читає, перераховує і пише XLS, XLSX, ODS і CSV без установленого Excel, а правила порівняння, порожнього і SUMIF, описані тут, живуть в обчислювальному рушії, спільному для обох архітектур книг. Повний список функцій і варіанти ліцензування — на сторінці продукту компонент електронних таблиць HotXLS для Delphi