HotPDF ганяє Tesseract усередині вашого Delphi-процесу через HPDFCreateTesseractDLLOCREngine — фабрику, додану в v2.772.0, яка динамічно завантажує сумісний із Tesseract 5 DLL, веде його C API (TessBaseAPIInit2, TessBaseAPIRecognize, result iterator) і повертає IHPDFOCREngine. THotPDF.ApplyLoadedOCRTextLayer користується тим рушієм, щоб додати невидимий, пошуковий Unicode-текстовий шар до відсканованих сторінок PDF
Той самий розпізнавач уже був досяжний через зовнішній адаптер tesseract.exe, який пише BMP і розбирає TSV. Той шлях працює, але кожна сторінка платить за старт процесу, тимчасовий бітмап-файл і текстовий формат без базових ліній і без керування сегментацією сторінки. Виклик DLL прибирає всі три. Він також прибирає процесну стіну, а отже Pascal-біндинг лежить просто поверх C-структур, C-булів та C-виділених рядків. Більша частина того, що варто знати про цей адаптер, — це те, де той біндинг може тихо збитися
Як ганяти Tesseract у процесі з Delphi через HotPDF?
Запуск Tesseract у процесі з HotPDF — це один виклик фабрики в юніті HPDFTesseractRecognition і той самий виклик ApplyLoadedOCRTextLayer, яким користується кожен OCR-рушій HotPDF. Фабрика валідує завзято. Файл DLL і директорія tessdata мусять існувати, ідентифікатор мови може містити лише ASCII-літери, цифри, _ і +, кожна модель у комбінації на кшталт chi_sim+eng мусить мати відповідний файл .traineddata, і всі обов'язкові експорти — їх 21 — мусять розрізнятися, перш ніж рушій буде повернено. Помилки конфігурації піднімають EArgumentException; DLL, що не завантажився, піднімає EOSError з кодом помилки Windows і підказкою перевірити архітектуру та залежності
uses
  SysUtils, HPDFDoc, HPDFTesseractRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Програмі Win64 потрібен 64-бітовий DLL; DLL-залежності кладуться поруч
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract-5.dll',
    'C:\OCR\tessdata', 'chi_sim+eng');   // THPDFTesseractOptions.Default
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;   // 300 DPI, MinimumConfidence 0.5
    // Порожній список сторінок означає всі; сторінки з наявним текстом пропускаються
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' words accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFTesseractOptions.Default ставить PageSegMode у tpsAuto, EngineMode у temDefault, TimeoutMilliseconds у 60 000 і MaxPixels у 16 777 216. Піксельний бюджет важить більше, ніж здається. Сторінка US Letter при усталених 300 DPI рендериться в 2 550 × 3 300 пікселів, зо 8,4 мільйона, — що вміщується. Та сама сторінка при 600 DPI — це 5 100 × 6 600, зо 33,7 мільйона, і адаптер відхиляє її до того, як Tesseract побачить хоч один піксель. Піднімайте MaxPixels (стеля — 67 108 864) чи тримайте DPI на місці; кожен бік також обмежений 32 767 пікселями
DLL завантажується через LoadLibraryEx з прапорцями пошуку для власної папки DLL плюс усталених безпечних директорій, тож бібліотеки зображень, від яких залежить Tesseract, можуть жити поруч із ним без доторку до PATH чи поточної директорії. HotPDF не комплектує і не завантажує жодного OCR-runtime чи моделі; і те, й інше постачаєте ви
Що змінюється порівняно з адаптером tesseract.exe?
DLL-адаптер торгує ізоляцією процесу за багатший вихід і менші накладні на сторінку. Обидва адаптери встромляються в той самий конвеєр текстового шару, тож мапінг координат, фільтрування за впевненістю та коміт все-або-нічого ідентичні; відрізняється те, як пікселі входять і слова виходять
| Аспект | Адаптер tesseract.exe | Адаптер Tesseract DLL |
|---|---|---|
| Фабрика | HPDFCreateTesseractOCREngine | HPDFCreateTesseractDLLOCREngine |
| Пікселі на вході | BMP-файл у приватній тимчасовій директорії | 8-бітовий сірий буфер у пам'яті |
| Слова на виході | TSV на рівні слів, обмежений 64 МіБ | Result iterator, UTF-8 на слово |
| Базові лінії | Недоступні | Передаються з TessPageIteratorBaseline |
| Сегментація сторінки і режим рушія | Лише автоматична сегментація | THPDFTesseractPageSegMode, THPDFTesseractEngineMode |
| Таймаут | Жорсткий: дочірній процес завершується | Кооперативний: Tesseract мусить помітити |
| Ізоляція падінь і пам'яті | Окремий процес | Немає, ділить ваш адресний простір |
Одна ціна не зникає. Кожен виклик Recognize створює власний екземпляр API і викликає TessBaseAPIInit2, тож мовні моделі ініціалізуються на сторінку, а не один раз на рушій. Файловий кеш операційної системи пом'якшує перевантаження, але на великих багатомовних наборах моделей це досі домінантна фіксована ціна за сторінку, і вона лічиться проти дедлайну розпізнавання. Рушій RapidOCR DLL у процесі бере протилежну конструкцію і тримає свої ONNX-моделі резидентними впродовж життя рушія; граничні проблеми (C ABI, позичені буфери, переривана нативна робота) — та сама родина
Чому Delphi не може скопіювати структуру монітора Tesseract?
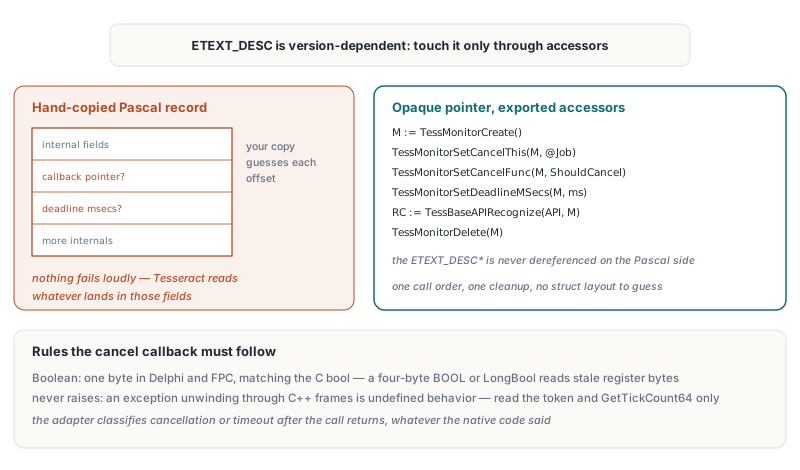
Delphi не може безпечно дзеркалити монітор поступу Tesseract, бо ETEXT_DESC містить залежні від версії внутрішні поля, тож рукописний запис кладе cancel-callback і дедлайн на неправильні зміщення на деяких збірках. Ніщо не падає гучно, коли таке стається. Tesseract просто читає ваш вказівник на callback із поля, що тепер тримає щось інше, чи взагалі ніколи не бачить дедлайну
Тому HotPDF трактує монітор як непрозорий вказівник і торкається його лише через експортовані функції: TessMonitorCreate, TessMonitorSetCancelThis, TessMonitorSetCancelFunc, TessMonitorSetDeadlineMSecs і TessMonitorDelete. Якщо ви біндите C API самі для іншої цілі, той самий шаблон застосовний. Ескіз нижче — ваш власний біндинговий код, а не HotPDF API, і дзеркалить оголошення, які HotPDF внутрішньо користує
type
  // C: typedef bool (*TessCancelFunc)(void *cancel_this, int words);
  TTessCancelFunc = function(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
  TTessMonitorCreate = function: Pointer; cdecl;   // ETEXT_DESC*, ніколи не розіменовується
  TTessMonitorDelete = procedure(Monitor: Pointer); cdecl;
  TTessMonitorSetCancelFunc = procedure(Monitor: Pointer; Func: TTessCancelFunc); cdecl;
  TTessMonitorSetCancelThis = procedure(Monitor, CancelThis: Pointer); cdecl;
  TTessMonitorSetDeadlineMSecs = procedure(Monitor: Pointer; MSecs: Integer); cdecl;
  TTessBaseAPIRecognize = function(Handle, Monitor: Pointer): Integer; cdecl;

  TOCRJob = record
    CancelRequested: Boolean;
    DeadlineTick: UInt64;
  end;
  POCRJob = ^TOCRJob;

function ShouldCancel(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
begin
  // Ганяється на стеку Tesseract: читайте прапорці та годинник, ніколи не піднімайте
  Result := (CancelThis = nil) or POCRJob(CancelThis)^.CancelRequested or
    (GetTickCount64 >= POCRJob(CancelThis)^.DeadlineTick);
end;

// Використання, з вказівниками на функції, розрізненими через GetProcAddress:
//   Monitor := MonitorCreate();
//   try
//     MonitorSetCancelThis(Monitor, @Job);
//     MonitorSetCancelFunc(Monitor, ShouldCancel);
//     MonitorSetDeadlineMSecs(Monitor, RemainingMs);
//     RC := BaseAPIRecognize(API, Monitor);
//   finally
//     MonitorDelete(Monitor);
//   end;
Дві деталі в тому ескізі — навмисні. Callback повертає Boolean, який в обох Delphi та Free Pascal є одним байтом, збігаючись із C bool у TessCancelFunc. Чотирибайтовий Windows BOOL чи Delphi LongBool виглядає взаємозамінним і не є: коли один бік пише один байт, а інший читає чотири, старші бати регістра повернення — це те, що там лишилося, і false може прибути як true. Той самий заголовок ще й ускладнює справу, бо функції на кшталт TessPageIteratorBoundingBox повертають int, який HotPDF оголошує як Integer. Читайте C-тип кожного значення, що повертається, замість того щоб припускати одну угоду для всього API
Друга деталь — callback ніколи не піднімає. Delphi-виняток, що розкручується крізь C++-кадри Tesseract, — невизначена поведінка, тож callback HotPDF лише читає токен скасування та монотонне значення GetTickCount64. Адаптер перетворює результат на діагностику скасування чи таймауту після повернення TessBaseAPIRecognize, і виконує ту перевірку незалежно від нативного коду повернення
Які нативні вказівники володіє Delphi-бік?
Адаптер Tesseract DLL у HotPDF володіє трьома нативними об'єктами на запит — екземпляром API, монітором і result iterator — і позичає все інше. Кожен виклик Recognize створює власний набір і звільняє його в блоці finally: TessResultIteratorDelete, потім TessMonitorDelete, потім TessBaseAPIDelete. Звільнення інтерфейсу рушія вивантажує бібліотеку
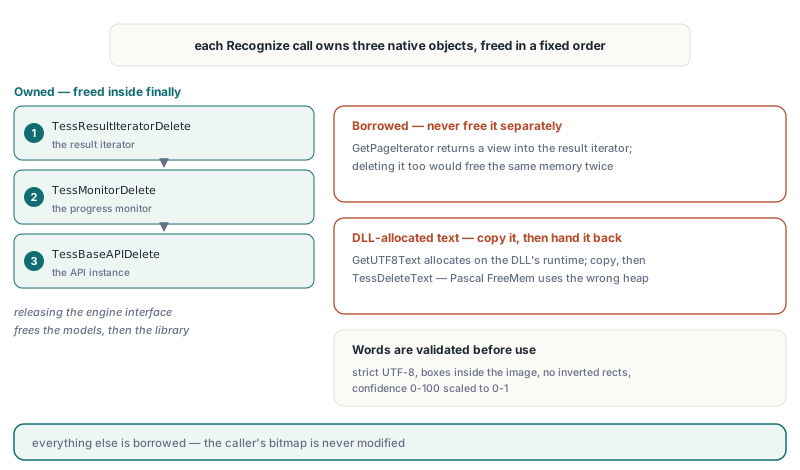
TessResultIteratorGetPageIteratorповертає позичений вигляд у result iterator, а не новий об'єкт. HotPDF користується ним дляTessPageIteratorBoundingBoxіTessPageIteratorBaselineі ніколи його не звільняє; окреме видалення звільнило б ту саму пам'ять двічіTessResultIteratorGetUTF8Textповертає рядок, виділений власним runtime DLL. HotPDF копіює його і повертає черезTessDeleteTextу блоціfinally; Pascal-івFreeMemзвільнив би його на неправильній купі- Текст слова декодується зі строгою UTF-8-валідацією і перевіркою довжини перед конверсією. Слова з керувальними символами, деформованим UTF-8, боксами поза зображенням, перевернутими прямокутниками чи впевненістю поза 0–100 валять запит замість того, щоб тихо лагодитися
- Сумарний текст на запит обмежений 1 048 576 UTF-16-одиницями, а кількість слів мусить вміщуватися в бюджет запиту, спущений з
ApplyLoadedOCRTextLayer
Впевненість приходить як 0–100 і масштабується до 0–1, тож THPDFOCRTextLayerOptions.MinimumConfidence означає те саме для кожного рушія. Коли Tesseract звітує базову лінію, обидва кінці передаються; інакше конвеєр текстового шару падає назад на свій геометричний оціночний, точно як для TSV-входу
Чому валідувати enum до того, як він досягне DLL?
HotPDF копіює сирий порядковий номер PageSegMode і EngineMode в Integer перед перевіркою діапазону, бо компілятор може припустити, що enum-змінна завжди тримає оголошене значення, і згорнути Ord(X) > Ord(High(T)) у константу false. Порядкові номери — не прикраса: THPDFTesseractPageSegMode слідує нумерації сегментації сторінок Tesseract від 0 до 13, THPDFTesseractEngineMode слідує нумерації режимів рушія від 0 до 3, і обидва йдуть у DLL як голі цілі. Запис опцій, збудований через FillChar, заповнений зі стріму чи переданий з C++Builder із кастовим цілим, може нести байт на кшталт 200. Валідація скопійованого порядкового перетворює те на EArgumentException в час фабрики замість невизначеного режиму всередині нативного коду. Фабрика також відхиляє tpsOSDOnly і tpsAutoOnly, які не породжують слів, і вимагає osd.traineddata для tpsAutoOSD і tpsSparseTextOSD
Що насправді гарантує таймаут розпізнавання?
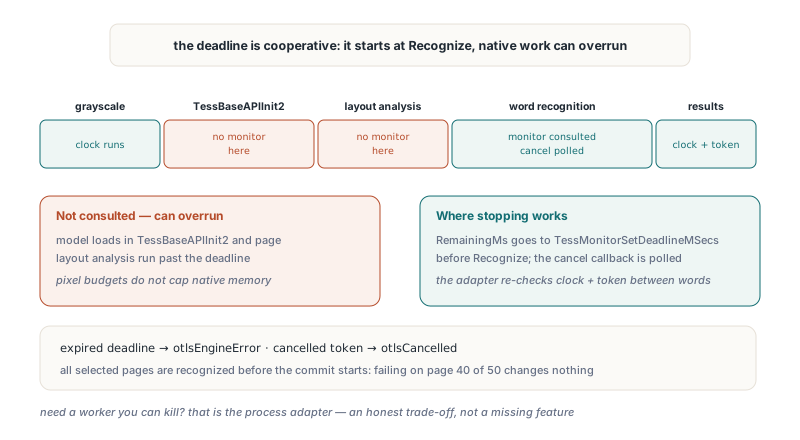
Таймаут Tesseract DLL кооперативний: HotPDF може зупинити власну роботу і попросити Tesseract зупинитися, але не може змусити нативний код повернутися. Годинник стартує, коли Recognize починається, тож конверсія бітмапа та ініціалізація моделей споживають той самий бюджет, що й розпізнавання. HotPDF перевіряє минулий час і токен скасування під час сірої конверсії та між словами при ітерації результатів, і передає решту мілісекунд у TessMonitorSetDeadlineMSecs перед викликом TessBaseAPIRecognize
Проміжок — усередині нативного виклику. Монітор Tesseract консультується під час розпізнавання слів, а не під час TessBaseAPIInit2 чи аналізу компонування сторінки, тож повільне завантаження моделі чи патологічне компонування можуть пробігти за дедлайн до того, як таймаут буде звітовано. Піксельний і вихідний бюджети також не обмежують власне споживання пам'яті нативною бібліотекою. Якщо потрібен робітник, якого можна вбити, — користуйтеся процесним адаптером; це чесний компроміс, а не відсутня можливість
Сегментація сторінок — це те, де DLL-адаптер відбиває свій хліб на складному вводі. Форми, етикетки та відскановані таблиці з розсіяними полями часто розпізнаються краще з tpsSparseText, ніж з автоматичною сегментацією, яка намагається зібрати колонки та абзаци, яких там немає
procedure OCRFormPages(Doc: THotPDF; const Pages: array of Integer);
var
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  LayerOptions: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default;
  TessOptions.PageSegMode := tpsSparseText;  // розсіяні поля, без збирання колонок
  TessOptions.EngineMode := temLSTMOnly;     // потребує LSTM-моделей у tessdata
  TessOptions.TimeoutMilliseconds := 20000;  // включає ініціалізацію моделей
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract-5.dll',
    'C:\OCR\tessdata', 'eng+deu', TessOptions);

  LayerOptions := THPDFOCRTextLayerOptions.Default;
  LayerOptions.MinimumConfidence := 0.6;
  if not Doc.ApplyLoadedOCRTextLayer(Pages, Engine, LayerOptions, Info) then
    case Info.Status of
      otlsCancelled:
        Writeln('OCR cancelled, document unchanged');
      otlsEngineError:
        Writeln('Tesseract failed or timed out: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
Таймаут виринає як otlsEngineError з діагностикою Tesseract DLL OCR timed out, тоді як скасований токен виринає як otlsCancelled. В обох випадках ApplyLoadedOCRTextLayer розпізнав кожну вибрану сторінку до старту коміт-транзакції, тож невдача на сторінці 40 з 50 лишає завантажений документ точно таким, яким він був. Зауважте, що tpsSingleLine, tpsSingleBlock і tpsSparseText змінюють лише сегментацію; жоден з них не випрямляє перекошений скан
Free Pascal і Lazarus: застарілі пікселі та загублена китайська
Обидві Tesseract-фабрики працюють у Windows Free Pascal і Lazarus Win32 та Win64 збірках з v2.772.1, після двох специфічних для FPC виправлень. Спершу перезберіть Lazarus-пакет для цільової архітектури; загальний порт покритий у HotPDF на Free Pascal і Lazarus Win64
Перше виправлення стосується пікселів. LCL TBitmap, записаний через scanlines, може оновити сите зображення без освіження Windows-хендла бітмапа, тож GetDIBits на тому хендлі повертає старі пікселі. Симптом був незбагненний: текст, намальований просто на бітмап, розпізнавався, тоді як сторінка, відрендерена PDF-рендерером HotPDF, породжувала порожній список слів. На FPC адаптер тепер читає форматно-обізнаний знімок через CreateIntfImage, який шанує піксельний формат та порядок рядків ситого зображення. Delphi-збірка тримає шлях GetDIBits на приватній 24-бітовій копії. Жодна збірка не модифікує бітмап викликача
Друге виправлення належить адаптеру tesseract.exe. TStringList у FPC зберігає ANSI-рядки, тож присвоєння декодованого UTF-8 TSV-тексту в Lines.Text тихо скидало кожен китайський чи додатково-площинний символ, який системна ANSI-кодова сторінка не могла репрезентувати. FPC-шлях тепер тримає TSV як UTF-8-байти, прибирає BOM на байтовому рівні і декодує кожне слово в UnicodeString поодинці. DLL-адаптер ніколи не мав тієї проблеми, бо декодує кожне слово просто з iterator
Шпаргалка
- Фабрика:
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language[, Options])уHPDFTesseractRecognition, додана у v2.772.0, підтримка FPC у v2.772.1 - Усталення:
tpsAuto,temDefault, 60 000 мс, 16 777 216 пікселів; діапазон таймауту 1–3 600 000 мс, піксельна стеля 67 108 864 - Підбирайте розрядність DLL до програми і кладіть DLL-залежності поруч із Tesseract DLL
- Трактуйте монітор як непрозорий; ніколи не копіюйте
ETEXT_DESCу Pascal-запис - Оголошуйте cancel-callback як
cdeclз однобайтовим результатомBooleanі ніколи не дозволяйте винятку тікати з нього - Звільняйте текст iterator через
TessDeleteText; ніколи не звільняйте page iterator, отриманий з result iterator - Очікуйте, що дедлайн кооперативний: ініціалізація моделей та аналіз компонування можуть його перебігти
- Користуйтеся адаптером tesseract.exe, коли потрібне жорстке завершення чи ізоляція падінь
Адаптер Tesseract DLL, процесні адаптери та вбудований OCR-рушій постачаються разом із компонентом HotPDF Delphi PDF для Delphi, C++Builder і Free Pascal; видання і завантаження — на сторінці продукту HotPDF