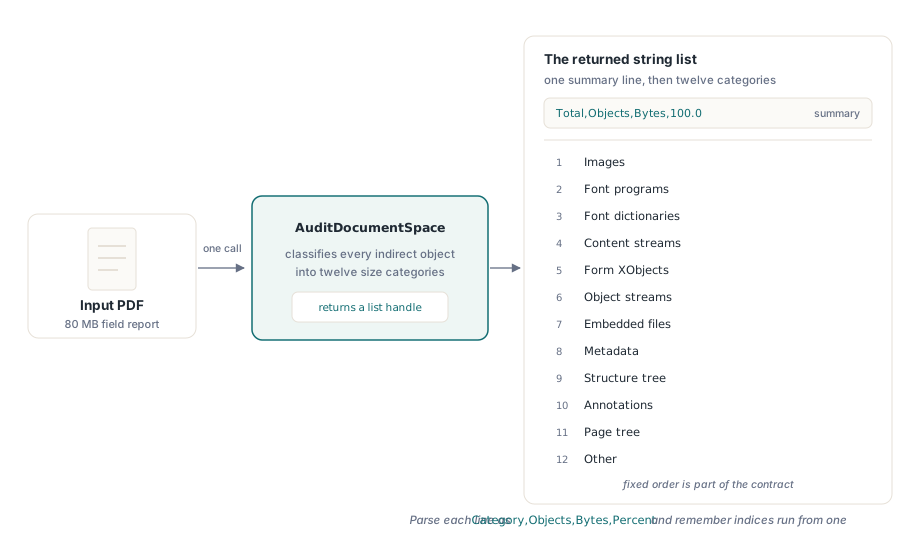
Щоб з'ясувати, куди насправді йде розмір PDF-файлу, losLab PDF Library надає AuditDocumentSpace, яка класифікує кожен непрямий об'єкт у дванадцять категорій — зображення, програми шрифтів, словники шрифтів, потоки вмісту, форми XObject, потоки об'єктів, вбудовані файли, метадані, дерево структури, анотації, дерево сторінок, інше — і повідомляє кількість об'єктів, збережені байти та відсоткову частку кожної
Ситуація, для якої це існує, знайома. 40-сторінковий звіт виходить із вашого генератора на 80 МБ, клієнт запитує чому, а все, що ви можете запропонувати, — це здогадка. Ймовірно, зображення. Можливо, шрифти. Тож ви вмикаєте зменшення роздільності, надсилаєте — і файл виходить на 74 МБ, бо реальна вага була зовсім деінде. Наша супутня стаття про субсетування шрифтів і зменшення роздільності зображень охоплює, як зменшити PDF; ця стаття охоплює крок, який має йти першим, — вимірювання того, що ви збираєтесь зменшувати
Чому вимірювати перед стисканням?
Тому що три стандартні проходи оптимізації дають абсолютно різну віддачу на будь-якому конкретному файлі, і ніщо у файлі не підкаже, який із них застосовний, доки ви не порахуєте. Субсетування шрифтів у документі, чиї шрифти вже становлять 2% його байтів, — це витрачений на пересування похибки округлення день. Зменшення роздільності зображень у файлі, чия маса — нестиснуті потоки вмісту, дає таке саме розчарування. Оптимізатор — не складна частина; він є в кожній бібліотеці. Знати, який оптимізатор спрямувати на цей файл, — ось складна частина, і це питання обліку, а не стискання. Аудит також ловить випадки, коли жоден оптимізатор не є відповіддю: файл, що виявляється на 60% вбудованими вкладеннями, потребує не кращого стискання, а розмови про те, чи ці вкладення взагалі мають бути в документі, а файл, що на 30% складається з дерева структури, платить за розмітку доступності, що зазвичай є свідомою витратою, яку не слід тихо відрізати. Щойно байти атрибутовано, ви приймаєте продуктове рішення з цифрами за спиною, а не тягнетесь до найближчого перемикача
Що містить звіт з дванадцяти категорій
AuditDocumentSpace повертає дескриптор списку рядків, а не запис, тож звіт переживає плоскі фасади DLL та COM незмінним. Список містить підсумковий рядок Total,Objects,Bytes,100.0, за яким слідує рівно дванадцять рядків Category,Objects,Bytes,Percent у фіксованому порядку, що є частиною контракту: Images, Font programs, Font dictionaries, Content streams, Form XObjects, Object streams, Embedded files, Metadata, Structure tree, Annotations, Page tree, Other. Тринадцять рядків, завжди, навіть коли якась категорія порожня
var
  Lib: TPDFlib;
  ListID, I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('report.pdf', '') <> 1 then
      Exit;
    ListID := Lib.AuditDocumentSpace;   // 0, коли документ не вибрано
    if ListID = 0 then
      Exit;
    try
      // GetStringListItem з відліком від 1: елементи йдуть 1..GetStringListCount
      for I := 1 to Lib.GetStringListCount(ListID) do
        Memo1.Lines.Add(Lib.GetStringListItem(ListID, I));
    finally
      Lib.ReleaseStringList(ListID);
    end;
  finally
    Lib.Free;
  end;
end;
Одна деталь Delphi у цьому циклі вкусить рівно один раз. GetStringListItem використовує індекси елементів з відліком від одиниці, узгоджено з GetStringListCount, а індекс поза діапазоном повертає порожній рядок замість того, щоб піднімати виняток. Напишіть цикл for I := 0 to Count - 1 за звичкою — і отримаєте порожній перший рядок, тихо втрачений останній рядок і жодного винятку ніде, що вкаже на неправильну індексацію. Сам звіт виглядатиме майже правильно, а це найгірший режим відмови, який може мати діагностичний інструмент
Чому аудит використовує збережену довжину замість декодованого розміру?
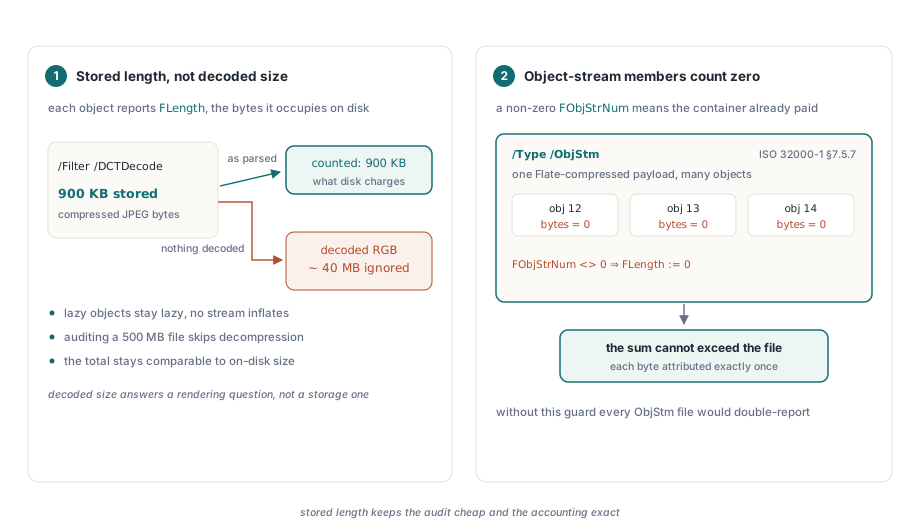
Тому що збережена довжина — це і те число, яке потрібне, і те число, яке дешево отримати. Кожен непрямий об'єкт несе TPDFIndObj.FLength, сиру довжину в байтах, яку об'єкт займає у файлі в тому вигляді, в якому його розібрано. Використання її означає, що зображення DCTDecode на 900 КБ звітується як 900 КБ — байти, у які воно вам обходиться на диску — а не 40 МБ семплів RGB, у які воно декодується. Це також означає, що аудит ніколи не потребує нічого декодувати: ліниво завантажені об'єкти залишаються лінивими, фільтри залишаються незапущеними, а аудит файлу на 500 МБ — це прохід по заголовках об'єктів, а не повний цикл декомпресії
Друге правило — захист від подвійного підрахунку. Коли об'єкт живе всередині стисненого потоку об'єктів, на що вказує ненульовий FObjStrNum, його кількість байтів записується як нуль. За його зберігання вже сплачено один раз потоком-контейнером, який ISO 32000-1 §7.5.7 визначає як потік /Type /ObjStm, що містить багато об'єктів в одному Flate-стисненому корисному навантаженні. Нарахування кожному учаснику власної частки, а потім повторне нарахування самого контейнера роздуло б підсумок понад реальний розмір файлу. Це має прямий наслідок для того, як ви читаєте вивід, розглянуто нижче й глибше в нашій статті про потоки об'єктів і потоки перехресних посилань
Чому програма шрифту не може класифікувати сама себе?
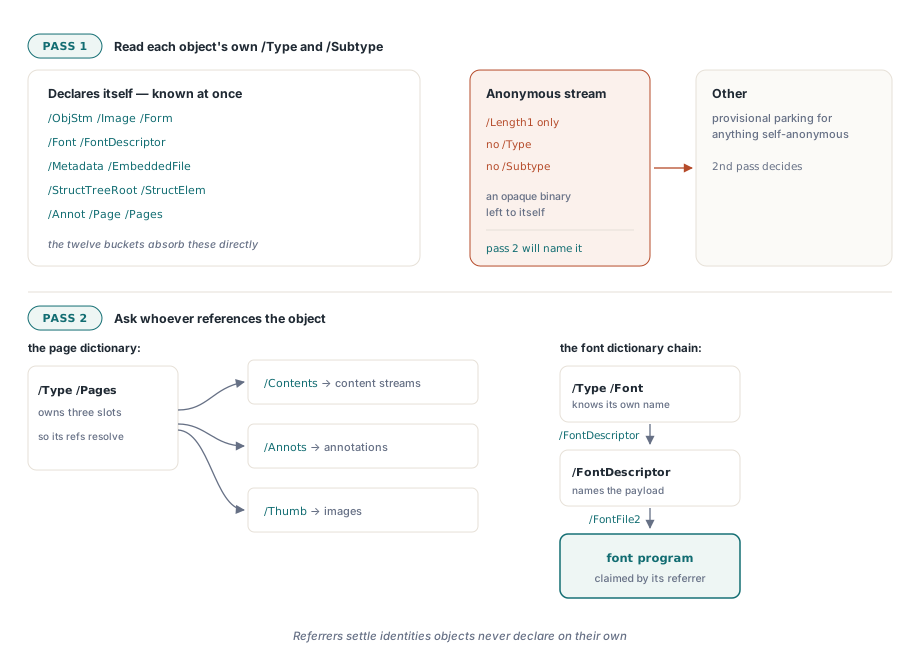
Тому що файл шрифту TrueType, вбудований у PDF, не має маркера, який би про це повідомляв. ISO 32000-1 §9.8.1 визначає вбудовану програму шрифту як значення /FontFile, /FontFile2 або /FontFile3 у дескрипторі шрифту, а словник потоку на іншому кінці цього посилання несе ключі /Length1 та фільтрів, але не /Type і не /Subtype, що ідентифікує його як шрифт. Розглянутий окремо, це анонімний бінарний потік. Лише дескриптор, що на нього вказує, знає, що це таке. Та сама асиметрія проявляється для анотацій: §12.5.2 робить /Type /Annot опційним у словнику анотації, тож надійним сигналом є членство в масиві /Annots сторінки, а не сам словник
Тому класифікація проходить двічі. Перший прохід читає власні /Type та /Subtype кожного об'єкта і бере легкі перемоги: /ObjStm, /Subtype /Image, /Subtype /Form, /Type /Font та /Type /FontDescriptor, /Metadata, /EmbeddedFile та /Filespec, /StructTreeRoot та /StructElem, /Annot, /Page та /Pages. Усе інше умовно потрапляє в Other. Другий прохід тоді обходить сторону посилань і перевизначає: кожен словник сторінки перепризначає свій /Contents потокам вмісту, свої записи /Annots анотаціям, а свій /Thumb зображенням, тоді як кожен словник шрифту обходить власний ланцюжок дескриптора
// Форма другого проходу: посилач іменує об'єкт
Descriptor := DictOf(FontDict.FindValueByKeyName('FontDescriptor'));
if Assigned(Descriptor) then
begin
  MarkRef(FontDict.FindValueByKeyName('FontDescriptor'), catFontDicts);
  MarkRef(Descriptor.FindValueByKeyName('FontFile'),  catFontPrograms);
  MarkRef(Descriptor.FindValueByKeyName('FontFile2'), catFontPrograms);
  MarkRef(Descriptor.FindValueByKeyName('FontFile3'), catFontPrograms);
end;
// Шрифти Type0 тримають дескриптор на рівень нижче
Descendants := FontDict.FindValueByKeyName('DescendantFonts', True);
if (Descendants is TPDFArray) and (TPDFArray(Descendants).Count > 0) then
  MarkFontProgramRefs(DictOf(TPDFArray(Descendants).Item[0]));
Читання звіту та вибір наступного кроку
Читайте частки першими, кількість об'єктів другою, і трактуйте будь-який великий розрив між ними як сигнал. Сучасний PDF розміщує більшість своїх маленьких словників усередині потоків об'єктів, тож дерево сторінок і дерево структури регулярно показують десятки об'єктів проти майже нуля байтів — їхня реальна вартість згорнута в рядок Object streams. Якщо сам Object streams великий, файл насичений структурою на кшталт метаданих, а не вмістом, і важіль — це вирізання об'єктів, а не їх стискання. Потоки зовнішнього вигляду анотацій поводяться схоже: вони несуть /Subtype /Form, тож рясно проштампований документ показує свою вагу під Form XObjects, тоді як рядок Annotations залишається малим
function CategoryShare(Lib: TPDFlib; ListID: Integer;
  const Category: string): Double;
var
  I: Integer;
  Parts: TArray<string>;
  Inv: TFormatSettings;
begin
  Result := 0;
  Inv := FormatSettings;
  Inv.DecimalSeparator := '.';   // звіт не залежить від локалі
  for I := 2 to Lib.GetStringListCount(ListID) do   // рядок 1 — це Total
  begin
    Parts := string(Lib.GetStringListItem(ListID, I)).Split([',']);
    if (Length(Parts) = 4) and SameText(Parts[0], Category) then
      Exit(StrToFloatDef(Parts[3], 0, Inv));
  end;
end;
Два факти форматування важливі, якщо ви розбираєте відсотки замість того, щоб просто їх показувати. Десятковий роздільник завжди буквальна крапка незалежно від локалі машини, тож розбір з навколишніми FormatSettings на німецькій чи французькій робочій станції зазнає невдачі або, гірше, зчитається неправильно. І кінцеві нулі обрізаються, тож категорія, що містить рівно 40% байтів, друкується як 40, а не 40.0 — ніколи не припускайте фіксовану кількість десяткових знаків. Маючи частку на руках, маршрутизація механічна: домінуюча частка Images вказує на DownsampleImages, домінуюча частка Font programs — на SubsetEmbeddedFonts, а об'ємні Content streams — на CompressContent
Що аудит навмисно вам не повідомляє
Підсумок — це сума по непрямих об'єктах, а PDF-файл трохи більший за свої об'єкти. Заголовок файлу, трейлер, міжоб'єктний пропуск і класична таблиця перехресних посилань не є непрямими об'єктами, тож ці байти нікуди не атрибутуються, і підсумок аудиту виявляється трохи меншим за розмір на диску. Потік перехресних посилань — інша справа: це реальний об'єкт з /Type /XRef, тож у сучасному файлі ці байти таки з'являються, у категорії Other. Жодна з цих поведінок не є дефектом, але якщо ви звіряєте аудит з підрахунком байтів файлової системи, саме звідси й береться розрив
Варто прямо сказати ще про дві межі. По-перше, ці числа описують файл, який було завантажено, а не той, що зараз авторюється: для об'єктів, побудованих у пам'яті, що ще не мають збереженої довжини, розмір повертається до серіалізованого виводу з номінальним допуском на словник потоку, що є оцінкою майбутнього запису, а не вимірюванням. Проведіть аудит після збереження й повторного завантаження, якщо вам потрібні точні цифри. По-друге, товстий рядок Other — це знахідка, а не звіт про помилку — зазвичай це означає осиротілі об'єкти, на які більше ніщо не посилається, і це робота для позначення й очищення сміття (mark-and-sweep), а не для будь-якого проходу стискання
Використаний так аудит змінює форму розмови. Замість того, щоб гадати навколо звіту в 80 МБ, ви його відкриваєте, робите один виклик і читаєте, що зображення — 8%, програми шрифтів — 61%, а документ вбудовує дев'ять повних програм шрифтів для фірмового стилю, що використовує три гарнітури. Це відповідь, яку можна виправити, з прикріпленим числом. AuditDocumentSpace разом з проходами оптимізації, до яких вона вас спрямовує, постачається в losLab PDF Library для Delphi та C++Builder, де довідкові сторінки документують повний список категорій та API списку рядків навколо нього