Yeni üretilmiş bir PDF'de "two-x" araması, sayfa o beş karakteri açıkça gösterirken sıfır sonuç döndürebilir. Çıkarılan dizeyi kod noktaları olarak dökünce neden ortaya çıkar: tire U+00AD SOFT HYPHEN, ardından gelen boşluk U+00A0 NO-BREAK SPACE olarak geri dönmüştür. İkisi de ekranda birebir aynı görünür. Fark ToUnicode CMap'tedir, okuyucunun karakter kodlarını geriye Unicode'a çevirmek için baktığı tabloda ve tek bir font glyph'inin iki kod noktası tarafından paylaşılmasından doğar
Düz dize araçları uyuşmazlığı daha da büyütür. Bir CSV dışa aktarımı satırı başka türlü böler, bir diff aracı her görüntüleyicide birebir aynı okunan iki satırı işaretler ve bir yazım denetleyici soft hyphen'li "two-x"i bilinmeyen bir sözcük sayar. Unicode normalizasyonu yarı yarıya yardım eder: NFKC, U+00A0'yı sıradan bir boşluğa indirger çünkü NBSP uyumluluk ayrışmasına sahiptir; ama U+00AD hiçbir ayrışmaya sahip değildir, dolayısıyla soft hyphen her normalizasyon biçiminden sağ çıkar
Çıkarılan boşluklar neden U+00A0 olarak dönüyor?
Çıkarılan boşluklar, ToUnicode CMap glyph'e göre anahtarlandığında ve bir glyph'e iki kod noktasından ulaşılabildiğinde U+00A0'ya dönüşür. Arial'de 3 numaralı glyph hem U+0020'yi hem U+00A0'yı karşılar, tire glyph'i de hem U+002D'yi hem U+00AD'yi karşılar. Glyph tarafından kurulan bir CMap, CID 0003 hakkında bir şey söylemek zorundadır ve FPDFText_LoadFont içindeki PDFium üreteci sonuçta iki şey söyler: onu U+0020'ye eşleyen bir bfchar girdisi ve aynı CID'yi U+00A0'ya eşleyen dizi biçimli bir bfrange
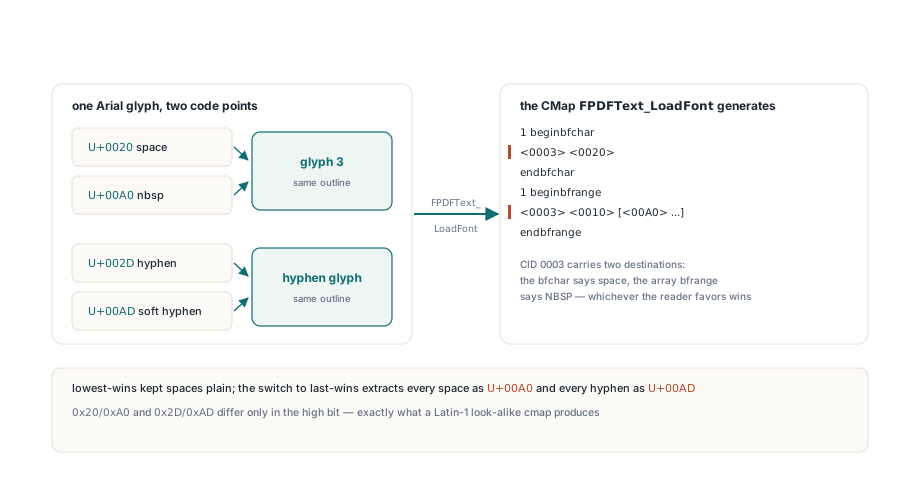
1 beginbfchar
<0003> <0020>
endbfchar
1 beginbfrange
<0003> <0010> [<00A0> ...]
endbfrange
ISO 32000-1 §9.10.3, bfchar ve bfrange'in kodları Unicode'a nasıl eşlediğini anlatır ama ikisi aynı CID'yi talep ettiğinde hangisinin kazanacağını söylemez. Okuyucular kendi öncelik kurallarını seçer. En düşük ya da ilk eşlemeyi tutan bir okuyucu düz bir boşluk çıkarır; PDFium okuyucusu son eşlemeyi tutar ve dizi aralığı bfchar bloğunu izlediği için glyph-anahtarlı bir CMap üzerinden yazılan her boşluk NBSP, her tire soft hyphen olarak çıkar. Aynı metin, aynı dosyanın iki görüntüleyicisinde bu yüzden farklı çıkabilir
Çiftler bir örüntü izler. 0x20/0xA0 ile 0x2D/0xAD yalnızca yüksek bittte farklıdır; bir fontun cmap'i, Latin-1 benzerlerini ASCII karakter için kullanılan kontura gönderdiğinde ortaya tam olarak bu çıkar. Yunan büyük Omega harfi (U+03A9) ile Ohm işareti (U+2126) de Arial'de bir glyph paylaşır. Dünden iyi çalışan çıkarma kodunuz bugün göremediğiniz karakterlerde başarısız oluyorsa, debugger'ın dize görünümüne güvenmek yerine kod noktalarını dökün; bir sayfadan metin okumanın temelleri Delphi'de PDFium ile PDF belgelerinden metin çıkarmak yazısında
PDFium Component sistem fontlarını kod noktasına göre nasıl anahtalar
PDFium Component, Unicode cmap taşıyan sistem fontları için motordan o CMap'i üretmesini hiç istermez. TPdf.AddText bir fonta gereksinim duyduğunda component, fontun kendi sfnt cmap tablosunu okur; format 12 alt tablosunu tercih eder, gerekirse format 4'e düşer. Kod noktalar sıralanmış ve tekilleştirilmiş olarak geri gelir, CID k+1 k. kod noktasına atanır ve CID 0 .notdef olarak bırakılır. Açık bir CIDToGIDMap her CID'yi kendi glyph'ine gönderir. U+0020 ile U+00A0 böylece aynı konturu çizen iki farklı CID alır ve component'in yazdığı ToUnicode CMap her CID'yi tam olarak bir kod noktasına eşler
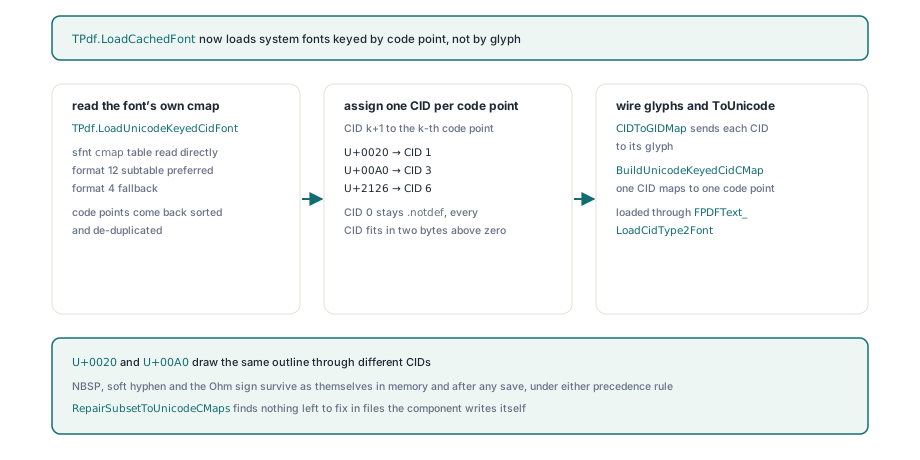
Font, FPDFText_LoadCidType2Font üzerinden yüklenir — açık CID-to-GID map'lerle CID Type 2 font gömme yazısındaki glyph-düzeyi yazımın arkasındaki aynı giriş noktası. FPDFText_SetText sonra bir dize yazdığında ters arama karakter başına tek bir CID'ye düşer. Bunun hiçbir yanı okuyucunun öncelik kuralına bağlı değildir, çünkü kuralın seçecek ikinci bir eşlemesi yoktur. Kaydedilen dosya component'in kendi ToUnicode akışını da taşır; dolayısıyla yeniden yükleme sonrası çıkarma, canlı belgenin kullandığı aynı birebir tabloyu görür
Bedeli daha büyük bir CIDToGIDMap'tir: fontun kapladığı her kod noktası için iki bayt. Bir fontun kabaca 3.000 kod noktası eşlediğini düşünün. Harita o zaman 6 KB civarına gelir ve her fontla birlikte motora verilir. Bu takas her seferinde değecektir: birkaç kilobayt, PDFium'da da ilk eşlemeyi tutan görüntüleyicilerde de, gelecek yıl müşterinizin çalıştırdığı hangi indeksleyicide de aynı okunan bir çıkarma satın alır
Aşağıdaki gidiş dönüş, baş belası her çifti içeren bir dize yazar, kaydedilmemiş belgeden çıkarır, kaydeder, yeniden yükler ve yeniden çıkarır. İki dizenin de girdiyle tam olarak eşleşmesi gerekir; CodePoints yardımcısı yalnızca bir uyuşmazlığı okunabilir kılacak şekilde oradadır:
uses
  SysUtils, PDFium;

const
  // Space/U+00A0 ve hyphen/U+00AD tek bir Arial glyph'i paylaşır,
  // Yunan Omega (U+03A9) ile Ohm işareti (U+2126) de paylaşır
  Sample: WString = 'two-x'#$00A0'y'#$00AD'z '#$03A9#$2126;

function CodePoints(const S: WString): string;
var
  I: Integer;
begin
  Result := '';
  for I := 1 to Length(S) do
    Result := Result + 'U+' + IntToHex(Ord(S[I]), 4) + ' ';
end;

var
  Pdf: TPdf;
  Live, Reloaded: WString;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;
    Pdf.AddPage(1, 595, 842);
    Pdf.AddText(Sample, 'Arial', 12, 72, 770);
    Live := Pdf.Text;                  // canlı, kaydedilmemiş belge
    Pdf.SaveAs('codepoints.pdf');
  finally
    Pdf.Free;
  end;

  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'codepoints.pdf';
    Pdf.Active := True;
    Pdf.PageNumber := 1;
    Reloaded := Pdf.Text;              // tam kaydetme ve yeniden yüklemeden sonra
  finally
    Pdf.Free;
  end;

  if (Live <> Sample) or (Reloaded <> Sample) then
    Writeln('Mismatch: ', CodePoints(Live), '/ ', CodePoints(Reloaded));
end.
Belgeleriniz onları nadiren taşısa bile NBSP ile soft hyphen'i örnek dizide tutun. Yalnızca ASCII yazan bir test, glyph-anahtarlı bir CMap'e karşı da geçer; çünkü içindeki hiçbir şey okuyucudan iki eşleme arasında seçim yapmasını istemez
Tek bir bfrange girdisi bütün bir bloğu nasıl silebilir?
CID dizisi bir xxFF sınırını aşan tek bir bfrange, PDFium'u içinde bulunduğu bloğun tamamını çöpe atmaya iter. ISO 32000-1 §9.10.3 yalnızca hedefin son baytının bir aralık içinde değişmesine izin verir ve CID tarafında PDFium ayrıştırıcısında buna eş bir tuzak vardır: yüksek CID'yi (low and $FFFFFF00) or (high and $FF) olarak türetir. CID 00FE'den 0101'e giden bir dizi bu yüzden 00FE'den 0001'e okunur — düşük, yüksekten büyüktür — ve bloğun tamamı geçersiz işaretlenir. SetText başarılı olur, sayfa doğru render edilir ve çıkarma o bloktaki her karakter için U+0000 döndürür
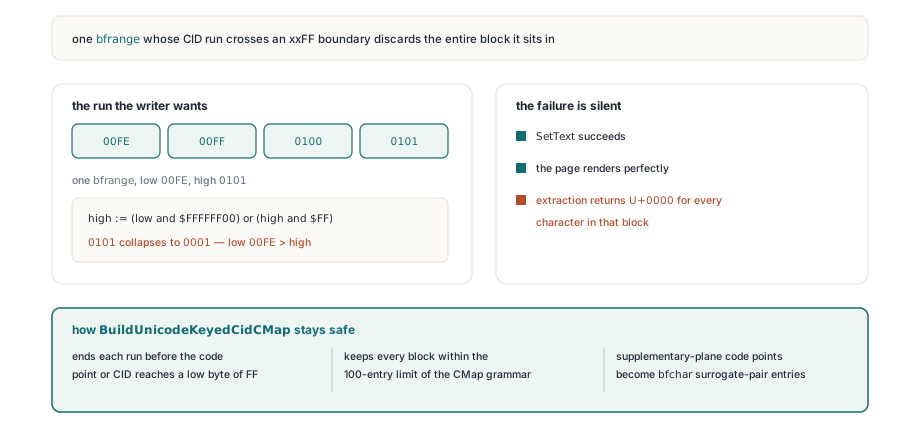
Kod-noktası-anahtarlı font tam olarak bunun dişe dişe dokunduğu yerdir. CID'ler yoğun ve ardışıktır; dolayısıyla 255'ten fazla kod noktası olan her font, yazıcı ardışık girdileri basitçe birleştirseydi 00FF'yi, 01FF'yi ve devamını aşacak CID dizileri üretirdi. PDFium Component'in yazdığı CMap, kod noktası ya da CID bir FF düşük baytına ulaşmadan önce diziyi bitirir ve girdileri en çok 100'lük bloklara böler; CMap gramerinin her beginbfrange ve beginbfchar bölümüne koyduğu sınır budur
U+FFFF üstündeki kod noktalar, hedefleri UTF-16 surrogate çifti olan tek tek bfchar girdileri alır; çünkü bir aralık içinde bir surrogate çiftini artırmanın tanımlı bir anlamı yoktur. Hikâyenin surrogate tarafı Delphi'de emoji, CJK ve surrogate çifti işleme yazısında. Yalnızca-bfchar bir CMap sınır sorununu bütünüyle atlatırdı — birkaç kat büyüklük pahasına; aralıkların ana biçim olarak kalması ve bölme kurallarının yükü taşıması bunun içindir
Başka araçlardan gelen dosyalarda ToUnicode çelişkilerini onarmak
FPdfCompress unit'indeki RepairSubsetToUnicodeCMaps, component'in yazmadığı dosyalardaki glyph-anahtarlı çelişkiyi düzeltir. TPdf.SaveAs her tam, artımlı olmayan kayıtta onu çalıştırır ve doğrudan herhangi bir akış üzerinde çağırabilirsiniz. İki hedefi taşıyan her CID için bfchar girdisi kazanır. CID için bir bfchar yoksa, yalnızca yüksek bittte farklı olan bir çift daha küçük taban-Latin kod noktasına çözülür. Diğer her çelişki ilk eşlemesini korur
Onarım, çelişen hex değerlerini eşit uzunlukta değişimlerle yerinde düzenler. Blok düzeni, CID kapsamı ve akışın diğer her baytı eski hâlinde kalır; böylece CMap, PDFium okuyucusunun zaten kabul ettiği biçimde kalır. Temizce yeniden kurulmuş bir CMap hex dökümünde daha derli toplu görünürdü. Ayrıca katı bir okuyucunun zaten kabul ettiği bir akışın yapısını değiştirirdi; yalnızca bir avuç hedef değeri yanlışken upside'sız bir kumardır
uses
  Classes, FPdfCompress;

var
  Source, Dest: TFileStream;
begin
  Source := TFileStream.Create('from-other-tool.pdf',
    fmOpenRead or fmShareDenyWrite);
  try
    Dest := TFileStream.Create('repaired.pdf', fmCreate);
    try
      // Yalnızca eşit-uzunluklu düzenlemeler; onarılabilir çelişkisi olmayan dosyalar
      // ve çapraz-referans-stream ya da object-stream dosyaları olduğu gibi kopyalanır
      RepairSubsetToUnicodeCMaps(Source, Dest);
    finally
      Dest.Free;
    end;
  finally
    Source.Free;
  end;
end.
Rutin, klasik bir çapraz referans tablosu yeniden kurar; bu yüzden çapraz-referans akışı, hibrit referans ya da object stream kullanan belgeler bayt bayt geçer. Artımlı kaydetmeler (saIncremental) tasarım gereği onarımı atlar, çünkü artımlı bir revizyon yalnızca-ekleme kalmalıdır. Component'in kendi yazdığı metin için ikisi de önemli değildir: kod-noktası-anahtarlı fontları, onarımın bulacağı bir çelişki hiç üretmez
Kod-noktası-anahtarlı yolun geçerli olduğu yer
Kod-noktası-anahtarlı yol, Unicode cmap alt tablosu açığa veren her fontu kapsar; geri kalanları PDFium'un glyph-anahtarlı yüklemesi karşılar. Buna güvenmeden önce bilinmeye değer ayrıntılar:
- Yalnızca (3,0) cmap'i olan symbol fontlar ve CID yolunun yükleyemediği her font
FPDFText_LoadFont'tan geçer; iki kod noktasının paylaştığı bir glyph orada okuyucunun öncelik kuralına tabidir - Yalnızca format 4 alt tablosu varken harita Basic Multilingual Plane'i kapsar; (3,10) ya da Unicode platformundaki bir format 12 alt tablosu tamamlayıcı-düzlem kod noktalarını ekler
- Glyph 0 ile surrogate kod noktaları dışarıda bırakılır ve girdi sayısı 65535'te tavanlanır; böylece her CID, sıfırın üstünde iki bayta sığar
- TrueType Collections ekstra özen ister: GDI
GetFontData.ttc'nin tamamını döndürür veFPDFText_LoadCidType2Font'un face index parametresi yoktur; koleksiyonu olduğu gibi geçirmek, simsun.ttc'den NSimSun isterken 0. face olan SimSun'u gömerdi. Component aile adını fontun name tablosuyla (nameID 1 ve 16) eşleştirir ve istenen face'i bağımsız bir sfnt olarak verir; parse edemediği bir koleksiyon bütün olarak geçer ve 0. face'i kullanır - İstenen adla okunabilir bir sistem font yoksa
AddText, font adını PDFium'un standart fontları arasında bakanFPDFPageObj_NewTextObj'ye devreder
Görünmez karakterleri indekste katlayın, metinde tutun
Çıkarma gerçek kod noktalarını döndürmeye başladığında başka bir soru doğar: arama indeksi, yazarın kasıtlı yazdığı gerçek bir NBSP ya da soft hyphen ile ne yapmalı? Bunları indeksleme katmanında katlayın ve TPdf.Text'e dokunmayın. Çıkarılan dize, belgenin söylediği şeyin kaydıdır; indeks ise eşleştirme için kurulmuş kayıplı bir görünümdür ve katlama kuralları ona aittir
Aşağıdaki yardımcı, kendi kodunuza ekleyeceğiniz bir işlevdir. NBSP'yi boşluğa eşler ve soft hyphen'i düşürür; o da Unicode Standardı'na göre yalnızca bir satırın kırılabileceği yeri işaretler. U+2126'ya kasıtlı olarak dokunmaz. NFC normalizasyonu Ohm işaretini Omega'ya çevirirdi, çünkü U+2126'nın U+03A9'ya kanonik singleton ayrışması vardır ve bir veri sayfası aramasının ikisini eşleştirmesi çıkarma değil ürün kararıdır:
uses
  SysUtils, Classes, PDFium;

// Arama indeksi için kendi yardımcınız; PDFium Component'in parçası değildir
function FoldForIndex(const S: string): string;
begin
  Result := StringReplace(S, #$00A0, ' ', [rfReplaceAll]);
  Result := StringReplace(Result, #$00AD, '', [rfReplaceAll]);
end;

procedure IndexDocument(const FileName: string; Lines: TStrings);
var
  Pdf: TPdf;
  P: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    for P := 1 to Pdf.PageCount do
    begin
      Pdf.PageNumber := P;
      Lines.Add(FoldForIndex(Pdf.Text));   // tam metin Pdf.Text'te kalır
    end;
  finally
    Pdf.Free;
  end;
end;IndexDocument'u ilk örnekteki codepoints.pdf dosyasında çalıştırın; indekslenen satır "two-x yz ΩΩ" biçiminde okunmalı, on bir karakter ve sonuncusu bir Ohm işareti olmalı; oysa Pdf.Text hâlâ NBSP ve soft hyphen dahil özgün on iki karakterin tamamını döndürür
Kod-noktası-anahtarlı fontlar, CMap onarımı ve metin çıkarma, Delphi, C++Builder ve Lazarus boyunca aynı sayfa modelinin üzerine oturur; font ve metin API'si eksiksiz biçimde Delphi için PDFium Component ürün sayfasında anlatılır