Bir FDF'i bir forma içe aktar, alan değerleri incelikle yanlış geri gelir: bir bullet bir dagger olarak gelir, bir ellipsis em dash olarak. PDFium Component bu semptom ailesinin tamamını PDFDocEncoding tablosundaki tek bir satıra kadar izledi — ISO 32000-1 Annex D.2'deki özel karakter bloğu $7F değil $80 ile başlar
Bir FDF içe aktarması neden komşu karakteri döndürür?
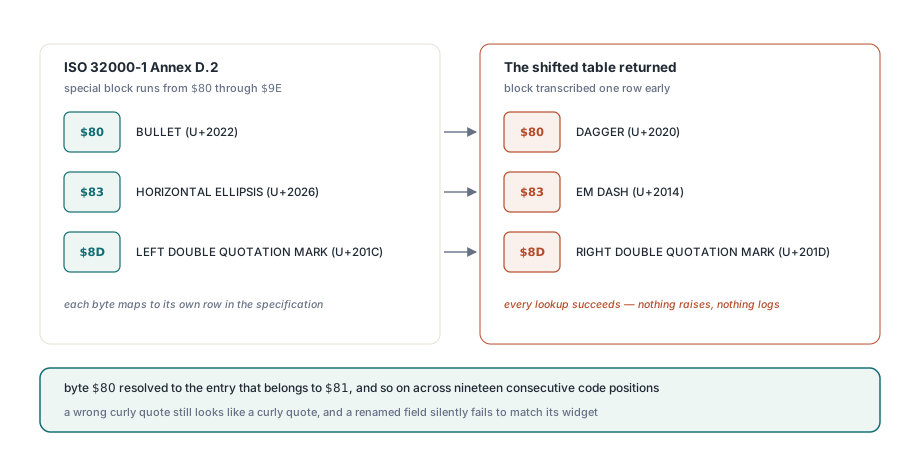
Çünkü bir konum kaymış bir kodlama tablosu hâlâ kusursuz görünümlü bir tablodur ve içindeki her arama başarılı olur. Annex D.2'nin $80'dan $9E'ye atadığı blok bir satır erken yazılmıştı; böylece $80 baytı $81'e ait girdiye, $81 baytı $82 girdisine çözüldü ve bu, on dokuz ardışık kod konumu boyunca böyle sürdü. Hiçbir şey yükselmedi, hiçbir şey loglanmadı ve hiçbir alan asla reddedilmedi — TPdf.ImportFDF her zaman verdiği alan sayısını verdi
Hasar tekdüze ve sessizdi. $80 taşıyan bir bayt — Annex D.2'nin BULLET (U+2022) olarak tanımladığı — DAGGER (U+2020) olarak geri geldi. $83 baytı, HORIZONTAL ELLIPSIS (U+2026), EM DASH (U+2014) olarak geri geldi. $8D baytı, LEFT DOUBLE QUOTATION MARK (U+201C), RIGHT DOUBLE QUOTATION MARK (U+201D) olarak geri geldi — kimsenin fark etmediği durum, çünkü yanlış bir kıvrımlı tırnak bir form alanında yine de kıvrımlı tırnak gibi görünür. Alan adları alan değerleriyle aynı kaderi yaşadı, ki bu daha kötüdür: belgedeki widget ile artık eşleşmeyen bir ad sessizce uygulanmaz
PDF metin stringleri iki farklı kodlama taşır
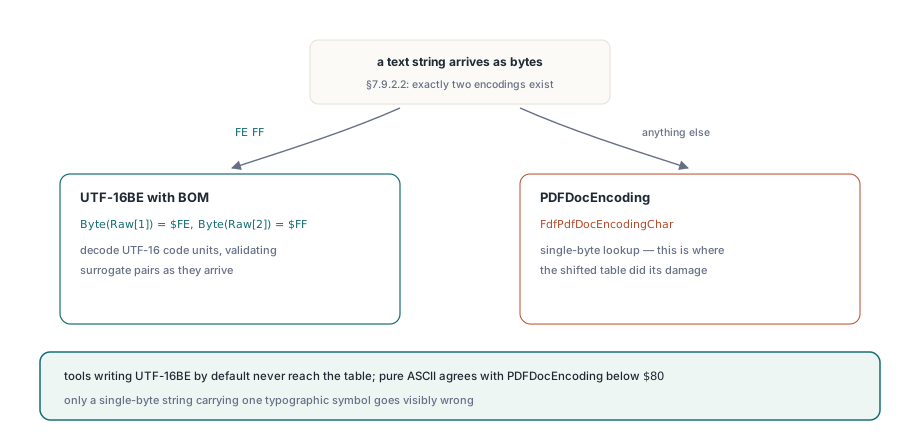
ISO 32000-1 §7.9.2.2 metin string türünü tam olarak iki kodlamadan biri olarak tanımlar; seçim herhangi bir sözlük girdisinden çok ilk iki baytın incelenmesiyle yapılır. Bayt sırası işareti FE FF ile açılan bir string UTF-16BE'dir; geri kalan her şey PDFDocEncoding'dir. Bu tek dal, tamamen farklı iki decoder'dan hangisinin çalışacağına karar verir ve PDFium Component bunu FDF parser'ının içinde, tek bir karaktere dokunmadan önce uygular
// FDF metin stringi: BOM varken UTF-16, aksi halde PDFDocEncoding
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... UTF-16 kod birimlerini çöz, surrogate çiftlerini doğrula
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;
Bug'ın sıradan testlerde bu kadar uzun saklanmasının nedeni budur. Varsayılan olarak UTF-16BE yazan bir aracın ürettiği herhangi bir FDF, FdfPdfDocEncodingChar'a hiç ulaşmaz; böylece kaymış tablo uykuda kalır. Yalnızca tek baytlık stringler — ki çoğu FDF üretecinin düz Latin alan adları için yaydığı şey budur, çünkü daha kısadırlar — tablonun önemli olduğu dala iner. Saf ASCII alan adları o zaman da doğru çözülür, çünkü $80 altında PDFDocEncoding ve ASCII aynı fikirdedir. Görünür biçimde bir şeyin yanlış gitmesi için tek bir tipografik sembol içeren tek baytlık bir stringe ihtiyacın var
Düzeltilmiş tablo ve onu sabitleyen iki çapa
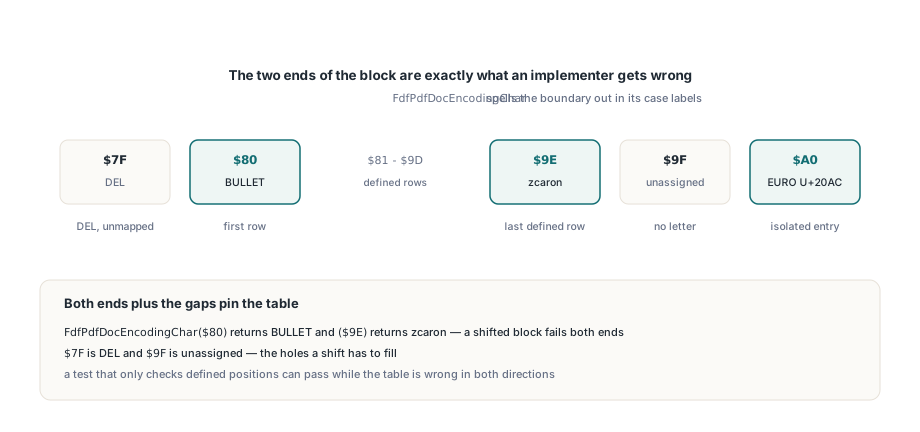
PDFium Component artık sınırı FdfPdfDocEncodingChar'ın içinde açıkça yazar, çünkü bloğun iki ucu tam olarak uygulayıcının yanlış yaptığı yerdir. $7F DEL'dir ve hiçbir PDFDocEncoding anlamı yoktur; blok $80'de BULLET ile açılır ve $9E'de zcaron ile biter; $9F atanmamıştır; Euro işareti $A0'da tek başına durur
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // ISO 32000-1 Annex D.2. Blok $7F değil $80'den başlar: $7F DEL'dir ve
    // hiçbir PDFDocEncoding anlamı yoktur ve Euro $A0'da durur; varsayılan
    // dal onu aksi halde no-break space olarak geri verirdi
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET, bloğun ilk satırı
    $81: Result := WideChar($2020);   // DAGGER
    // ... $82 through $9D
    $9E: Result := WideChar($017E);   // zcaron, tanımlı son satır
    $9F: Result := WideChar($FFFD);   // Annex D.2'de atanmamış
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;
Kaymanın o iki uca ne yaptığına bak, çünkü off-by-one tam orada kozmetik olmaktan çıkar. zcaron şartnamede $9E'de ama kaymış tabloda $9D'de duruyordu; böylece belgedeki $9E baytı, herkesin yazdığı son satırın ötesine düştü ve doğrudan kimlik fallback'ine değdi, bir harf yerine bir C1 kontrol karakteri döndürdü. Ve $A0, yani Euro, tabloya en başta hiç yazılmamıştı — kimlik dalı onu U+00A0 NO-BREAK SPACE olarak geri verdi; sonraki her doğrulamadan sağ çıkan, hiçbir şey basmayan ve aradığın alan adıyla asla eşleşmeyen bir karakter
Yazılmış bir kodlama tablosunu nasıl test edersin?
İlk satırı, son satırı ve boşlukları test et — ortadan bir örnek değil. Bu, düzeltmenin bir şartnameden kopyaladığın diğer her tabloya taşımaya değer kısmıdır, çünkü bloğun ortasındaki bir nokta kontrolü tam olarak tam-bir bloğun sağ kaldığı testtir. $8D'nin sol çift tırnak verdiğini doğrulamak, $8C de makul bir şey verdiğinde hiçbir şey kanıtlamaz; $80'in BULLET ve $9E'nin zcaron verdiğini doğrulamak iki ucu da sabitler ve kaymış bir blok ikisini aynı anda tatmin edemez
procedure CheckPdfDocEncodingAnchors;
begin
  // Annex D.2 özel bloğunun iki ucu: tam blok kayması bunları bozar
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // Şartnamenin tanımsız bıraktığı kod konumları bir harfe çözülmemeli
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // Bloğun üzerindeki yalıtılmış girdi, tamamen atlamak kolaydır
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;
Tanımsız konumlar ilginç değil diye atlanmak yerine kendi assertion'larını hak eder. Bir off-by-one bir yerlere bir şey koymak zorundadır ve koyduğu yer neredeyse her zaman şartnamenin boş bıraktığı bir kod konumudur — önde $7F, arkada $9F. Yalnızca tanımlı konumları kontrol eden bir test, tablo her iki yönde de yanlışken geçebilir; delikleri sabitleyen bir test kaymayı ilk çalıştırmada yakalar
Bunun bir round-trip form iş akışına maliyeti ne?
Sembol başına bir karakteri sessizce yeniden yazan bir FDF içe aktarması, başarısız olandan daha kötüdür; çünkü başarısızlık aşağı akışta yüzeye çıkar ve başka bir şey gibi görünür. Alan adları buradaki keskin kenardır. TPdf.ImportFDF gelen adları açık belgedeki widget'larla eşleştirir ve bir karakteri yanlış çözülen bir ad basitçe eşleşmez — alan boş kalır, dönüş değeri alanı yine de ayrıştırılmış sayar ve hattan çıkan rapor, logda hiçbir şey açıklamayan tek bir değer eksiktir. XFDF form verilerini ve ek açıklamalarını PDFium Component ile dışa ve içe aktarmak yazısında anlatılan türden bir dışa-ve-yeniden-içe-aktarma döngüsü kuran herkes, döngüye güvenmeden önce düz ASCII değil, tipografik bir sembol içeren bir alan adını round-trip etmelidir
Düzeltmenin sınırları konusunda dürüst olmaya da değer. Tablo artık 256 bayt değerinin tümü için Annex D.2 ile eşleşir, bu da tek baytlık FDF stringlerinin doğru çözülmesini sağlar; ama PDFDocEncoding'in kendisi bir Latin repertuarını kapsar ve başka hiçbir şeyi — onun dışındaki her şey BOM'lu bir UTF-16BE olarak gelmek zorundadır, §7.9.2.2'nin niyeti tam olarak budur. Ve bir UTF-16 string'in Delphi tarafında hâlâ kendi ayrı tehlikeleri vardır, çünkü U+FFFF ötesindeki bir kod noktası tek bir WideChar yerine bir surrogate çifti gerektirir; emoji ve CJK karakterlerinin Delphi'de WideChar'ı neden bozduğu yazısında ele alınan problem. Daha geniş nokta kodlama tablolarının ötesine genelleşir: bir PDF parser, kabul etmesi gereken bir şeyi reddedebilir, ki bunu hemen bulursun; ya da bir şeyi kabul edip sessizce yanlış yapabilir, ki bunu üretimde bulursun. PDF sözlüklerini güvenle ayrıştırmak yazısında anlatılan ad-token tuzakları ikinci kategoride oturur; bir satır kaymış bir tablo da öyle — kod yolu başarılı olur, dönüş değeri makul görünür ve yalnızca uygulamaya karşı değil şartnameye karşı yazılmış bir test aksini söyler
TPdf üzerindeki ImportFDF, ExportFDF ve ImportXFDF, arkalarındaki FDF ve XFDF parser'larıyla birlikte, Delphi ve C++Builder için standart PDFium Component'in parçasıdır