Word çıktısında üç sayfaya yayılan bir tablo, kâğıdın alt kenarına asla 72 puntodan fazla yaklaşamaz. Bir inçlik kenar boşlukları 72 puntodur ve kelime işlemci satırları kenar boşluğunda yerleştirmeyi bırakır. Parçaları yalnızca sayfa kenarlarına 36 punto içinde olduklarında birleştiren bir birleştirici, aynı sütunlara sahip birbiriyle ilgisiz üç tablo görür. İşe yarayan soru başkadır: bir parçanın bittiği yer ile sonrakinin başladığı yer arasında, koşan bir üstbilgi ya da altbilgi dışında bir şey var mı?
Bu sorunun kendine ait iki tuzağı var. Bir form, birinci sayfanın altında bir tabloyu bitirip ikinci sayfanın üstünde aynı sütun genişliklerine sahip bambaşka bir tablo açabilir. Ve çizgili bir ızgara tek bir satırı sayfa sonunun ötesine itebilir; iki satır görmeden bir şeyi tablo saymayan bir dedektör için o satır fazlasıyla kısadır
ExtractDocumentTables içindeki iki kenar testi
PDFium Component devamları TPdf.ExtractDocumentTables içinde işaretler; bu, tablo algılama ve çıkarma makalesinin konusu olan sayfa başına çalışan ExtractTablesın belge düzeyindeki karşılığıdır. TPdfTableExtractionOptions.Default içinde olduğu gibi DetectContinuations ayarlıyken yöntem her sayfayı çıkarır, tabloları sayfa numarasına sonra her sayfada yukarıdan aşağıya sıralar ve listedeki her komşu çiftini sınar. Yalnızca komşular karşılaştırılır. Bu yüzden devam adayı daima N. sayfadaki en alttaki tablo ile N+1. sayfadaki en üstteki tablonun eşleşmesidir; N. sayfada uzun bir tablonun altına konan küçük bir tablo, o eşleşmede uzun olanın yerini alır. Kısa bir not tablosu uzun birinin altında duruyorsa o parçaları kendi kodunuzda sayfa numaralarından ve ColumnCount değerinden bağlayın
İlk test tümüyle geometriktir. Önceki parçanın alt kenarı sayfa altına ContinuationMargin punto içinde olmalı, sonraki parçanın üst kenarı da sonraki sayfanın üstüne aynı mesafede bulunmalıdır. Varsayılan 36 punto, yarım inçtir. Sabit bir içerik kutusunu dolduran layout motorlarının raporları bu testi rahatça geçer. Bir inçlik kenar boşluklarıyla üretilen bir Word çıktısı iki yanda da en az 36 punto şaşar ve sayıyı teste geçecek kadar büyütmek yanlış gider; çünkü aynı sayı ikinci testin üstbilgi ve altbilgi bantlarını da belirler
İkinci test, yani içerik duyarlı olanı, kelime işlemci çıktısını ele alandır. İkisi OR ile birleşir: kapıyı ikisinden biri açar
İki parça arasında ne metin sayılır?
Koşan üstbilgi bandının ya da altbilgi bandının tamamı içinde kalmadıkça sayfadaki her kelime gövde metni sayılır ve iki bant da ContinuationMargin punto derinliğindedir. ExtractDocumentTables sayfa başına, üstü altbilgi bandının üzerinde kalan kelimeler arasında en düşük alt kenarı, altı üstbilgi bandının altında kalan kelimeler arasında en yüksek üst kenarı kaydeder; tablonun kendi hücre metni de dahildir. Tablo N. sayfanın son gövde içeriği olduğunda alt kenarı en düşük kelimenin seviyesinde ya da onun altındadır ve test, varsayılanı 3 punto olan AlignmentTolerance içinde geçer. Sonraki parçanın da ayna koşulunu N+1. sayfanın üstünde sağlaması gerekir
Bantları yok saymanın dayanağı spesifikasyonda var. ISO 32000-1 §14.8.2.2, koşan başlıkları, altbilgileri ve sayfa numaralarını sayfalama artifactı sayar: yalnızca belge sayfalara bölündüğü için var olan içerik. Etiketli bir dosya bunları /Artifact ile bildirebilir, marked content makalesinin anlattığı gibi; ama tablo birleştirmeye en çok ihtiyaç duyan çıktılar nadiren etiket taşır, o yüzden etiketin yerine konum geçer. Varsayılan bantta glifleri alt kenarın 30 punto üstünde biten bir sayfa numarası yok sayılır. 40 puntoya ulaşan bir feragatname satırı gövde metnidir ve bağlantıyı bloklar
Metin katmanı olmayan bir sayfada kaydedilen uç değerler sayfa sınırlarına düşer, içerik duyarlı test koşulsuz geçer ve kararı kalan kapılar verir. Resim ya da vektör konturu olarak çizilen altbilgiler aynı nedenle görünmezdir ve asla bağlantıyı bloklamaz
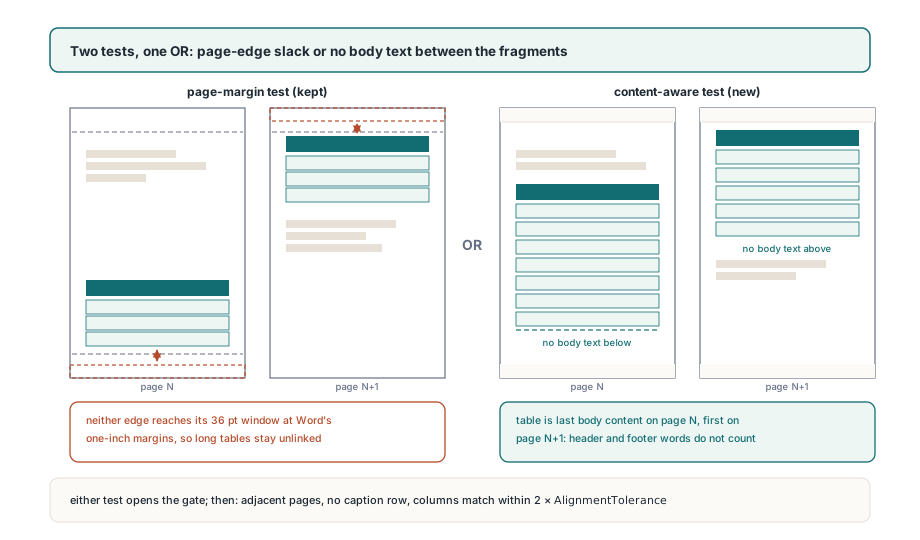
Bir kenar testini geçmek yalnızca kapıyı açar. Sayfalar bitişik olmalı, sonraki parça bir başlık satırıyla açılmamalı ve sütun sınırları AlignmentToleranceın iki katı içinde hizalanmalıdır; varsayılanlarda bu 6 punto. Bunların hepsi sağlandığında önceki parça yeni bir grup numarasıyla ptcStart olur ya da halihazırda bir zinciri kapatmışsa ptcEndden ptcMiddlea geçer, sonraki parça da aynı grupta ptcEnd olur. Üç sayfaya yayılan bir tablo start, middle, end olarak okunur. Grup numaraları 1'den başlar; ptcNone ile birlikte 0 numaralı grup, tablonun tek başına durduğu anlamına gelir. ToJson aynı bilgiyi "continuationGroup" ile "continuation" (none, start, middle ya da end) olarak yazar; JSON alan bir servis birleştirmeyi kendisi yapabilir
Aşağıdaki listeleme, yaklaşık 50 punto derinliğinde iki satırlık bir altbilgisi olan bir Word çıktısı varsayar; iki satırın da bandın içinde kalması için pay 54'e çıkar
uses
  System.SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;  // DetectContinuations = True
    Options.ContinuationMargin := 54;               // altbilgi ~50 pt derinliğinde varsayılıyor

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d, %d x %d',
          [Tables[I].PageNumber, Tables[I].RowCount,
           Tables[I].ColumnCount]));
      end;
  finally
    Pdf.Free;
  end;
end.
Tüm genişliğe yayılan ilk satır iki tabloyu nasıl ayrı tutar?
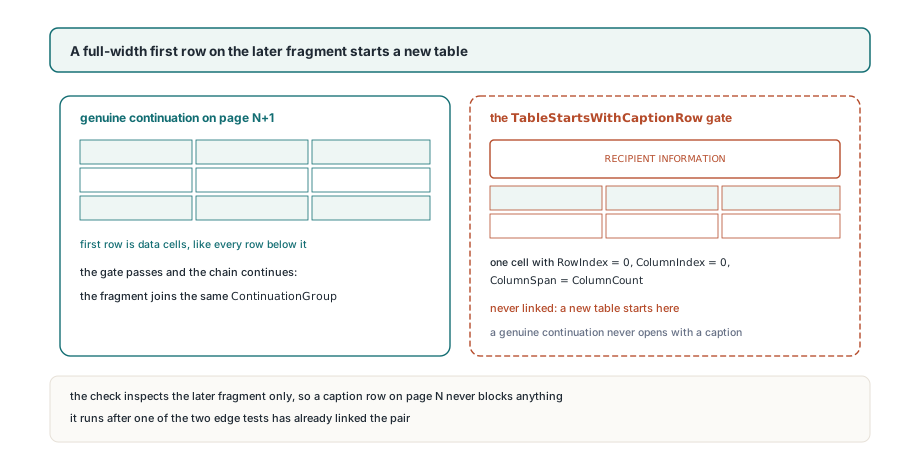
İlk satırı her sütuna yayılan tek bir hücre olan sonraki parça, bir kenar testi geçse ve sütunlar uyuşsa bile yeni tablo olarak bildirilir. İçerik duyarlı testin fazla hevesli bağlayacağı yer formlardır: bir tablo 1. sayfanın altına yakın biter, sonraki bölüm 2. sayfada aynı sütun genişlikleriyle açılır ve tüm geometrik kontroller geçer. Ayıran şey ikinci tablonun açılış satırıdır: tüm genişlik boyunca tek bir birleşik hücre olarak dizilmiş RECIPIENT INFORMATION gibi bir bölüm başlığı. Gerçek bir devam bu şekilde açılmaz; çünkü tablonun başlığı, tablonun başladığı sayfada kalır
Kural yalnızca sonraki parçanın hücrelerini okur. O parçanın en az iki sütunu ve RowIndex = 0, ColumnIndex = 0 ile ColumnSpan = ColumnCount koşullarını sağlayan bir hücresi olması gerekir. Önceki parçaya hiç bakılmaz; bu yüzden kendi başlığı N. sayfanın üstünde duran bir tablo, N+1. sayfadaki devamlarına normal şekilde bağlanır
Ardından gelen sütun karşılaştırması eşit sütun sayısından daha katıdır. Her parçanın sınır konumları hücre dikdörtgenlerinden yeniden kurulur; birleşik bir hücrenin altında gizlenen sınır, iki yandaki en yakın bilinen sınırlar arasında eşit aralıkla konumlandırılarak tamamlanır. Sonra her sınır çifti karşılaştırılır ve 6 puntoyu aşan bir fark bağlantıyı reddeder. Farklı oranlara sahip iki dört sütunlu tablo ayrı kalır. Üreticisi sayfalar arasında bir sütunu 8 punto kaydıran gerçek bir devam da öyle; bunu kabul ettirmek için AlignmentToleranceı yükseltmek, algılama sırasında kullanılan kümelenmeyi de gevşetir
Sayfa sonunu aşan tek bir çizgili satır
Tek bir satırını sonraki sayfaya iten çizgili bir ızgara, bir zincire bağlandığında o satırı tutar; bağlanmadığında kaybeder. Varsayılan 2'lik MinRows, başıboş bir çizgi çiftinin tablo olarak bildirilmesini engeller. Sayfa sonunun ötesine itilen satır başkadır: o gerçek veridir ve onu düşürmek, birleştirilmiş tabloyu açıklamasız bir satır eksik bırakır
Belge taraması bunu üç adımda halleder. DetectContinuations ile DetectRuledTables birlikte açıkken çizgili dedektör her sayfada, satır tabanı 1'e indirilmiş hâlde çalışır. Devamlar ardından tüm sonuç üzerinde işaretlenir. Son olarak, çağıranın MinRowsundan az satırı olan ve hiçbir zincire düşmeyen her tablo kaldırılır. Sıradan bir sayfanın ortasındaki tek satırlık ızgara bu filtreden geçer ve kaybolur; MinRowsun amacı tam olarak budur
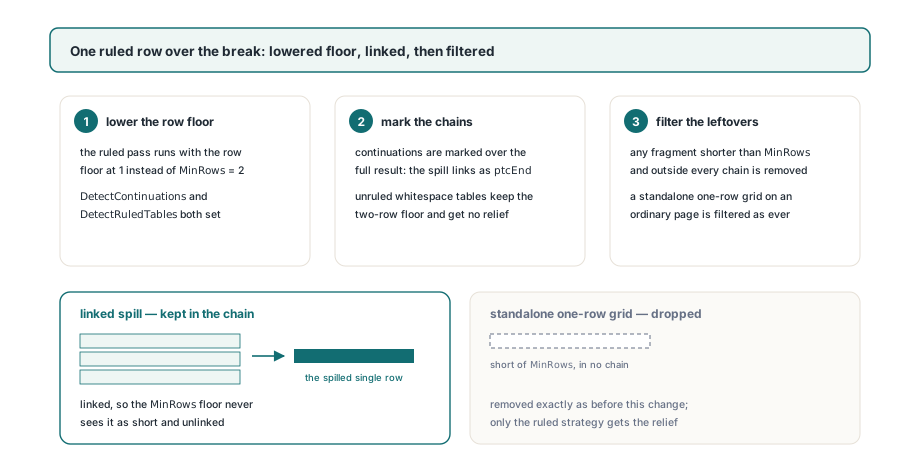
MinRowsu 2'de bırakın. Kendiniz onu 1'e çekerseniz son filtre kapanır ve her sayfadaki her tek satırlık çizgili ızgara geri döner
İstisna yalnızca çizgili ızgaralar için geçerlidir. Whitespace stratejisi bir tabloyu tanımak için en az iki hizalı satıra ihtiyaç duyar; bu yüzden MinRows ne derse desin içeride 2'lik bir taban korur. ExtractTables MinRows = 1 kabul eder ama buna yalnızca çizgili algılama riayet eder. Bir satırı taşan çizgisiz bir tablo için sayfanın kelime kutuları ya da yapılandırılmış metin blokları ve okuma sırası makalesinde anlatılan bloklar, o satırı kendiniz kurtarmanız için gereken konumları verir
Bir zinciri yeniden tek tabloya dikmek
Zincirler bitişik olarak geri döner. Bağlantılar yalnızca sıralı dizideki komşular arasında kurulur; dolayısıyla bir ptcStart parçasını doğrudan kendi ptcMiddle ve ptcEnd parçaları izler ve ptcNone ya da ptcStartta sıfırlanıp ptcNone ya da ptcEndde çıktı yazan bir döngünün grup numarasına göre hiçbir şey araması gerekmez
Asıl ince nokta yinelenen başlık satırıdır: Word onu her sayfada yineleyebilir, öbür üreticiler yinelemez. TPdfTableCell üzerindeki IsHeader bayrağı bunu çözemez; çünkü bayrak konumla atanır, her parça için ayrı ayrı RowIndex < HeaderRowCount. Bir devamın 0. satırı ister başlığı yinelesin ister veri taşısın başlık olarak işaretlenir ve önceki bölümdeki tek satırlık taşma da işaretlenir. Aşağıdaki rutin her devamın ilk satırı ile zincirin ilk satırını karşılaştırır ve yalnızca birebir aynıysa düşürür
Rutin satırları ayrıca ToCsv çıktısını satırlara bölerek değil Cellsten kurar. Metni hücre içinde saran bir hücre, görsel satırları arasında CR LF ile döner; ToCsv o kırılmayı tırnaklı alanın içinde tutar ve CSV metninin ilk satırını silmek, iki satırlık bir başlık hücresini ortadan ikiye böler
// Okuyucu tarafı yardımcılar (kütüphanenin parçası değildir): her zinciri
// sekmeyle ayrılmış tek dosya olarak yeniden kur, sonraki sayfalarda yinelenen başlık satırlarını düşürerek
function RowText(const T: TPdfTable; Row: Integer): string;
var
  Parts: array of string;
  I: Integer;
begin
  SetLength(Parts, T.ColumnCount);
  for I := 0 to High(T.Cells) do
    if (T.Cells[I].RowIndex = Row) and (T.Cells[I].ColumnIndex >= 0) and
       (T.Cells[I].ColumnIndex < T.ColumnCount) then
      Parts[T.Cells[I].ColumnIndex] :=
        StringReplace(string(T.Cells[I].Text), #13#10, ' ', [rfReplaceAll]);
  Result := '';
  for I := 0 to High(Parts) do
  begin
    if I > 0 then
      Result := Result + #9;
    Result := Result + Parts[I];
  end;
end;

procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R, FirstRow: Integer;
  Header: string;
  Lines: TStringList;
begin
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      FirstRow := 0;
      if Tables[I].Continuation in [ptcNone, ptcStart] then
      begin
        Lines.Clear;
        Header := RowText(Tables[I], 0);
      end
      else if (Trim(Header) <> '') and (RowText(Tables[I], 0) = Header) then
        FirstRow := 1;                     // başlık bu sayfada yinelendi
      for R := FirstRow to Tables[I].RowCount - 1 do
        Lines.Add(RowText(Tables[I], R));
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Lines.SaveToFile(Format('%s\table%d-page%d.tsv',
          [Folder, I, Tables[I].PageNumber]));
    end;
  finally
    Lines.Free;
  end;
end;
Birebir karşılaştırma doğru tercihtir. Kelime işlemcinin yinelediği bir başlık karakter karakter uyuşur; bulanık bir eşleşme er ya da geç başlığa benzeyen bir veri satırını yutar. Araya giren fazladan bir başlık çıktıda kolayca fark edilir; kaybolan bir veri satırı ise fark edilmez
Tahmin etmek yerine altbilgi bandını ölçmek
ContinuationMargin tek sayıyla üç iş yapar: ilk test için sayfa kenarı payı, ikinci için altbilgi bandı ve üstbilgi bandı derinliği. Banttan derin bir altbilgi üst satırını gövde bölgesinde bırakır; önceki parça ardından metin geliyormuş gibi görünür ve zincir o sayfada kopar. Fazla derin ayarlanan bir bant gerçek içeriği yutmaya başlar: alt kenar boşluğunun hemen üstündeki kısa bir kapanış satırı bandın içine düşer ve o satırın üstündeki tablo, sonraki sayfayı açan her neyse ona bağlanabilir
Sayıyı belgenin kendisi de sağlayabilir. TPdf.PageWordBoxes, geçerli sayfadaki her kelimeyi Topu Bottomdan büyük sayfa uzaylı bir Rect ile döndürür; dolayısıyla gövde boşluğunun altında duran kelimeler arasındaki en yüksek Top, altbilgi derinliğidir. Aşağıdaki yoklama, layoutun alt kenar boşluğunun hemen altında bir değer alır — bir inçlik sayfa için 70 — ve altbilgisiz belgeler için 36 puntoyu taban tutar
// Okuyucu tarafı yardımcı (kütüphanenin parçası değildir): herhangi bir sayfada
// BodyMargin altında bulunan en yüksek kelime üstü, yani altbilgi bölgesinin derinliği
function MeasureFooterDepth(Pdf: TPdf; BodyMargin: Double): Double;
var
  P, I: Integer;
  Words: TPdfWordBoxes;
begin
  Result := 0;
  for P := 1 to Pdf.PageCount do
  begin
    Pdf.PageNumber := P;
    Words := Pdf.PageWordBoxes;
    for I := 0 to High(Words) do
      if (Words[I].Rect.Bottom < BodyMargin) and
         (Words[I].Rect.Top > Result) then
        Result := Words[I].Rect.Top;
  end;
end;

// Max için uses satırına System.Math ekleyin
Options := TPdfTableExtractionOptions.Default;
Options.ContinuationMargin := Max(36.0, MeasureFooterDepth(Pdf, 70) + 2);
Tables := Pdf.ExtractDocumentTables(Options);
Bant iki kenarda da aynı derinliktedir; o yüzden derin bir koşan üstbilgiyi de sayfa üstüne karşı ölçün ve büyük olan değeri kullanın. Payı birkaç puntoda tutun; her fazladan punto, içerik duyarlı testin görmeyi bıraktığı bir punto gövde metnidir
Tek bir layout, başlık kuralını tasarımla devre dışı bırakır: her devam parçasının ilk satırı olarak birleşik bir "continued" bannerı yazan üretici. Bu parçaların her biri yeni tablo olarak bildirilir; o yüzden onları kendi kodunuzda art arda gelen sayfa numaralarından, eşit ColumnCounttan ve 0. satırdaki banner metninden bağlayın
Devam işaretleme, başlık kuralı ve tek satır istisnasının hepsi ExtractDocumentTablesin içinde çalışır ve Delphi, C++Builder ile Lazarus derlemelerinde aynı davranır. Tablo çıkarma seçeneklerinin tamamı, Delphi için PDFium Component sayfasında listelenir