Klasik belirti bir kaydırma (off-by-one) hatası gibi görünür: üç sayfalık bir belgenin 1. sayfasını isteyen bir sayfa kopyalama yordamı tutarlı biçimde 2. sayfayı alır. İndeksleme mantığı sağlamdır. Çağrı 0 tabanlı mantıksal bir indeks kullanır, aritmetik doğrudur, sınır koşulları yerindedir. Yine de her seferinde yanlış sayfa çıkar
Asıl neden hiç kopyalama kodunda değildir. Sorun, yükleyicinin sayfa dizisini nasıl kurduğundadır ve PDF ayrıştırmada düşülmesi en kolay tuzaklardan biridir
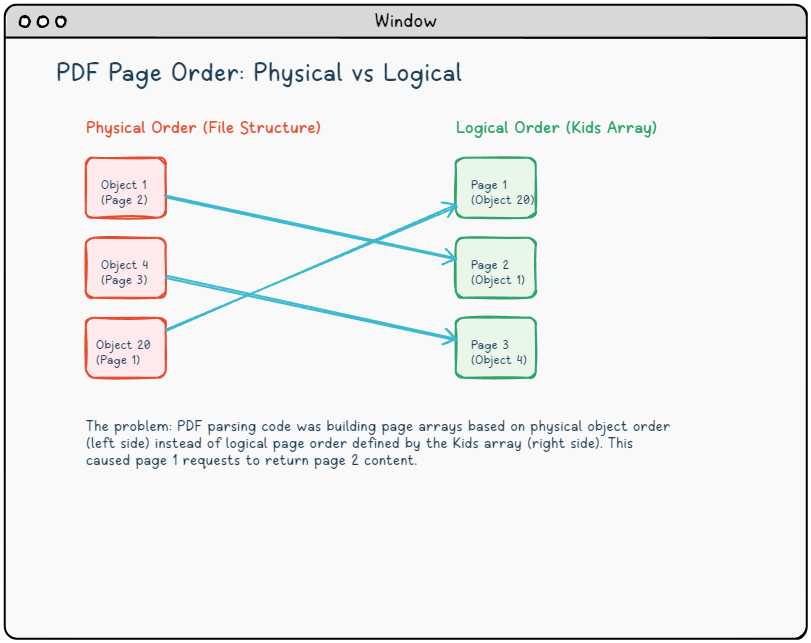
İki sıralama, tek bir karışıklık kaynağı
Bir PDF dosyası, her biri bir nesne numarasıyla tanımlanan dolaylı nesneler topluluğudur. Dosya yapısı, bu numaraların okuma sırasını yansıtması için hiçbir zorunluluk getirmez. Nesne 1, sayfa 2'yi tutabilir; nesne 20, sayfa 1'i tutabilir. Okuma sırasını asıl tanımlayan şey sayfa ağacıdır: /Kids dizileri sayfa başvurularını (referanslarını) bir görüntüleyicinin (viewer) bunları göstermesi gerektiği sırayla listeleyen /Pages sözlüklerinden oluşan bir hiyerarşi (ISO 32000-1 §7.7.3)
Tuzağı gözler önüne seren sayfa ağacı şöyle görünür:
{ Sayfa ağacı kökü, nesne 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { mantıksal sayfa 1 }
         1 0 R    { mantıksal sayfa 2 }
         4 0 R]   { mantıksal sayfa 3 }
>>
endobj
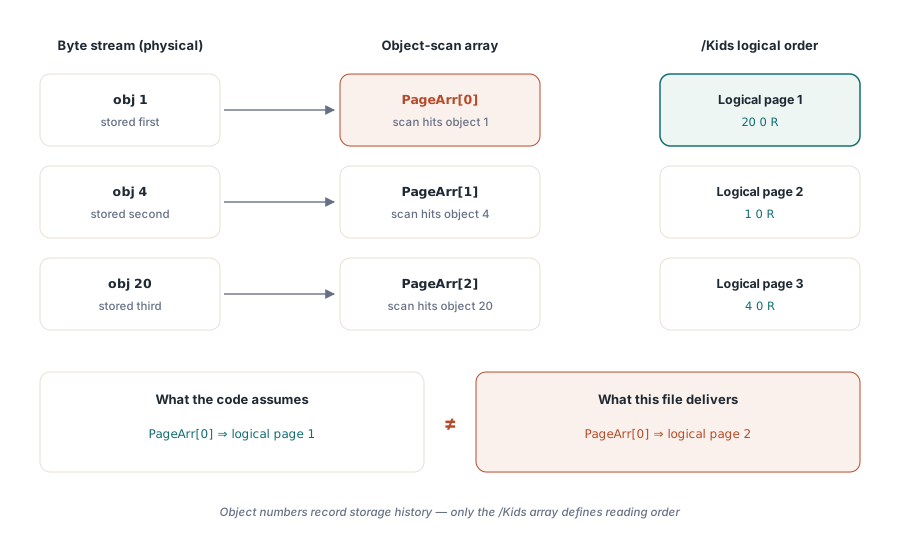
Dosya, bayt akışında nesne 1 ile nesne 4'ü tesadüfen nesne 20'den önce listeliyordu. Dolaylı nesneler üzerinden dosya sırasında ilerleyen ve sayfa türü sözlüklerle karşılaştıkça bunları bir PageArr'e damgalayan herhangi bir ayrıştırıcı, 0 indeksinde nesne 1'i, 1 indeksinde nesne 4'ü ve 2 indeksinde nesne 20'yi bulur. Mantıksal sayfa 1, PageArr[2]'de oturur. 0 sayfa indeksi istemek ise mantıksal sayfa 2'yi getirir
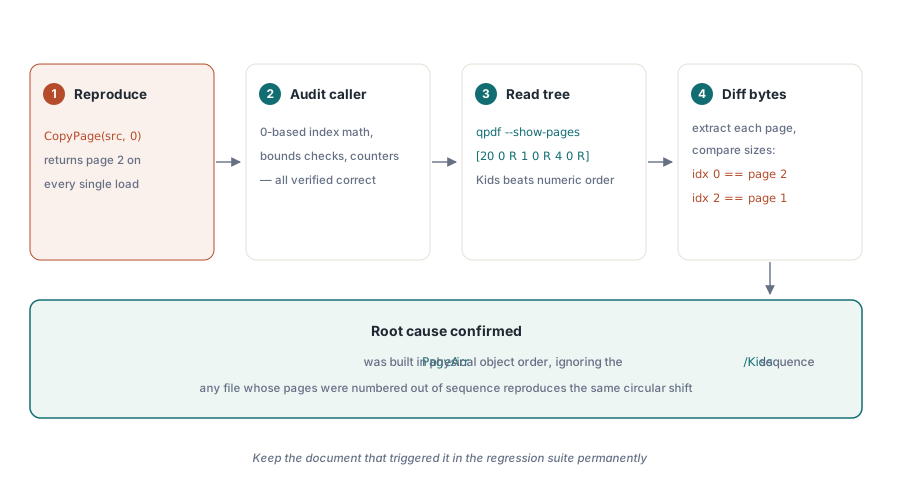
Hipotezi doğrulamak
Herhangi bir koda dokunmadan önce uyumsuzluğu varsaymak yerine kanıtlayın. qpdf komut satırı aracı bunu kolaylaştırır:
{ kabuk (shell) }
qpdf --show-pages input.pdf
{ Çıktı Kids sırasını gösterir: 20 0 R, sonra 1 0 R, sonra 4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ /Kids dizisini okuma sırasındaki haliyle içeren Pages sözlüğünü gösterir }
Her sayfayı tek tek çıkarıp dosya boyutlarını karşılaştırmak eşlemeyi doğrular: bir nesne taramasının PageArr[0]'ının ürettiği şey mantıksal sayfa 2'ye ait içeriktir ve PageArr[2] mantıksal sayfa 1'i tutar. Dairesel kayma, bariz kanıttır. Bu, aynı zamanda belirtinin neden pek çok farklı kaynak belgede ortaya çıktığını da açıklar: sayfa nesnelerinin tesadüfen önceki bir mantıksal sayfadan daha düşük nesne numaralarına sahip olduğu herhangi bir PDF bunu tetikler
PDF'lerin bu duruma düşmesinin doğrudan bir nedeni vardır. Artımlı (incremental) bir güncelleme, değiştirdiği nesnelerin nesne numaralarını korur; ama eklediği her şey -örneğin önüne yerleştirilen bir kapak sayfası- dosyada zaten bulunan her şeyin üstünde yeni bir numara alır, başvurusu ise Kids dizisinin başına gider. Belgeleri birleştiren ya da yeniden düzenleyen araçlar, nesneleri kendilerine uygun olan sırayla yeniden numaralandırır. Bazı oluşturucular da sayfaları, mantıksal sayfa dizisi yerine içerik akışına elverişli bir sırada yazar. PDF formatı hiçbirine aksini yapmalarını gerektirmez
Doğru yaklaşım: Kids dizisini izleyin
Sayfa listesini, dolaylı nesneleri taramak yerine katalog kökünden /Kids zincirini yürüyerek kurun. Bu yürüyüş özyinelemeli olmak zorundadır, çünkü büyük bir belge genellikle sayfalarını ara /Pages düğümlerine dağıtır ve kendi atasına geri işaret eden bozuk bir ağaca karşı korunmalıdır. Aşağıdaki taslakta TPdfDict ve TPdfArray, ayrıştırıcınızın kullandığı sözlük ve dizi türlerinin yerine geçer:
type
  TPageList = array of TPdfDict;

procedure CollectPages(Node: TPdfDict; var Pages: TPageList;
  Depth: Integer = 0);
var
  Kids: TPdfArray;
  Child: TPdfDict;
  I: Integer;
begin
  if Depth > 64 then  // bir döngü veya patolojik derinlikte bir ağaç
    raise EPdfError.Create('Page tree too deep or cyclic');
  Kids := Node.GetArray('Kids');
  if Kids = nil then
    Exit;
  for I := 0 to Kids.Count - 1 do
  begin
    Child := Kids.ResolveDict(I);  // dolaylı başvuruyu izleyin
    if Child = nil then
      Continue;
    if Child.GetName('Type') = 'Pages' then
      CollectPages(Child, Pages, Depth + 1)  // ara düğüm
    else
    begin
      SetLength(Pages, Length(Pages) + 1);   // yaprak: gösterim sırasındaki sonraki sayfa
      Pages[High(Pages)] := Child;
    end;
  end;
end;

// Kullanım: kataloğun /Pages girdisinden başlayın
SetLength(Pages, 0);
CollectPages(Catalog.ResolveDict('Pages'), Pages);
if Length(Pages) <> Catalog.ResolveDict('Pages').GetInteger('Count') then
  LogWarning('Page tree /Count disagrees with the pages actually found');
İki ayrıntı kasıtlıdır. /Type girdisi olmayan bir yaprak yine de sayfa sayılır, çünkü bazı yazıcılar bu girdiyi atlar ve görüntüleyiciler o dosyaları yine de açar. Son /Count karşılaştırması ise neredeyse bedavadır ve kırpılmış ya da elle düzenlenmiş ağaçları, bir çağırıcı içine indeks atmadan önce yakalar
Belgeleri HotPDF ile yüklüyorsanız bu sıralama, belge yüklenirken çoktan çözülmüş olur: sayfa indeksleri, iç içe /Pages düğümleri dâhil sayfa ağacının gösterim sırasını izler; dolayısıyla 0 indeksi daima görüntüleyicinin gösterdiği ilk sayfadır. Yukarıdaki yürüyüş, kendi kodunuz PDF yapısını doğrudan ayrıştırdığında önem taşır
CopyPageFromDocument ile mantıksal indekse göre kopyalama
HotPDF sayfa sırasını yükleme anında çözdüğü için mantıksal sayfa indeksleri, çağırıcıların beklediği anlama gelir. Üst düzey CopyPageFromDocument, 0 tabanlı mantıksal bir indeks alır ve doğru sayfayı hedef belgeye kopyalar:
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { Mantıksal sayfa 0'ı kopyala (kullanıcının gördüğü ilk sayfa) }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;
İndeks bir gösterim-sırası indeksi olduğu için CopyPageFromDocument, fiziksel ve mantıksal sıranın ayrıştığı belgelere karşı bile doğru davranır. Batch işlemleri için InsertPagesFromDocument mantıksal indekslerden oluşan bir dizi alır ve hepsini tek geçişte kopyalar
Bu PDF ayrıştırma hakkında neyi ortaya koyuyor?
PDF belirtimi açıktır: mantıksal sayfa sırası, nesne numaraları veya bayt ofsetleriyle değil, sayfa ağacının /Kids dizisiyle tanımlanır (ISO 32000-1 §7.7.3.2). Kısayol olarak farklı bir sıralama kullanan herhangi bir ayrıştırıcı (parser) gördüğü belgelerin çoğunda doğru sonuçlar üretecektir, çünkü çoğu oluşturucu (generator) sayfaları doğal sırada yazar ve ardışık nesne numaraları atar. Hata, birisi artımlı (incremental) olarak düzenlenmiş, başka bir araç tarafından yeniden düzenlenmiş veya farklı bir düzen seçen bir yazılım tarafından oluşturulan bir PDF yükleyene kadar gizlenir
Yalnızca kendi ürettiğiniz PDF'lere karşı test yapmak, bu sorun sınıfını tamamen gözden kaçırır. Sayfa sırası işleme, çeşitli kaynaklardan gelen belgelerden oluşan bir test derlemine ihtiyaç duyar: artımlı kaydetmeler, eklenmiş kapak sayfalı taranmış belgeler, nesne grafiğini farklı biçimlerde doğrusallaştıran veya optimize eden araçların ürettiği PDF'ler. Fiziksel ve mantıksal sırası ayrışan her belge, o derlemede kalıcı bir yer hak eder
HotPDF Delphi Component sayfası, CopyPageFromDocument, InsertPagesFromDocument ve MovePage dâhil olmak üzere sayfa işlemleri için tam API'yi kapsar