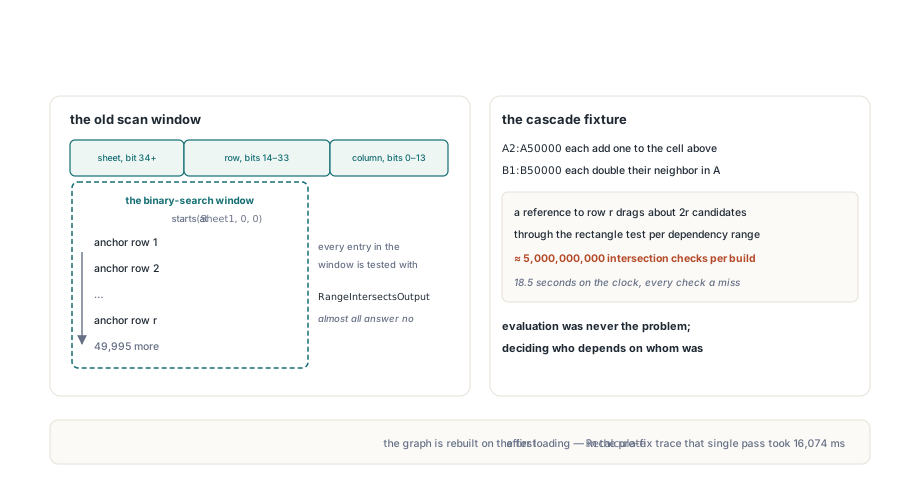
A sütununda her biri bir üstteki hücreye bir ekleyen 50.000 formülle, B sütununda da komşusunu ikiye katlayan başka 50.000 formla dolu bir sayfa, bir hesap tablosu modelinin olabileceği en düz halidir. Onu değerlendirmek 100.000 toplama ve çarpmaya mal olur. Değerlendirme sırasını bulmak ise kenar kurucu bariz şekilde yazıldıysa katbekat pahalıya gelir: başvurulan sayfanın tepesinden başvurulan satıra dek her formülü ara, her birini çakışma yönünden sına, isabetleri tut. Yalnızca bu tek sayfa için yaklaşık beş milyar dikdörtgen sınaması çıkar ve bunların neredeyse tamamı hayır der
Beş milyar kronometreden değil aritmetikten geliyor. r satırına bir başvuru, arama penceresine kabaca 2r aday çeker; her üstteki satır için sütun başına bir aday, ve bunun 100.000 başvuru üzerinden toplamı milyarlara ulaşır. Asıl ilginç olan, pencerenin gerçekten de sayfanın tepesinden başlamak zorunda olmasıdır — tembellikle alakası olmayan bir nedenle
Bağımlılık yeniden kurulumu zamanını nerede harcar
HotXLS yeniden hesaplama motoru, formül topolojisi değiştiğinde formül bağımlılık grafiğini yeniden kurar: çalışma kitabı yüklendikten ya da üretildikten sonraki ilk Recalculate ve formüllerin yeniden yazılmasının, sayfaların eklenip çıkarılmasının ya da bir hücre bloğunun klonlanmasının ardından gelen ilk Recalculate. İki çalışma kitabı sınıfı da, TXLSWorkbook ile TXLSXWorkbook, bunun için lxDepGraph birimindeki TXLSDepGraph'ı kurar. Her formül hücresi, bir çapası (Row, Col) ve (OutRow2, OutCol2)'ye uzanan bir çıktı dikdörtgeni olan tek düğüm olur. Sıradan bir formül için dikdörtgen, çapa hücrenin kendisidir
Düğümler XLSDepMakeKey'den çıkan paketlenmiş 64 bitlik bir anahtarla sıralanır: sütun 0–13. bitlerde, satır 14–33. bitlerde, sayfa indeksi 34. bitten yukarıda durur. Bu anahtara göre sıralama, sayfa önce satır sonra düzeni verir; böylece bir başvuru için önemli olabilecek son formülü bulmak (Sheet2, Row2, 16383) üzerinde tek bir ikili aramadır. Birincisi sorun. Alt sınır (Sheet1, 0, 0), yani başvurulan sayfanın en tepesi olmak zorundadır ve iki sınır arasındaki her şey aday olur
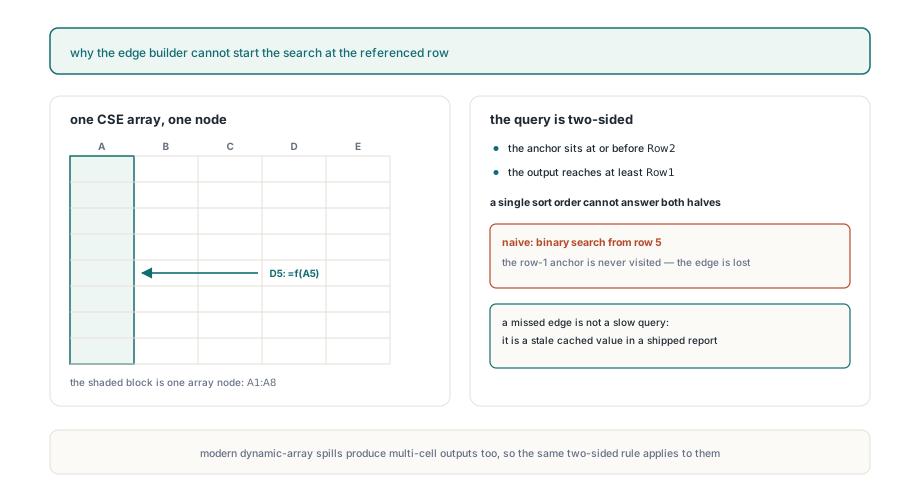
Arama neden başvurulan satırdan başlayamaz?
Bir aralığın üstüne çakılı bir dizi formül, aralığın içindeki hücrelere sahip çıkabilir. Bir TXLSXWorkbook'ta A1:A8'e girilmiş bir CSE dizisi, çapası A1 olan ve çıktısı 8. satıra dek inen tek düğümdür; artımlı yeniden hesaplama ve bağımlılık grafiği makalesi bunu anlatır. Yalnızca A5'i okuyan D5 formülünün bile o düğümden bir kenara ihtiyacı vardır. İkili aramayı 5. satırdan başlatın; 1. satırdaki çapa hiç ziyaret edilmez, kenar hiç kaydedilmez ve D5 bağımlı olduğu diziden önce değerlendirilebilir. Belirti, kaydedilen çalışma kitabında eski bir önbellek değeridir; yavaş bir yeniden hesaplamadan çok daha zor fark edilir
Demek ki gerçek sorgunun iki yüzü var. Bir düğüm, çapası Row2'de ya da öncesindeyse ve çıktısı en az Row1'e ulaşıyorsa, başvurunun içindeki bir sayfada ve çakışan sütunlarla, adaydır. Çapaya göre sıralama ilk yarısını yanıtlar. Çapa düzeninin ikinci yarısıyla ilgili söyleyeceği bir şey yoktur; çünkü 3. satırdaki bir formül tek hücre de üretebilir bin satır da. What-if veri tabloları aynı biçimdedir: TXLSXWorkbook her veri tablosunu, sonuç alanının tamamını kaplayan bir düğüm olarak kaydeder. Dinamik dizi formülleri başka bir yoldan gider ve volatile işaretlenir; her geçişte yeniden hesaplanır. Dinamik dizi spill formülleri makalesi taşan aralıkların nasıl davrandığını işler
TXLSDepGraph herkese açık bir sınıftır; bu yüzden vakayı çalışma kitabı olmadan yeniden üretmek kolaydır. Sayfa indeksleri 1 tabanlı, satır ve sütunlar 0 tabanlıdır; hesaplayıcının koordinatlarıyla eşleşir. Aşağıdaki sondaj dizi kökünü ve okuyucuyu kaydeder, kenarları kurar ve üstelik sonraki bölümlerin dayandığı sayacı göstermek için aynı grafik türü üzerinden ters bir nokta-başvuru zinciri de çalıştırır
uses
  System.SysUtils, lxDepGraph;

function PointRef(ASheet, ARow, ACol: Integer): TXLSDepRange;
begin
  Result.Sheet1 := ASheet;
  Result.Sheet2 := ASheet;
  Result.Row1 := ARow;
  Result.Row2 := ARow;
  Result.Col1 := ACol;
  Result.Col2 := ACol;
  Result.LookupScan := False;
end;

procedure ProbeOutputIndex;
const
  N = 100000;
var
  G: TXLSDepGraph;
  Deps: TXLSDepRangeList;
  Reader, Row: Integer;
begin
  Deps := TXLSDepRangeList.Create;
  G := TXLSDepGraph.Create;
  try
    // CSE dizi: çapa A1 (satır 0, sütun 0), çıktı A8'e dek (satır 7)
    G.AddNode(1, 0, 0, 7, 0, False, nil);
    // D5 (satır 4, sütun 3) yalnızca A5'i okur
    Deps.Add(PointRef(1, 4, 0));
    Reader := G.AddNode(1, 4, 3, 4, 3, False, Deps);
    G.BuildEdges;
    Writeln('D5 precedents: ', G.Nodes[Reader].PrecedentCount);  // 1, A1 kökü
    Writeln('rectangles tested: ', G.EdgeCandidateChecks);       // 2: A1 kökü ve D5'in kendisi
  finally
    G.Free;
  end;

  // A1..A100000 zinciri, her hücre bir üsttekini okur, dibe dayanarak eklendi
  G := TXLSDepGraph.Create;
  try
    for Row := N - 1 downto 0 do
    begin
      Deps.Clear;
      if Row > 0 then
        Deps.Add(PointRef(1, Row - 1, 0));
      G.AddNode(1, Row, 0, Row, 0, False, Deps);
    end;
    G.BuildEdges;
    Writeln('chain checks: ', G.EdgeCandidateChecks);  // N - 1 = 99999
  finally
    G.Free;
    Deps.Free;
  end;
end;
Alt ağaçları en büyük çıktı satırına göre budamak
TXLSDepGraph.BuildEdges, üst sınır için çapa sıralamasını korur ve alt sınırı sıralı düzenin üzerine yerleştirilmiş bir max takviyeli segment tree ile yanıtlar. Her ağaç girdisi, altındaki tüm düğümlerin en büyük OutRow2 değerini saklar. Sorgu yalnızca anahtar penceresinin içinde aşağı iner ve kayıtlı en büyüğü Row1'in üstünde kalan her alt ağacı bırakır; çünkü o alt ağaçtaki hiçbir formül başvurulan satırlara ulaşamaz. Hayatta kalan düğümler yine de tam dikdörtgen sınamasına girer; sayfa aralığı ve sütunlar tıpkı önceki gibi denetlenir
Teknik, baştan sona gösterilmeye kadar küçük. Aşağıdaki taslak, bu makale için yazılmış kendi adlarına sahip asgari bir sürümdür; adların hiçbiri HotXLS API'si değildir ve dizileri, çapa anahtarına göre çoktan sıralanmış bir çıktı satırı listesinden okuyucu doldurur
uses
  System.Math, System.Generics.Collections;

// Yalnızca taslak: çapa anahtarına göre sıralı düğümler üzerinde max takviyeli segment tree.
// OutRow2[i], sıralı düzendeki i. düğümün son çıktı satırıdır.
type
  TOutputIndex = record
    OutRow2: TArray<Integer>;
    MaxRow: TArray<Integer>;   // SetLength(MaxRow, 4 * Length(OutRow2))
  end;

procedure BuildMax(var Ix: TOutputIndex; Node, L, R: Integer);
var
  M: Integer;
begin
  if L = R then
  begin
    Ix.MaxRow[Node] := Ix.OutRow2[L];
    Exit;
  end;
  M := (L + R) shr 1;
  BuildMax(Ix, Node * 2, L, M);
  BuildMax(Ix, Node * 2 + 1, M + 1, R);
  Ix.MaxRow[Node] := Max(Ix.MaxRow[Node * 2], Ix.MaxRow[Node * 2 + 1]);
end;

// Soldan sağa, [Lo, Hi) içindeki çıktısı Row1'e ulaşan her düğümü toplar
procedure Query(const Ix: TOutputIndex; Node, L, R, Lo, Hi, Row1: Integer;
  Hits: TList<Integer>);
var
  M: Integer;
begin
  if (R < Lo) or (L >= Hi) or (Ix.MaxRow[Node] < Row1) then
    Exit;                        // pencerenin dışında ya da Row1'e ulaşan yok
  if L = R then
  begin
    Hits.Add(L);                 // çağıran yine de tam dikdörtgen sınamasını çalıştırır
    Exit;
  end;
  M := (L + R) shr 1;
  Query(Ix, Node * 2, L, M, Lo, Hi, Row1, Hits);           // önce sol
  Query(Ix, Node * 2 + 1, M + 1, R, Lo, Hi, Row1, Hits);   // tarama düzenini korur
end;

// Bir kez BuildMax(Ix, 1, 0, Count - 1) ile kurun,
// sonra başvuru başına Query(Ix, 1, 0, Count - 1, Lo, Hi, Row1, Hits) çağırın
Başvuru başına iş, pencerenin boyutundan O((k + 1) log n)'e düşer; k, çıktısı başvurulan satırlara gerçekten ulaşan düğümlerin sayısıdır. Giriş modeline dönersek: Br'den Ar'ye bir başvuru artık iki dikdörtgen sınar, Ar ile Br'nin kendisini; Ar'den bir üstteki hücreye başvuru da o satırdaki iki düğümü sınar. Elle hesaplayınca tam kurulum için beş milyar yerine kabaca 200.000 sınamadır
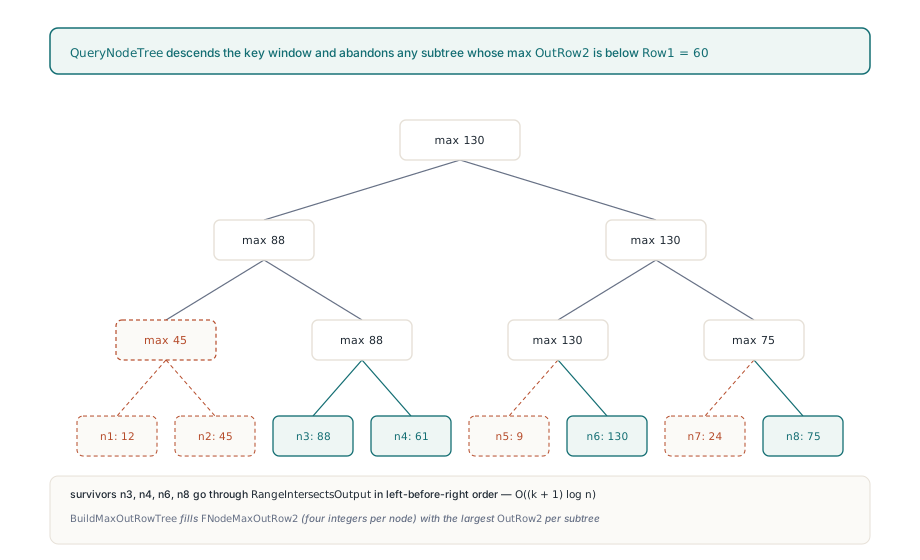
Aynı kenarlar, aynı düzende
Soldan-sağa özyineleme göründüğünden daha önemlidir. Hayatta kalan düğümler, pencere üzerinde düz bir döngünün ziyaret edeceği sıranın birebir aynısıyla ziyaret edilir; böylece her düğümün Dependents ve Precedents dizileri aynı dizilimde dolar ve bunlardan kurulan topolojik sıra her koşuda aynı çıkar. O sıra yalnızca iç defter tutma da değildir: grafik güncelken XLSX yazıcısı xl/calcChain.xml'i FullTopoOrder'ın döndürdüğü düzende yazar; deterministik olmayan bir ziyaret düzeni, değişmemiş bir çalışma kitabının iki kaydı arasındaki gürültülü diff'lerde kendini gösterirdi
Kenar türleri de kurallarını korur. VLOOKUP, MATCH, XLOOKUP ve benzeri işlevlerin lookup-array argümanında duran başvurular lookup-scan kenarı üretir; kirletmeyi yaygınlaştırırlar ama döngü tespitinin dışında kalırlar. Bir düğümün aynı öncüle hem katı başvurusu hem lookup başvurusu olduğunda, önce kaydedilen katı kenar sonraki scan kenarını bastırır; önce kaydedilen scan kenarı yerini korurken katı kenar yine de eklenir. lookup aralıklarının yanlış döngüsel başvurular üretmesini önleyen düzen budur ve buda işleminin adayları tarama düzeninde ziyaret etmesi koşuluyla geçerlidir
EdgeCandidateChecks özelliği budamayı gözlemlenebilir kılar. En son BuildEdges çağrısının gerçekten sınadığı çıktı dikdörtgenlerini sayar ve her kurulumun başında sıfırlanır. Yukarıdaki sondajda ters zincir 99.999 bildirir — başvuru başına bir sınamayı — üstelik düğümler dibe dayanarak eklenmişken ve sıralama hepsini yeniden dizerken. AddNode hem sıralamayı hem kenarları bayat işaretler; böylece bir sonraki BuildEdges ya da NodeIndexOf indeksi yamamak yerine yeniden kurar
Kalan maliyetin oturduğu yer
Ağaç yalnızca satırlar üzerinden budar ve bu seçim, büyük bir modelin hâlâ neye ödeme yapacağını biçimlendirir
- Sütun ıskaları yapraklarda ödenir:
A100:Z200'ü dolduran 2.626 formülün tamamı 100. satıra ulaşır;AA100:AA200'e bir başvuru, sütunlar üzerinden reddetmeden önce her birini sınar - Tüm sütun ve öbür geniş başvurular gerçekten çok öncüle sahiptir; indeks boşa giden sınamaları kaldırır ve gerçek kenarların kurulması sayılarıyla orantılı kalır
- Birkaç sayfaya yayılan bir başvuru, ilk sayfanın tamamını kaplayan bir pencere açar; oradaki derin çıktılı formüller yaprak sınamasına ulaşır. Kenarlar aynı çıkar, yalnızca budama zayıflar
- Ağaç düğüm başına dört tamsayı alır; 100.000 formül için kabaca 1,6 MB ve her topoloji değişikliği, sıradaki kenar kurulumunda tam bir O(n log n) yeniden sıralama artı O(n) ağaç kurulumu öder
Satırlar, indekslenecek doğru tek boyuttur. Üretilen raporlar, defterler ve finansal modeller aşağıya doğru büyür; boşa giden adayların neredeyse tamamı satır uzaklığından gelir, oysa bir sütun ıskası dikdörtgen sınamasında bir avuç tamsayı karşılaştırmasıyla elenir. Ağaca ikinci bir boyut eklemek, çoktan ucuz olan sınamalardan tasarruf uğruna her sorguyu karmaşıklaştırır
Çağıran tarafta pahalı adım yeniden kurulumdur ve değer düzenlemeleri onu tetiklemez. Recalculate grafiği ilk çağrısında kurar; sonraki çağrılar yalnızca değişen değerlerin akıntı yönündeki formülleri ve volatile olanları yeniden değerlendirir. Önce bütün formülleri yazıp bir kez yeniden hesaplatmak hedeflenecek desendir. Aşağıdaki düzenek klasik motor üzerinde iki çeşit geçidi de süreler; Recalculate değerlendiremediği formül hücresi sayısını döndürür. Toplu işi barındıracak donanımda çalıştırın, çünkü mutlak süreler makineye çok bağlıdır
uses
  System.SysUtils, System.Diagnostics, lxHandle;

procedure TimeCascadeRecalc;
var
  Wb: TXLSWorkbook;
  Sh: TXLSWorksheet;
  I, Failed: Integer;
  Watch: TStopwatch;
begin
  Wb := TXLSWorkbook.Create;
  try
    Sh := Wb.Sheets.Add;
    Sh.Cells[1, 1].Value := 1;
    for I := 2 to 50000 do                     // A sütununda 49.999 halkalı zincir
      Sh.Cells[I, 1].Formula := '=A' + IntToStr(I - 1) + '+1';
    for I := 1 to 50000 do                     // B sütununda 50.000 bağımlı
      Sh.Cells[I, 2].Formula := '=A' + IntToStr(I) + '*2';

    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // grafiği kurar, hepsini değerlendirir
    Writeln(Format('first pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));

    Sh.Cells[1, 1].Value := 10;                // değer düzenlemesi: grafik yeniden kullanılır
    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // yalnızca bayat alt grafik
    Writeln(Format('value pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));
  finally
    Wb.Free;
  end;
end;
Bu modelde değer geçidi yine de 99.999 formülün hepsini yeniden değerlendirir; çünkü A sütununun tamamı A1'e asılıdır. Atladığı şey grafik kurulumudur. Bir formül hücresini sade bir değerle yazmak başka bir meseledir; topolojiyi değiştirir ve sıradaki Recalculate grafiği sıfırdan kurar
Klonlanan tanımlı adlarda aynı karesel biçim
Rapor bantları aynı deseni başka bir yerde saklar. TXLSXWorksheet.CloneRangeTo, klonlanan bloğun içindeki bir aralığa doğrudan işaret eden tanımlı adları kopyalar ve her kopya kendi kapsamında eşsiz bir ad ister: Total_2, Total_3 ve devamı. Her kopyada _2'den yeniden başlayan bir arama her seferinde bir aday daha yoklar; yüzlerce klonlanmış banttan kurulu bir sayfa, adlandırma için tek başına karesel sayıda ad araması harcar
TXLSXDefinedNames bundan, ad indeksinde tuttuğu bir son ek ipucuyla kaçınır; her temel ad ve kapsam için bir tane. Sıradaki arama, bir önceki seferde döndürülen sonekten başlar ve onu önce yeniden denetler; çünkü çağıran o adı eklememek konusunda serbesttir. Bir adı silmek, Name üzerinden yeniden adlandırmak, SheetIndex ile taşımak ya da koleksiyonu temizlemek, indeksi bütün ipuçlarıyla birlikte düşürür; sıradaki kopya ilk boş soneke geri döner ve değişikliğin açtığı boşluğu doldurur
Büyük hesap tabloları üreten ya da yeniden hesaplayan Delphi ve C++Builder uygulamaları için Delphi ve C++Builder için HotXLS Excel bileşeni, bu indeksli bağımlılık grafiğini hem klasik hem XLSX çalışma kitabı sınıflarının yeniden hesaplama motorunda kullanır