Kiril modelini yükleyip Çince karakter sözlüğünü okumaya devam eden bir tanıyıcıya verilen Rus fatura, kusursuz biçimde geçerli Han karakterleri sıraları olarak geri gelir. Her satır sağlam UTF-8'dir, her satır aranabilir metin katmanına düşer ve sayfada basılı herhangi bir kelime için yapılan arama hiçbir şey bulamaz. Model kendi işini yapmıştır. CTC tanıyıcı asla karakter çıktılamaz, yalnızca sınıf numaraları üretir; 1.204 numaralı sınıfı bir glyphe eşleyen tek şey sözlük dosyasıdır
Yakından akraba üç arıza daha vardır ve Latin yazılı bir demo bunların hiçbirini göstermez: her satırın son karakterini kaybetmesi, İngilizce metnin kelime boşluklarından yoksun gelmesi ve Arapça metin kutularının soldan sağa sırada geri gelmesi. Her biri neredeyse doğru yapması kolay bir sözlük kuralına, döngü sınırına veya sıralama düzenine dayanır. Dördü de aynı noktadan başlar: bir dil etiketini model ve sözlüğe çeviren adımdan
HotPDF'de RapidOCR dil ön ayarları: bir etiket, bir sabit çift
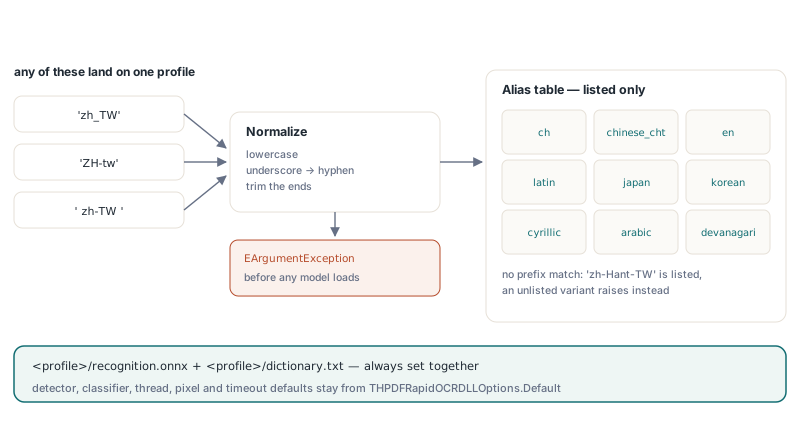
HotPDF'de THPDFRapidOCRDLLOptions.ForLanguage, bir dil etiketini model dizininizin altındaki <profile>/recognition.onnx ve <profile>/dictionary.txt dosyalarını işaret eden optionlara çevirir. Gerisi THPDFRapidOCRDLLOptions.Default'tan gelir: paylaşılan detector, isteğe bağlı angle classifier, tek thread, istek başına 16.777.216 piksel bütçesi ve 60 saniyelik zaman aşımı. Etiket küçük harfe çevrilir, alt çizgiler tire olur, çevresindeki boşluklar kırpılır; böylece 'zh_TW', 'ZH-tw' ve ' zh-tw ' aynı profile çözülür
Eşleştirme, önek eşlemesi olmaksızın açık bir takma ad listesine karşı yürür. 'zh-Hant-TW' ile 'zh-MO' listede durdukları için kabul edilir; 'pt-AO' edilmez ve ForLanguage hiçbir dosya açılmadan EArgumentException fırlatır. Katılık kasıtlıdır: önek kuralı olsaydı 'zh-Hant-SG' ya da gelecekteki herhangi bir etiket, sessizce ilk iki harfi paylaştığı profile giderdi ve Çince işinde ilk iki harf size yazı sistemini söylemez
| Profil | Diller | Örnek etiketler | Satırda kutu sırası |
|---|---|---|---|
ch | Basitleştirilmiş Çince ve İngilizce | zh, zh-CN, zh-Hans, chi_sim | Soldan sağa |
chinese_cht | Geleneksel Çince | zh-TW, zh-HK, zh-Hant, chi_tra | Soldan sağa |
en | İngilizce | en, en-US, en-GB, eng | Soldan sağa |
latin | Fransızca, Almanca, İspanyolca, Portekizce, İtalyanca, Hollandaca, Türkçe | fr, de, es-419, pt-BR, tr | Soldan sağa |
japan | Japonca | ja, ja-JP, jpn | Soldan sağa |
korean | Korece | ko, ko-KR, kor | Soldan sağa |
cyrillic | Rusça, Ukraynaca, Bulgarca, Belarusça | ru, ru-RU, uk, bg | Soldan sağa |
arabic | Arapça, Farsça, Urduca | ar, ar-SA, fa, ur | Sağdan sola |
devanagari | Hintçe, Marathi, Nepalce | hi, mr, ne | Soldan sağa |
Adaptör hiçbir şey indirmiyor. Model dosyaları bir kez, paketle gelen yardımcı ile sağlanır: örneğin tools/Install-RapidOCRModels.ps1 -Destination C:/OCR/models -Language ch,chinese_cht,cyrillic, dokuz profilin tamamı için -Language All. Yardımcı, paylaşılan detector ile classifier dosyasını Default'un beklediği kök adlara, her profili de kendi klasörüne koyar. Engine oluşturma, DLL sınırı ve threading işlerini süreç içi RapidOCR DLL'yi ele alan yazı anlatıyor; dosyalar yerindeyken Basitleştirilmiş Çince bir tarama şöyle aranabilir olur
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeChineseScanSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Models: THPDFRapidOCRDLLOptions;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // ch/recognition.onnx + ch/dictionary.txt, paylaşılan detector ve classifier
  Models := THPDFRapidOCRDLLOptions.ForLanguage('zh-CN');
  // modeller burada yüklenir; engine'i belgeler arasında yeniden kullanın
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Layer := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // boş sayfa listesi = tüm sayfalar; SkipPagesWithText metinli sayfalara dokunmaz
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Layer, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines, ', Info.UniqueScalarCount, ' distinct characters');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
O çıktıdaki iki sayı dikkatle okunmalı. Native pipeline algılanan her metin satırı için tek sonuç bildirir; burada AcceptedWordCount satır sayar ve MinimumConfidence satırın tamamının ortalama karakter confidence'ı ile karşılaştırılır: ortalaması 0,45 olan satır bütün olarak elenir. UniqueScalarCount, metin katmanının fontuna ve ToUnicode tablosuna harcamak zorunda kaldığı farklı Unicode skalerlerinin sayısıdır. Çince gövde metni taşıyan bir sayfa bu sayıyı, Latince bir sayfanın gerektirdiği birkaç düzine skalerin hayli ötesine itmeli; Çince taramada Latince bölgede kalan bir sayı genelde yanlış profilin yüklendiğini gösterir
Yalnızca recognition modelini değiştirmek neden çöp üretir?
Çünkü model ile sözlük tek arama tablosunun iki yarısıdır ve indekslerin ne anlama geldiğini yalnızca sözlük bilir. RecognitionModel'i cyrillic/recognition.onnx'e çevirip CharacterDictionary'yi Çince dosyada bırakın; model geçerli Kiril indeksleri üretir, eski sözlük bunları rastgele Han karakterlerine çevirir. ForLanguage her iki alanı daima birlikte set eder. Elle kurulan optionlar da aynı kurala uymalı: birini ötekisiz asla değiştirmeyin
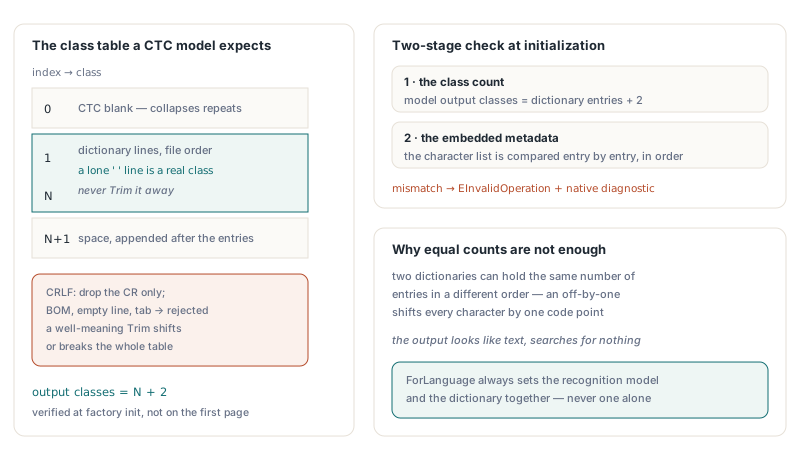
Bariz koruma, sözlük boyutunu model çıktı genişliğiyle karşılaştırmaktır; gerekli ama hâlâ yetmez. İki sözlük aynı sayıda girdiyi farklı sırada tutabilir ve bir kayma her karakteri bir pozisyon öteler. Bu yüzden HotPDF RapidOCR DLL, factory tanıyıcıyı ilklendirirken iki kez kontrol eder. Modelin çıktı sınıf sayısı, sözlük girdileri artı ikiye eşit olmalı. Ardından, ONNX dosyası bir character metadata listesi gömülüyse her sözlük satırı onunla sırayla karşılaştırılır. Hangisi tutmazsa HPDFCreateRapidOCRDLLOCREngine, native tanıyla EInvalidOperation fırlatır; hata böylece müşteri arşivinde değil başlangıçta yüzeye çıkar
"Artı iki" sınıf düzeninden gelir: sınıf 0 CTC blank, 1'den N'e kadar sınıflar dosya sırasındaki sözlük satırlarıdır, son sınıf ise bir boşluktur. Bazı sözlükler kendi tek boşluk girdilerini de taşır ve o satır tam olarak olduğu gibi kalmalı. Burada iyi niyetli bir Trim gerçek hasar verir: boşluk girdisini boş string'e çevirir, tabloyu öteler veya kırar. DLL, CRLF dosyalar yüklenebilsin diye sondaki carriage return karakterini düşürür; UTF-8 byte order mark, boş satır veya tab ya da başıboş bir carriage return taşıyan girdiyi reddeder
Kendi sözlüklerinizi bakıyorsanız, build veya deployment script'inizdeki bir ön kontrol bu sorunları engine'den önce yakalar. Aşağıdaki fonksiyon, yukarıdaki kuralları yansıtacak şekilde yazılmış kendi kodunuzdur
// Kendi yardımcınız, HotPDF API'si değil: CTC tanıyıcının beklediği sınıf
// tablosunu kurar ve DLL'in reddettiği sözlük kusurlarını reddeder
uses
  SysUtils, IOUtils;

function BuildCTCClassTable(const FileName: string): TArray<string>;
var
  Text, Entry: string;
  Lines: TArray<string>;
  I, Last: Integer;
begin
  Text := TEncoding.UTF8.GetString(TFile.ReadAllBytes(FileName));
  if (Text <> '') and (Text[1] = #$FEFF) then
    raise EArgumentException.Create('Dictionary must be UTF-8 without a BOM');
  Lines := Text.Split([#10]);
  Last := High(Lines);
  if (Last >= 0) and (Lines[Last] = '') then
    Dec(Last);                                   // dosya sonundaki satır sonu
  if Last < 0 then
    raise EArgumentException.Create('Dictionary is empty');
  SetLength(Result, Last + 3);
  Result[0] := '';                               // sınıf 0: CTC blank
  for I := 0 to Last do
  begin
    Entry := Lines[I];
    if (Entry <> '') and (Entry[Length(Entry)] = #13) then
      SetLength(Entry, Length(Entry) - 1);       // CRLF: yalnızca CR düşer
    if (Entry = '') or (Pos(#9, Entry) > 0) or (Pos(#13, Entry) > 0) then
      raise EArgumentException.CreateFmt('Invalid dictionary line %d', [I + 1]);
    Result[I + 1] := Entry;                      // asla Trim yok: ' ' bir sınıftır
  end;
  Result[Last + 2] := ' ';                       // son sınıf: boşluk
  // Length(Result), model çıktı sınıf sayısına eşit olmalı
end;
Greedy CTC decoding ve üç sınır tuzağı
Greedy CTC decoding her zaman adımında en yüksek puanlı sınıfı seçer, ardışık tekrarları tek karaktere indirir ve blank karakterini atar. Blank, gerçekten ikilenmiş bir harfin hayatta kalmasını sağlayan şeydir. Tanıma modeli bir metin satırını dar dikey dilimler dizisi olarak okur ve her dilim için her sınıfa bir olasılık çıkarır. AA中 taşıyan bir satır A A blank A 中 space biçiminde bir argmax dizisi üretebilir: ilk iki A adımı teke iner, blank onu bir sonraki A'dan ayırır ve çıktı, sondaki boşluk yerinde olarak AA中 olur. Blank kuralı olmasaydı book ile bok aynı şekilde çözülürdü
Kısa yazılmış bir decoder off-by-one hatalarına davetiye çıkarır ve her hata kendi tanınabilir belirtisini üretir. İç argmax döngüsünü bir sınıf erken kesin: boşluk sınıfı asla kazanamaz, her İngilizce veya Latince satır tek uzun kelime olarak geri gelir ve kalıp arama durur. Dış döngüyü bir zaman adımı erken kesin: her satırın son karakteri kaybolur, iki karakterlik bir etikette bu metnin yarısıdır. Blank'in tekrar korumasını sıfırlamasını unutun: ikilenmiş karakterler çöker, hello'daki ll veya ikileme 谢谢 böyle. Kendi pipeline'ınız için decoder yazacaksanız bu üç durum kompakt bir test seti kurar. HotPDF decoder'ı son sınıfı ve son adımı kapsar, blank ile ayrılmış tekrarları korur ve sonlu olmayan ya da 0 ile 1 dışına düşen puanları, sözlükle uyuşmayan her sınıf sayısıyla birlikte reddeder
// Kendi pipeline'ınız için gösterim, HotPDF API'si değil: doğru sınırlarla
// greedy CTC decoding. Scores, Steps * Classes olasılık taşır,
// zaman adımı başına bir satır
function GreedyCTCDecode(const Scores: array of Single;
  Steps, Classes: Integer; const Characters: array of string): string;
var
  Step, C, Best, Previous: Integer;
  BestScore: Single;
begin
  if (Classes < 3) or (Length(Characters) <> Classes) or
    (Length(Scores) <> Steps * Classes) then
    raise EArgumentException.Create('Model output does not match the dictionary');
  Result := '';
  Previous := 0;                            // sınıf 0, CTC blank'tır
  for Step := 0 to Steps - 1 do             // son zaman adımını dahil et
  begin
    Best := 0;
    BestScore := Scores[Step * Classes];
    for C := 1 to Classes - 1 do            // son sınıfı (boşluk) dahil et
      if Scores[Step * Classes + C] > BestScore then
      begin
        Best := C;
        BestScore := Scores[Step * Classes + C];
      end;
    if (Best <> 0) and (Best <> Previous) then
      Result := Result + Characters[Best];
    Previous := Best;                       // blank, tekrar korumasını sıfırlar
  end;
end;
Dil modeliyle beam search, greedy decoding'in yanıldığı bazı belirsiz dilimleri çözebilir; karşılığı hızda gerçek bir kayıp ve sürümlenecek ikinci bir dosya setidir. 300 DPI ile render edilmiş basılı belgeler için doğru varsayılan greedy decoding'dir ve decoder, modelin göremediğini telafi etmenin yanlış yeridir. Aynı şey karakter değiştirme tabloları için de geçerli. Model aksanlı harfi taban harfi olarak okuyorsa çıktıyı replacement tablosuyla yamamak bir dili tamir eder, ötekini bozar. Aranabilir katmandaki yanlış karakter, eksik karakterden kötüdür; arama hiç belge yerine yanlış belgeyi bulur. Bu yüzden tanınan metin, modelin ürettiği haliyle PDF'e girer
Sağdan sola Arapçada metin satırları nasıl sıralanır?
DLL, algılanan metin kutularını yukarıdan aşağıya sıralar; kutuları, daha küçük kutu yüksekliğinin en az yarısı kadar dikey örtüştüklerinde tek satırda gruplar ve her satırı soldan sağa, RightToLeft set edilmişse sağdan sola dizer. Tanınan bir satırın içindeki karakterler asla ters çevrilmez. Satır gruplama önemlidir, çünkü detectorlar tek görsel satırı sıkça birkaç kutuya böler; örneğin geniş boşlukla ayrılmış bir etiket ve bir değer. Düz bir üst koordinat sıralaması, üstleri bir iki piksel farklı olduğu an bunları bir sonraki satırla iç içe geçirirdi
Arapça profil, ForLanguage'in RightToLeft := True set ettiği tek profildir; bu, DLL'in her satırı sağ kenar boşluğundan başlayarak kutuların sağ kenarlarına göre dizmesine yol açar. Etki bundan ibarettir. Modelin bir satır için döndürdüğü metin çoktan Unicode mantıksal sırasındadır — Arap okurun okuyup yazdığı sıra — ve PDF metin çıkarımı ile aramanın beklediği sıra da budur. String'i Delphi debugger'ında "doğru görünsün" diye ters çevirmek aramayı, kopyala-yapıştırmayı ve ekran okuyucuları bozar. İki yönlü gösterim ve glyph şekillendirme PDF görüntüleyicisinin işidir
Tek engine tek dil profiline hizmet eder ve otomatik yazı sistemi algılama yoktur. Yazı sistemleri karışan bir belge her profil için bir engine ister, her biri kendi sayfalarına uygulanır. ApplyLoadedOCRTextLayer açık bir sayfa listesi alır ve her çağrıyı kendi işlemi olarak commit eder; Arapça sayfalardaki bir hata, halihazırda yazılmış Çince katmana dokunmadan o çağrıyı geri alır
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

function CreateRapidEngine(const Tag: string): IHPDFOCREngine;
var
  Models: THPDFRapidOCRDLLOptions;
begin
  // listelenmemiş etikette, hiçbir model yüklenmeden EArgumentException fırlatır
  Models := THPDFRapidOCRDLLOptions.ForLanguage(Tag);
  Models.MaxPixels := 33554432;          // 300 DPI'da A3 sayfalar için pay
  Result := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
end;

procedure OCRMixedArchive(Doc: THotPDF);
var
  Chinese, Arabic: IHPDFOCREngine;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Chinese := CreateRapidEngine('zh-TW');  // chinese_cht profili
  Arabic := CreateRapidEngine('ar-SA');   // arabic profili, RightToLeft = True
  Layer := THPDFOCRTextLayerOptions.Default;
  if not Doc.ApplyLoadedOCRTextLayer([0, 1, 2], Chinese, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
  if not Doc.ApplyLoadedOCRTextLayer([3], Arabic, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
end;
MaxPixels satırı oraya bir sebeple konmuştur. İstek başına 16.777.216 piksellik varsayılan bütçe, 300 DPI'da A4 ile US Letter'i bolca karşılar. 300 DPI'da bir A3 yaprak kabaca 3508'e 4961 piksel, 17,4 milyon civarı eder; o istek reddedilir ve Info.Diagnostic geçersiz istek ya da piksel bütçesi bildirir. MaxPixels'i 67.108.864 tavanına kadar yükseltin veya büyük formatlar için THPDFOCRTextLayerOptions.DPI'yi düşürün. Sağdan sola dizim, HPDFRapidOCRSetReadingDirection DLL export'u üzerinden geçer; adaptör bunu yalnızca RightToLeft set edildiğinde arar. O export'u içermeyen bir DLL build'i soldan sağa profillere hizmet etmeyi sürdürür, onunla Arapça engine oluşturmak ise eksik export'u adıyla EArgumentException fırlatır
Sabitlenmiş model paketleri ve özel bir çiftin geçmesi gerekenler
HotPDF RapidOCR DLL, statik derlenmiş bir ONNX Runtime bağlar; bu yüzden yalnızca o runtime'ın anladığı ONNX dosya formatı sürümlerini okur, daha yeni hiçbir şeyi değil. Yeni model export'ları daha yeni bir formatı hedefleyebilir; böyle bir dosya engine oluşturmada native tanıyla reddedilir. Bu eşleştirme yüzünden her dil paketi, paketle gelen runtime altında yüklenen ve sınıf kontrollerini geçen tek bir belirli tanıyıcı ile sözlüğü işaret eder; paketler hiçbir zaman "latest" değildir
Install-RapidOCRModels.ps1 bu eşleştirmeyi diskte zorunlu kılar. Manifest'indeki her dosya bir SHA256 hash taşır. Farklı hash'li mevcut bir dosya kurulumu durdurur ve taşımak ya da silmek için yerinde bırakılır; her indirme geçici bir adla yazılır ve hash'i eşleştikten sonra yerine taşınır. Bu, sözlük probleminin sessiz versiyonunu engeller: biri elle daha yeni bir recognition.onnx'i profil klasörüne kopyalar, sınıf sayısı tesadüfen uyar ve ilk tehlike işareti, görebildiği kelimeleri aramanın bulamadığını söyleyen bir müşteri olur. -SkipClassifier ile kurulum yaptıysanız option'larda UseAngleClassifier := False set edin; çünkü Default classifier dosyasını bekler ve engine oluşturma bunun var olduğunu kontrol eder
Tanıyıcı yükleme anında modelin input şeklini de kontrol eder. Sabit yüksekliği 32 veya 48 piksel olan NCHW float input'unu, ya da dinamik yükseklik kabul eder; dinamik olanı 48 ile çalıştırır. Başka bir sabit yükseklikle export'lanmış model, engine oluşturmada "Unsupported recognition model input or output shape" hatasıyla başarısız olur
Dokuz profilin hiçbirinin kapsamadığı bir yazı sistemi için RecognitionModel ile CharacterDictionary kendi dosyalarınızı işaret edebilir; yukarıdaki her kontrol yine uygulanır. Eşleşmeyen bir çift engine oluşturmada, yani kendi test koşunuzda başarısız olur. Hiçbir RapidOCR profilinin uymadığı sayfalar için aranabilir PDF için Tesseract adaptörü aynı ApplyLoadedOCRTextLayer çağrısına takılır; makine basımı ASCII formlar için yerleşik şablon eşlemeli OCR engine'i hiçbir model dosyası istemez
Dil ön ayarları, native RapidOCR adaptörü ve OCR metin katmanı, Delphi, C++Builder ve Windows FPC/Lazarus projeleri için HotPDF Delphi PDF Component içinde gelir