Bir parser, bozuk bir PDF üzerinde asılı kalır: bir dal bir bayt okur, onu işlemeyi reddeder ve imleci oynatmadan geri döner. Çağıran döngü ne ilerleme görür ne de durmak için bir sebep, o yüzden sonsuza dek döner. HotPDF tam da bu kusuru üç bağımsız parser'da yayınladı ve üçü de elli baytın altındaki girdilerden tetiklenebiliyor
Bu, ayrıca adlandırmaya değer bir denial-of-service sınıfı, çünkü herkesin zaten korunduğu türe benzemiyor. Decompression yok, allocation büyümesi yok, bir watchdog'u tetikleyecek bellek baskısı yok. Süreç tek bir çekirdekte yüzde yüz CPU'da, buffer'da bir avuç baytla öylece oturur. iç içe filter amplifikasyonu ve PDF bombaları hakkında okuyup bir decode bütçesi eklediysen, bu bütçe burada devreye girmez: hiçbir şey decode edilmiyor, hiçbir şey allocate edilmiyor. Farklı arıza, farklı düzeltme
Kırk baytlık bir dosya neden bir decompression bombasından daha pahalıya mal olur?
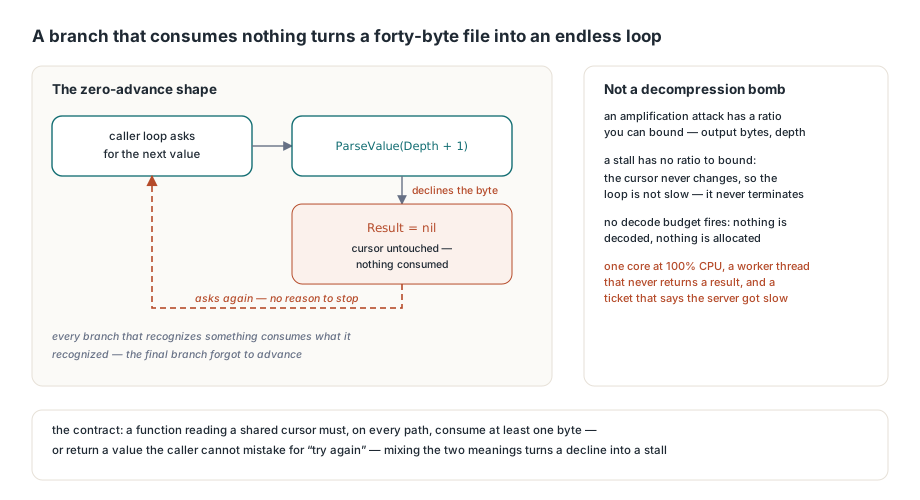
Çünkü maliyetin girdi boyutuyla hiçbir ilişkisi yok. Bir amplifikasyon saldırısının sınırlayabileceğin bir oranı vardır: çıktı baytlarını tavanla, recursion derinliğini tavanla, en kötü durum sonlu olur. Sıfır-ilerleme döngüsünün sınırlayacak bir oranı yoktur. Döngü koşulu hiç değişmeyen bir imlecin fonksiyonu, o yüzden bu yavaşlık değil, sonlanmama; yukarı akıştaki hiçbir boyut limiti bunu yakalayamaz. Operasyonel olarak da benzersiz biçimde çirkin. Bir crash sana stack verir, bir out-of-memory bir log satırı verir, asılı kalan bir parser ise hiç sonuç döndürmeyen bir worker thread, hiç timeout olmayan bir istek — çünkü aşağı akışta hiç kimse başladığını bilmez — ve "sunucu salı günü yavaşladı" diye bir ticket bırakır. Yapısal neden her zaman aynı şekildedir. Bir tokenizer ya da değer parser'ı, geçerli bayta göre anahtarlanan bir dizi dala sahiptir. Bir şeyi tanıyan her dal, tanıdığını tüketir. Sonra bir son dal vardır, ya da zincirden önce bir guard; kimsenin sahiplenmediği baytlar için geri döner ve yazar bunu bir tarama adımı olarak değil, bir hata yolu olarak düşünür. Hata yolları geri döner. Tarama adımları ilerler. Bir fonksiyon ikisi birden olmak zorunda kalınca, unutulan ilerleme olur
Nesne parser'ı: kimsenin tüketmediği iki ayraç
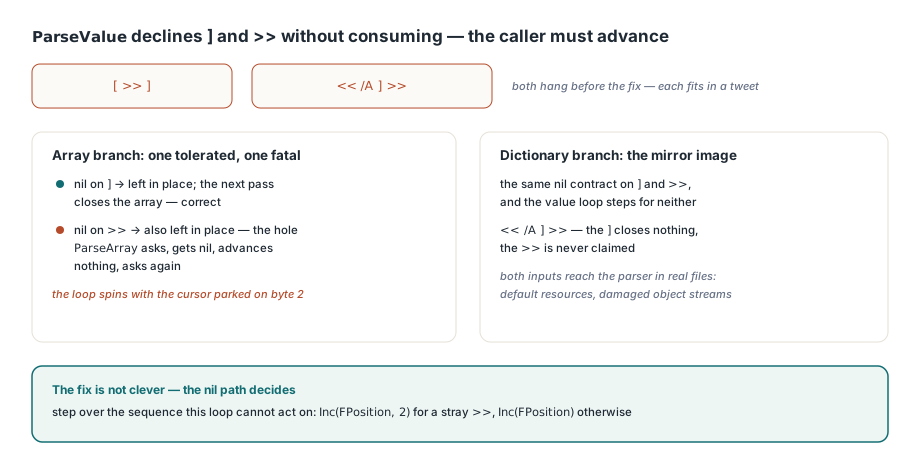
HPDFParser içinde THPDFSpanObjectParser.ParseValue metodu iki bayt dizisini baştan reddederek başlar. ISO 32000-1 bölüm 7.3'e göre bir değer ] ya da >> ile başlayamaz, çünkü bunlar bir değer açmak yerine bir kapsayıcıyı kapatır; ParseValue ikisi için de onları tüketmeden nil döndürür. Bu doğru sözleşmedir ve ilerleme yükünün tamamını çağırana bırakır. Dizi dalı bunun yarısını yerine getiriyordu: nil sonucunda ] olup olmadığına bakıyor, diziyi kapatması için onu sonraki geçişe bırakıyor ve geri kalan her şeyin üzerinden atlıyordu — ancak kontrol öyle yazılmıştı ki başıboş bir >> da yerinde kalıyordu. Yani [ >> ] asılı kalır, çünkü ParseArray bir değer ister, nil alır, hiçbir şeyi ilerletmez ve yeniden sorar. Sözlük dalında da aynanın öbür yüzünde aynı delik vardı ve << /A ] >> aynı şekilde asılı kalır. İki girdi de parser'a ulaşacak kadar geçerli ve bir tweet'e sığacak kadar kısa
uses
  HPDFObjs, HPDFParser;

procedure ProbeParserStalls;
var
  Stats: THPDFParserViewStatistics;
  Arr: THPDFArrayObject;
  Dict: THPDFDictionaryObject;
begin
  // Düzeltmeden önce aşağıdaki iki çağrı da hiç geri dönmüyordu
  Arr := HPDFParserParseSimpleArrayWithStatistics('[ >> ]', Stats);
  Arr.Free;
  WriteLn('array errors=', Stats.ErrorCount, ' valid=', Stats.Valid);

  Dict := HPDFParserParseSimpleDictionaryWithStatistics('<< /A ] >>', Stats);
  Dict.Free;
  WriteLn('dict errors=', Stats.ErrorCount, ' valid=', Stats.Valid);
end;
Düzeltme zekice değil ve mesele de bu: nil yolu, geçerli döngünün tüketilmemiş iki diziden hangisi üzerinde işlem yapabildiğine açıkça karar vermek ve öbürünün üzerinden atlamak zorunda
Value := ParseValue(Depth + 1);
if Value = nil then
begin
  RecordError;
  // ParseValue hem ']' hem de '>>' için onları tüketmeden nil döndürür
  // ']' bir sonraki geçişte diziyi bitirir ama dizi içindeki başıboş bir '>>'
  // atlanmalı, yoksa parse hiç ilerlemez
  if (FPosition < FLength) and StartsWithPair('>', '>') then
    Inc(FPosition, 2)
  else if (FPosition < FLength) and (CharAt(FPosition) <> ']') then
    Inc(FPosition);
  Continue;
end;
Burada bir şey daha dikkati hak ediyor. THPDFSpanObjectParser.RecordError yalnızca THPDFParserViewStatistics içindeki ErrorCount değerini artırır; hiçbir şeyi tavanlamaz. Parser, iç içe geçmeyi sınırlamak için HPDFParserMaximumDepth değerini 64 yapar ama hata sayısında benzer bir tavan yoktur ve hiçbir yerde okunmayan bir sayaç, kaçırılmış bir devre kesicidir. İlerleme geri getirilse bile, bayt başına bir hata üreten bir girdi, tam tarama yerine erken çıkışı hak eden bir oranda büyük bir nesneyi didik didik eder. Her parsenin ardından istatistik kaydındaki Valid değerini kontrol et ve büyük bir ErrorCount değerini yalnızca bir teşhis olarak değil, nesneye güvenmeyi bırakmak için bir sebep olarak gör
CMap tokenizer'ında ve XFDF okuyucusunda aynı şekil
HPDFCMapReader.NextToken fallback dalında birebir aynı kusuru taşıyordu. Fonksiyon bir TCMapTok döndürür; <, ( ve / için ayrı dallar vardır; geri kalan her şey "boşluğa ya da ayraca kadar oku" kısmına düşer. Başlangıç baytının kendisi ISO 32000-1 bölüm 7.2.2 kümesinden bir ayraç olduğunda bu döngü sıfır kez çalışır, token boş döner ve çağıran aynı token'ı yeniden ister. Oraya düşebilecek altı karakterden yalnızca [ daha önce bfrange işlemesi tarafından yakalanıyordu; o yüzden bir ToUnicode CMap'teki başıboş bir ), >, ], { ya da } metin çıkarmayı kilitlemeye yetiyordu
// anahtar sözcük ya da sayı: boşluğa ya da ayraca kadar oku
StartP := P;
while (P <= Len) and (not IsCMapWhiteSpace(Text[P]))
  and (not IsCMapDelimiter(Text[P])) do
  Inc(P);
// Yukarıdaki dalların hiçbirinin sahiplenmediği bir ayraç (başıboş bir ')', '>',
// '[', ']', '{' ya da '}') P'yi olduğu yerde bırakıp boş bir anahtar sözcük
// döndürür, o yüzden çağıran aynı token'ı sonsuza dek isterdi
if P = StartP then
  Inc(P);
AKeyword := Copy(Text, StartP, P - StartP);
Result := ctKeyword;
XFDF tarafında farklı bir kökene ve aynı etkiye sahip bir varyant vardı. HPDFXFDFXml.ParseElement en üstte Result := P yapar — P hâlâ açılış < işaretini gösteriyordur — ve ancak ondan sonra yerel imlecini artırır; o yüzden sonrasındaki her erken çıkış, Result değerini önce üzerine yazmadıkça giriş konumunu döndürür. XML 1.0 bölüm 2.8'e göre bir doctype bildirimi ya da <1a> gibi ayrıştırılabilir bir etiket adı olmayan herhangi bir şey, Result değerini hiç güncellemeyen bir çıkış alıyordu ve alt eleman döngüsü kendisine geçirilen konumu geri alıyordu. Öznitelik döngüsünde de üç tane daha vardı: ReadName, boşluk atlama ve = işleme, ne ad karakteri ne boşluk ne de =, >, / olmayan bir baytı reddediyor ve hiçbiri onu tüketmiyordu. Komşu CDATA onarımı, bir guard eklemek yerine bir sorumluluğu taşıdı: XML 1.0 bölüm 2.7'ye göre bir CDATA bölümü < ile başlar, o yüzden alt döngü onu ParseElement'e devrediyor, o da bölüm içeriğinden bir etiket adı okuyordu. Onu alt döngüde IsCDATAStart ile tanıyıp IsCDATAEnd olana dek baytları metin buffer'ına kopyalamak doğru iş bölümüdür; eski atlama da bir bayt eksikti, çünkü işaret ! sayıldığında sekiz bayt
Veriden daha uzun yaşayan bildirilen sayılar
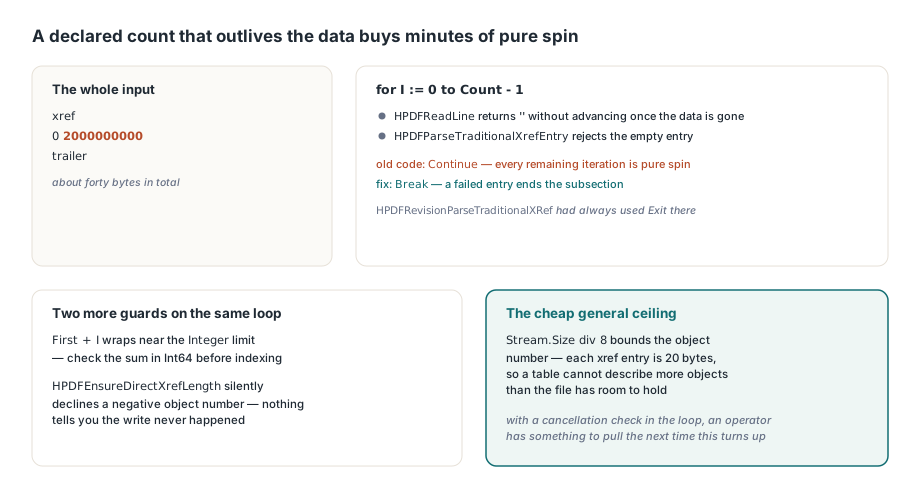
Daha sonraki bir sürüm aynı deseni ters yönden çıkardı ve bu, senin kendi kodunda bulunma olasılığı en yüksek varyant. ISO 32000-1 bölüm 7.5.4'e göre bir çapraz referans alt bölüm başlığı bir first count çiftidir ve HotPDF'in iki geleneksel xref parser'ı da onun üzerinde for I := 0 to Count - 1 döngüsü kuruyor, bir girdi ayrıştırılamadığında Break yerine Continue kullanıyordu. Bu, tek bir kötü satıra hoşgörü gibi okunur. Öyle değil: HPDFReadLine veri tükendiğinde ilerlemeden boş bir dize döndürür ve HPDFParseTraditionalXrefEntry boş bir girdiyi hemen reddeder; o yüzden bildirilen sayının geri kalan her iterasyonu saf dönüş. Aritmetik acımasız: xref\n0 2000000000\ntrailer başlığı ile minimal bir sarmalayıcı kırk bayt civarındadır ve döngünün hiçbir yerinde iptal kontrolü olmadan onlarca saniyelik meşgul bir çekirdek satın alır. İpucu aynı ünitede duruyordu, çünkü HPDFRevisionParseTraditionalXRef o konumda hep Exit kullanmıştı. İki fonksiyon aynı dilbilgisini ayrıştırıp başarısız bir girdinin alt bölümü bitirip bitirmediği konusunda aynı fikirde değilse, biri düzeltmeleri almayı bırakmış bir çataldır — hibrit çapraz referans işleme konusunda geleneksel bir tablo ile bir stream'in aynı nesneleri tanımladığı durumda ortaya çıkan imza da bu
if not HPDFParseIntegerPair(Line, First, Count) then
  Exit;
for I := 0 to Count - 1 do
begin
  Entry := HPDFReadLine(XrefData, P);
  // Tablodan daha büyük bir bildirilen sayı, okunacak veri kalmadan
  // burada sonsuza dek dönerdi
  if not HPDFParseTraditionalXrefEntry(Entry, EntryOffset, GenNum, InUse) then
    Break;
  // First alt bölüm başlığından gelir, o yüzden toplam Integer sınırına
  // yakın bir bildirilen başlangıçta sarar ve büyütme yardımcısı
  // negatif bir indeksi sessizce reddeder
  if (First < 0) or (Int64(First) + I > MaxInt) then
    Break;
  ObjNumber := First + I;
  if (ObjNumber < 0) or (Int64(ObjNumber) > Stream.Size div 8) then
    Break;
  HPDFEnsureDirectXrefLength(State, ObjNumber);
  // ... girdiyi kaydet ...
end;
Break sonrasındaki iki sınır aynı onarımın parçası. HPDFEnsureDirectXrefLength negatif bir nesne numarası için diziyi büyütmeyi reddeder ve bu konuda hiçbir şey söylemez; First + I ise Integer sınırına yakın bir bildirilen başlangıçta sarar, o yüzden negatif bir indeks aşağıdaki yazmalara ulaşır. Stream.Size div 8 nesne numarası tavanı ucuz ve genel cevaptır: hiçbir geleneksel çapraz referans tablosu, dosyanın barındırmaya yeri olduğundan daha fazla nesneyi tanımlayamaz ve başka türlü iddia eden her başlık var olmayan bir dosyayı anlatıyordur. Hasarlı bir tabloyu elle onarıyorsan aynı mantık öbür taraftan işler — elle düzenlenmiş PDF'leri teşhis etme ve onarma notlarının kapsadığı alan da bu
Bir kilitlenme düzeltmesinin gerçekten çalıştığını nasıl kanıtlarsın?
Eski kodu çalıştırarak, yeniden okuyarak değil. Kilitlenme, düzeltmesi ikili bir sinyalle ve enstrümantasyonsuz doğrulanabilen az sayıdaki kusur sınıfından biridir: süreç ya geri döner ya dönmez ve kontrol akışı hakkında akıl yürütmek, hatayı ilk etapta üreten becerinin ta kendisidir. Mekaniği kopyalamaya değer. Düzeltme öncesi revizyonun değişen ünitelerini bir scratch dizinine çıkar, sonra ünite arama yolunu o dizini gerçek kütüphanenin önüne koyacak şekilde tek bir küçük probe derle: dcc32 -U<scratchdir>;<Lib> probe.dpr. Derleyici ilk bulduğu için eski kaynakları, geri kalan her şey için güncel kaynakları alır; o yüzden tek bir probe ikilisi eski parser'ı kütüphanenin geri kalanına karşı çalıştırır. Bir timeout altında çalıştır — kırk saniye cömerttir — ve çıkış kodu 124'ü iddia olarak kabul et. Sonra üniteleri scratch dizininden tek tek çek ve yeniden derle. Üç kilitlenme de bu yolla yeniden üretildi, her biri belirli bir üniteye atfedildi ve üçü de düzeltilmiş kaynak yola geri döndüğünde ortadan kalktı; maliyet ünite başına bir derleme
Denemeden önce bilmeye değer iki tuzak var. Ünite arama yolu sessizce hoşgörülüdür: -U seçeneğine bir kabuktan Unix tarzı bir yol ver, örneğin $PWD, derleyici o dizini tek kelime etmeden yok sayar; bu da probe'unun güncel kaynaklara karşı derlendiği ve yanlış sebepten geçtiği anlamına gelir. Yolu önce yerel Windows biçimine çevir. İkincisi, scratch dizini include dosyalarını taşımaz, o yüzden HotPDF.inc için -I<Lib> de gerekir; yoksa derleme, yol sorunu yerine kaynak sorunu gibi görünen bir şekilde başarısız olur. Ve yöntemin sana vermediği şey konusunda dürüst ol: belirli bir girdinin belirli bir derlemede asılı kalmayı bıraktığını doğrular ve aklına gelmeyen girdiler hakkında hiçbir şey söylemez. Sıfır-ilerleme kusurları, sonradan yazılan regresyon testleriyle değil, fuzzing ile ya da her tokenizer'ın her dalını okuyarak bulunur
Kendi parser'larında neyi denetlemeli
Yeniden kullanılabilir kural bir sözleşmedir, kontrol listesi maddesi değil. Ortak bir imleçten okuyan her fonksiyon, hata yolları dahil her yolda ya en az bir bayt tüketmeli ya da çağıranın "yeniden dene" ile karıştıramayacağı bir değer döndürmelidir. Bu iki anlamı tek bir nil ya da tek bir boş token'da birleştirmek, bir reddi kilitlenmeye dönüştüren şeydir. O yüzden semptomu değil şekli denetle. Sonlandırması başka bir fonksiyonun sahip olduğu bir imlece bağlı her döngüyü bul ve o fonksiyon geçerli baytı reddettiğinde ne olacağını sor. "X'e kadar oku" diye yazılmış her fallback dalını bul ve imleç zaten X'in üzerindeyken ne yaptığını sor. Veriden değil dosyadan gelen bir sayıyla sınırlanan her döngüyü bul ve bir iterasyonu atlamak yerine başarısız bir elemanın döngüyü bitirmesini sağla. Aynı dilbilgisi iki yerde ayrıştırılıyorsa, ikisini diff'le, çünkü biri öbürünün almadığı bir düzeltmeyi almıştır. Ve çağıranın sağladığı iterasyon sayısı kadar çalışabilen her döngünün içine bir iptal kontrolü koy ki, bir sonraki bu tür üretimde ortaya çıktığında operatörün çekeceği bir şey olsun
Burada anlatılan parser'lar, istatistik kayıtları ve derinlik limitleri senin kendi sağlamlaştırmanın üzerine inşa edebileceği şekilde açık olarak, Delphi ve C++Builder için güncel HotPDF Delphi Component içinde yer alıyor