Standart Macintosh glif sırasını koruyan bir TrueType fontta "Total" kelimesi, bir PDF içerik akışında <0037005200570044004F> Tj olarak durabilir. O beş iki baytlık değer gömülü fontun içindeki glif numaralarıdır ve dizenin hiçbir yeri T, o, t, a ve l çizdiklerini söylemez. O baytları UTF-16 diye okursanız 7RWDO dizesini alırsınız; sayfa ise ekranda Total gösterir; çünkü glif çizmek yalnızca kod-glife eşlemesini gerektirir, metni geri almaksa dosyanın hiç taşımamış olabileceği bir kod-Unicode eşlemesi gerektirir
Çıkarılan metin neden anlamsız çıkar?
Bir içerik akışı karakter kodları kaydeder ve anlamları büsbütün fontta yaşar. Tj ve TJ operatörleri (ISO 32000-1 §9.4.3), önündeki Tf'in seçtiği font üzerinden yorumlanan bayt dizeleri taşır: 0x41 baytı WinAnsi altında A harfi, bir subset fontta keyfi bir glif ya da bileşik bir CJK fontta iki baytlık bir CID'in yarısıdır. ISO 32000-1 §9.10, metin çıkarmayı tam olarak bu çözme problemi sayar; her kodu font sözlüğünün sağladığından Unicode'a geri eşler ve uyumlu bir dosyanın bunu yapmaya yetecek bilgiyi vermek zorunda olmadığını açıkça söyler
O madde, gördüğünüz her "bu PDF'ten kopyala yapıştır çöp üretiyor" bildiriminin arkasındadır. /ToUnicode tablosu olmadan subset bir fontu gömen bir üretici, doğru render edilen geçerli bir dosya yazmıştır. Gliflerin hepsi oradadır. Eksik olan, çıkarıcının ikincil kanıtlardan yeniden kurmak zorunda olduğu ters haritadır: fontun bildirdiği kodlama, glif adları, Adobe'nin yayımladığı karakter koleksiyonları, gömülü font programının içindeki cmap tablosu. Bir API'nin bunlardan kaçını denediği ve hepsi başarısız olduğunda size ne verdiği, çıkarma kütüphanelerini pratikte ayırt eden şeydir
ExtractLoadedPageText ile okuma akışı metni
HotPDF Delphi Component, yüklü bir sayfanın okuma akışı metnini function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean üzerinden döndürür. Sayfa indeksleri sıfır tabanlıdır, sonuç yerel bir Delphi UnicodeString'idir ve işlev, sayfanın okunabilir bir içerik akışı yokken özel durum fırlatmak yerine False döndürür. Yüklediğiniz her PDF üzerinde çalışır: müşterinin e-postayla gönderdiği fatura, tarama bürosunun teslim ettiği rapor, hangi yazılımla üretildiği kimsenin hatırlamadığı sözleşme
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');  // sayfa sayısını döndürür
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
  finally
    Pdf.Free;
  end;
end;
Tüm belgeyi tek dizgede isterseniz ExtractLoadedPagesText(PageRange, PageSeparator) '1,3-5,7-' gibi tek tabanlı bir aralık alır (boş dize her sayfa demektir) ve sayfalar arasına PageSeparator'ı — varsayılanı form besleme #12 — koyar. Büyük belgeler ExtractLoadedPagesTextToStream üzerinden daha iyi gider; UTF-8 olarak sayfa sayfa bir TStream'e yazar ve kaç sayfa işlediğini döndürür
Metin, sayfanın gösterdiğini tutar. Kutu merkezi görünür alanın (media box içindeki crop box) dışına düşen glifler dışarıda bırakılır; kırpılmış bir sayfadaki baskı işaretleri dizininize sızmaz. Sayfanın boyadığı Form XObject'lerin içindeki metin, her formun /BBox'ına kırpılarak dahil edilir. Aynı noktaya iki kez boyanan karakter — sahte kalın yüz püskürtmenin eski hilesi — bir kez okunur; metin çıkarmada sahte kalın ve yinelenen glifler o durumun nasıl saptandığını anlatır
Satır sonları basit bir geometrik kuralı izler. Glif başlangıcı yazma yönünde, metin yüksekliğinin yarısından fazlası kadar geçtiğinde yeni satır başlar; sayfa birimlerinde bu glif ile önceki glifin ascent-descent yüksekliğinin büyüğü alınır. Tf boyut operandı yerine glif kutusunu ölçmek işe yarayan kısımdır: birçok üretici metni metin matrisiyle boyutlandırıp Tf'e 1 geçirir ve o operanta kurulu bir eşik her yükseltilmiş üst simgede kırılır, döndürülmüş metnin her karakterini kendi satırına koyardı. Kelime boşlukları aynı şekilde işler. Üretici kelimeleri boşluk göstermek yerine bir TJ ayarıyla ya da Td ile metin konumunu oynatarak ayırıyorsa, önceki glifin kendi genişliğinden sonraki boşluk glif yüksekliğinin 0,15'ini aştığında bir boşluk eklenir ve iki Çin, Japon ya da Kore karakteri arasına asla konmaz. Çözücünün çözemediği kodlar boşluk olur; böylece tek tek glifler kaybolsa da kelime sınırları yaşar. Yatay metin içerik akışı sırasıyla çıkar; dikey CJK dizileri sağdan sola, yukarıdan aşağıya okunan sütunlara yeniden gruplanır. Sayfa metninde kelime boşlukları ve satır sonları o eşikleri işler
Kılavuz, sütun ya da yapı sırası
Konum anlam taşıdığında (tablolar, formlar, kod listeleri, sütuna göre karşılaştıracağınız, grep edeceğiniz ya da ayrışştıracağınız her şey) daha iyi çağrı ExtractLoadedPageTextLayout'tur. Glifleri taban çizgilerine kümeler, her taban çizgisini X'e göre sıralar ve yatay ile dikey boşluğu, sayfanın medyan glif ilerlemesinden ve font boyutundan boyutlanmış eş aralıklı bir karakter kılavuzunda yeniden üretir. Taban çizgisindeki geniş boşluklar boşluk dizilerine, taban çizgileri arasındaki büyük boşluklar boş satırlara dönüşür
uses System.IOUtils;
...
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // Sütunlar, girintiler ve tablo hizası karakter kılavuzunda
  // boşluklar ve boş satırlar olarak yaşar
end;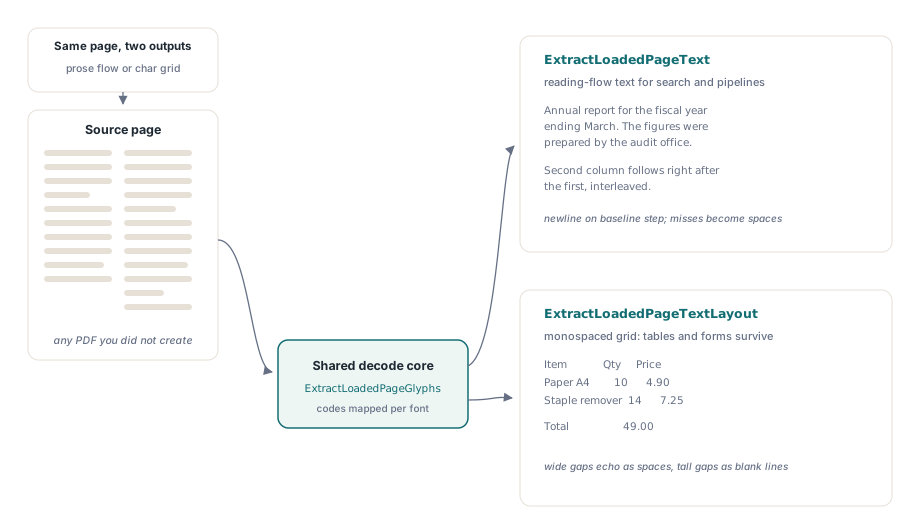
İki çağrı da aynı mekanizmadan çözer; birini seçmek sadakatte hiçbir şeye mal olmaz. Kılavuzun yapmayacağı şey düz yazıyı yeniden akıtmaktır: iki sütunlu bir makale, her iki sütun yan yana çıkar — karşılaştırma için doğru, özetleyici için yanlış. O boşluğu iki başka çağrı kapatır. ExtractLoadedPageTextColumns(PageIndex, AText, ColumnGapMultiplier), komşu glifler arasındaki boşluk çarpanın medyan ilerlemeye oranı aştığı her yerde satırı böler (varsayılan 3,0) ve parçaları sekme ile ayırır. ExtractLoadedPageStructureText(PageIndex, AText, UntaggedGlyphCount), etiketli bir PDF'in yapı ağacında (ISO 32000-1 §14.8.4) yürür ve işaretli içerik dizilerini yazarım sırasıyla döndürür; sayfanın kullanılabilir bir yapı ağacı yokken False döndürür ve UntaggedGlyphCount kaç glifi yerleştiremediğini söyler
Bir kişinin ya da bir dil modelinin okuyacağı metin için önce yapı sırasını deneyin, sonra ExtractLoadedPageText'e dönün. Yapı ağacı, yazarın bilinçli olarak bildirdiği tek sıralamadır; her geometrik yöntem kıyasla bir tahmindir. Kılavuzu, sütunların veri olduğu işler için saklayın. Yapı sıralı metin çıkarma, işaretli içeriğin ağaçla nasıl eşleştiğinin ayrıntısını taşır
HotPDF karakter kodlarını Unicode'a nasıl çözer
HotPDF Delphi Component her karakter kodunu öncelik sıralı bir yedek zinciriyle çözer ve yanıtlayamayan strateji kodu bir sonrakine devreder. Fontun /ToUnicode CMap'i (ISO 32000-1 §9.10.3) ilk sıradadır; çünkü üreticinin çıkarma için özel yazdığı tek eşlemedir. Peşinden bir /Encoding /Differences dizisinden, Adobe Glyph List üzerinden okunan glif adları gelir; sonra /Encoding CMap'inin kendisi — akış olarak gömülü ya da adıyla — gelir; Uni…-UTF16 adı, kodun hâlihazırda UTF-16 olduğunu anlatır. Bileşik fontlar Adobe karakter koleksiyonlarından (Adobe-GB1, Adobe-CNS1, Adobe-Japan1, Adobe-Korea1, Adobe-KR) CID'den Unicode'a devam eder, sonra /CIDToGIDMap üzerinden gömülü font programının cmap tablosuna girer; gliften Unicode'a ters okunur. Basit fontlar WinAnsi, MacRoman, Standard ve MacExpert tablolarına ve sonunda aynı gömülü cmap'e döner. Zinciri tüketen bir kod 0'a çözülür
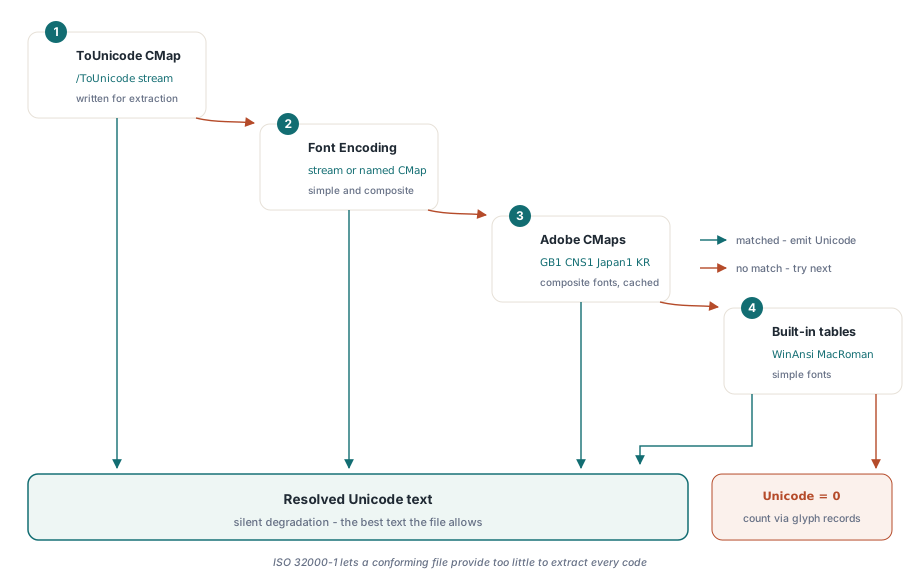
Gömülü-cmap adımı, /ToUnicode taşımadan gelen birçok subset fontu kurtaran adımdır: font programı çoğu zaman kendi Unicode cmap'ini hâlâ içerir ve onu ters çevirmek metnin çoğunu geri getirir. Ama bir yeniden kurulumdur. Tek glifi paylaşan iki Unicode karakteri, cmap'in listelediği hangisiyse o olarak döner; geri kazanılan metni arama ve dizinleme için iyi sayın ve yasal bir kayıt olarak kullanmadan önce kontrol edin
Adobe koleksiyonu verisi diskte yaşar. HotPDF, CMap ve cid2code.txt dosyalarını resources\CMap klasörü altında taşır, her dosyayı süreç başına en çok bir kez ayrıştırır ve sonucu önbellekler; yalnızca Adobe-GB1 haritası, sayfa başına ayrıştırmak istemeyeceğiniz kabaca 2 MB metindir. Önceden tanımlı CMap'ler gömülü tablolar olarak da vardır; UniGB-UTF16-H gibi adlandırılmış bir CMap ile kodlanmış font klasör olmasa da çözülür. Identity-H CJK fontlarının CID-Unicode tabloları klasörü ister. CMapResourcePath özelliği, koleksiyon alt klasörlerini tutan klasörü adlandırır; boş bırakılırsa HotPDF çalıştırılabilenin yanında ve bir-iki düzey üstünde resources\CMap arar
Pdf := THotPDF.Create(nil);
try
  // Adobe-GB1-6, Adobe-CNS1-7, Adobe-Japan1-7 ... içeren klasör
  Pdf.CMapResourcePath := 'C:\MyService\resources\CMap';
  Pdf.LoadFromFile(FileName);
  ...
finally
  Pdf.Free;
end;
Yolu her serviste, ISAPI modülünde ve eklenti DLL'inde açıkça ayarlayın. O barındıranlarda ParamStr(0) barındıran süreci adlandırır; dağıttığınız klasör nadiren odur ve eksik klasör fırlatmaz: CJK sayfaları, koleksiyon tablolarının dolduracağı yerlerde boşluklarla geri gelir. HotPDF ile karmaşık yazı sistemi metin şekillendirme, aynı kod-glift ayrışmasını yazma anında yaşar
İki CMap sözdizimi tuzağı
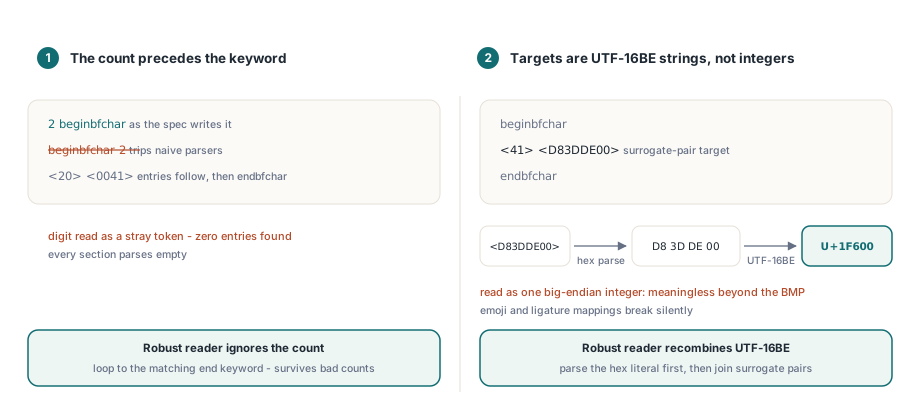
CMap dosyaları önemsizce ayrıştırılabilir görünür ve ilk denemelerin çoğunu iki ayrıntı devirir. Kayıt sayısı bölüm anahtar sözcüğünden önce gelir: bir bölüm 2 beginbfchar diye okunur, asla beginbfchar 2 değil. Sayıyı anahtar sözcükten sonra bekleyen bir ayrıştırıcı sayıyı başıboş bir simge diye yutar ve her bölümde sıfır girdi bulur. HotPDF'in okuyucusu sayıyı büsbütün yok sayar ve eşleşen endbfchar ya da endbfrange'e dek döngü kurar; bildirilen sayıları yanlış olan gerçek dünya dosyalarını da böylece karşılar
İkinci tuzak, bfchar ve bfrange hedeflerinin UTF-16BE dizeleri olduğudur. <D83DDE00> hedefi U+1F600 demektir — tek bir kod noktasına yeniden birleştirilmesi gereken bir vekil çift — ve o dört baytı big-endian bir tamsayı diye okumak, Basic Multilingual Plane dışındaki her karakter için anlamsız bir değer verir; emoji dahil. HotPDF onaltılık sabiti önce ham baytlara ayrıştırır, sonra UTF-16BE kod birimlerini yeniden birleştirir; ligatür eşlemelerinin ürettiği çok karakterli hedefleri de böylece karşılar, örneğin tek fi glifinin iki harfe eşlenmesi gibi
ExtractLoadedPageGlyphs ile çözülmemiş glifleri saymak
ExtractLoadedPageGlyphs(PageIndex, AGlyphs), metin çağrılarının altındaki glif kayıtlarını bir THPDFGlyphArray olarak açar. Her THPDFGlyphRecord ham Code'u, CodeByteWidth'ini (1, 2 ya da 4; CMap'in codespacerange'i karar verir), çözülmüş Unicode kod noktasını ve ligatürler için UnicodeSequence'i, etkin FontKey ile FontSize'u, kullanıcı uzayı X ve Y başlangıcını, Advance'i, dört köşeli glif dörtlüsünü ve kelime-boşluk kuralının ölçtüğü glifin kendi genişliğinin sonu olan GlyphEndX / GlyphEndY'yi taşır. Konumlu vurgulama ya da kendi düzen algoritmanız için yeterlidir
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
Unicode = 0 kayıtlarını saymak, metnine aşağı akışta güvenmeden önce bir belgeyi yargılamanın dürüst yoludur. Sayının metin çağrılarının gördüğünden biraz farklı çıkmasını bekleyin. Bu çağrı, sayfanın kendi içerik akışındaki her glifi döndürür — crop box dışındakiler ve sahte kalın için boyanmış kopyalar dahil — ve Form XObject'lere inmez. Her kayıt ayrıca karakteri kaynak operandına bağlayan TokenIndex, ItemIndex ve ByteOffset'i saklar; mevcut bir PDF'te arama ve değiştirme o üç alan üzerine kuruludur
Bazı dosyaların verecek metni yoktur. Taranmış bir sayfa, metin operatörü olmayan tek büyük bir resimdir; çıkarma doğru olarak boş dize döndürür ve ileri yol OCR'dir — yüklü PDF'ten sayfa resimlerini çıkarmayla başlayarak. Şifreli belgeler, LoadFromFile(FileName, Password) ile açıldıklarında normal çıkar; akışlar, yorumlayıcı onları okumadan önce çözülür. Font ve içerik akışları, yüklenen belgenin gerisiyle aynı filtre zincirinden çözülür ve çözülemeyen bir /ToUnicode akışı, sayfanın gerisi çıkmaya devam ederken sonraki stratejiye düşer. Aynı nesne okuyucu yüklü belgelerde meta veri düzenlemeyi de taşır; tek bir alım geçişi metni okur, meta veriyi düzeltir
Okuma akışı, kılavuz, sütun ve yapı sıralı çıkarma ve glif düzeyi erişimin tamamı, harici DLL'siz ve işletim sistemi metin hizmetleri olmayan düz Object Pascal olarak, Delphi ve C++Builder için HotPDF Delphi Component ile gelir; kuyruğunuza tuhaf bir dosya düştüğünde çözücünün içine adım atıp her kodu hangi stratejinin karşıladığını görebilirsiniz