Bir kullanıcı arama kutusuna Müller yazar, hiçbir şey bulamaz, aynı adı PDF'den kopyalayıp kutuya geri yapıştırır ve bir anda isabetler gelir. İki dizgiyi hata ayıklayıcıda açın: Length, yazılan için 6, yapıştırılan için 7 döndürür. Yazılan sözcük tek bir önceden birleştirilmiş ü olan U+00FC taşır; belge ise düz bir u ve ardından U+0308 COMBINING DIAERESIS saklar. İkisi de aynı glifler olarak işlenir ve bir kod birimi karşılaştırması onları asla eşit saymaz
Aynı görünen dizgiler neden eşit değil olarak karşılaştırılır?
Unicode, aynı soyut karakter için birden fazla kodlamaya bilinçli olarak izin verir ve o kodlamaları kurallı olarak eşdeğer adlandırır. Unicode Standard Annex #15, arama için önemli iki normal biçim tanımlar: önceden birleştirilmiş kod noktalarını yeğleyen NFC ve her birleştirilmiş karakteri, sabit bir sırada bir temel harf artı birleştirme işaretlerine bölen NFD. Diyakritikli Latin harfleri iki biçimde de vardır. Hangul heceleri de öyledir; tek bir birleştirilmiş hece ya da iki üç birleşen jamo dizisi olarak görünebilirler
Bir PDF'te hangi biçimin kaldığı, onu üreten yazılıma, üzerinde çalıştığı platforma ve kimi zaman bir fontun ToUnicode eşlemesinin nasıl kurulduğuna bağlıdır. Bir makinede yazılıp ötekinde düzenlenmiş bir belge, aynı sayfada iki biçimi de karıştırabilir. Arayan kişi için bunların hiçbiri görünmez. Onun klavyesi ve giriş yöntemi genellikle NFC üretir; dolayısıyla dosyadaki ayrıştırılmış her içerik, onun tarafından aranamaz olur
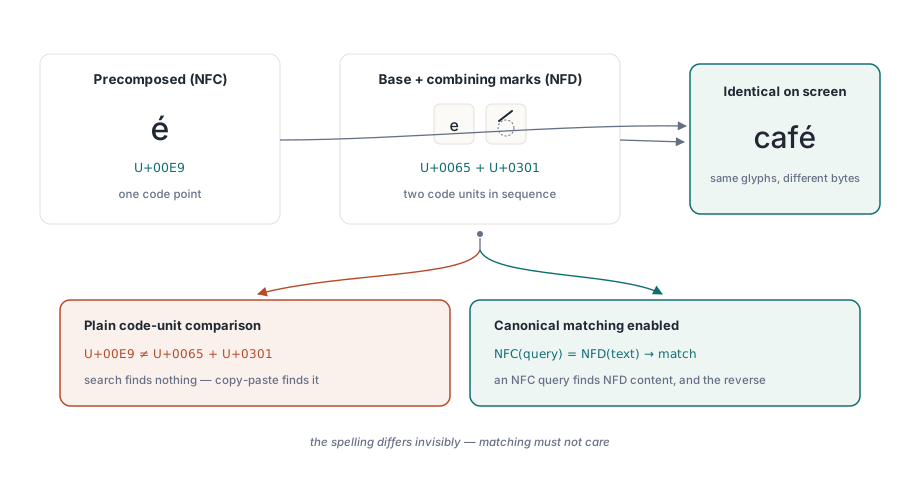
Bariz çözüm, sorunu harf katlamayla aynı kovaya atmaktır: iki tarafı küçük harfe çevir, aksanları sil, karşılaştır. Bu, yapısal bir nedenle bozulur. Harf katlama ve aksan silme, kod birimi düzeyinde bire birdir; katlanmış metin, özgünle tam olarak aynı uzunluktadır ve katlanmış kopyadaki 17. konumdaki bir isabet, çıkarılan metindeki 17. konumdaki bir isabettir. Normalleştirme uzunlukları değiştirir. Tek bir birleştirilmiş harf iki üç kod birimi olur, ayrıştırılmış bir dizi tek birime çöker, Hangul heceleri jamoya açılır ve o dönüşümden sonra geri aldığınız konumlar, çıkardığınız metne artık işaret etmez
PDF Library for Delphi'de soCanonicalEquivalent ile arama
PDF Library for Delphi'de TPDFlibSearchOptions'un soCanonicalEquivalent üyesi, SearchText'i sorgunun ve sayfa metninin kurallı ayrıştırmalarını karşılaştırır hâle getirir; böylece bir NFC sorgusu NFD içeriğini, bir NFD sorgusu NFC içeriğini bulur. Seçenek bir kümenin parçasıdır; yani ayrı hiçbir API olmadan soWholeWord, soCaseSensitive, soWildcards ve soDiacriticInsensitive ile kombine olur:
uses
  SysUtils, Math, PDFlibrary;

var
  Lib: TPDFlib;
  Hits: array of TPDFlibSearchHit;
  Found, Stored, I: Integer;
  Slice: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contracts.pdf', '');
    Lib.SearchContextChars := 24;      // ContextBefore / ContextAfter'ı doldurur
    SetLength(Hits, 500);

    Found := Lib.SearchText('Bäcker',
      [soCanonicalEquivalent, soWholeWord, soGraphemeClusters],
      '', Hits);                       // boş sayfa aralığı = her sayfa

    // Found her isabeti sayar; yalnızca ilk Length(Hits) kopyalandı
    Stored := Min(Found, Length(Hits));
    for I := 0 to Stored - 1 do
    begin
      Slice := Copy(Hits[I].MatchText, Hits[I].MatchStart,
        Hits[I].MatchLength);
      Writeln(Format('page %d: [%s] %d code units, ...%s|%s|%s...',
        [Hits[I].Page, Slice, Hits[I].MatchLength,
         Hits[I].ContextBefore, Slice, Hits[I].ContextAfter]));
    end;
  finally
    Lib.Free;
  end;
end;
O döngüde insanları takılan iki ayrıntı vardır. SearchText, tampon daha küçük olsa bile toplam isabet sayısını döndürür; büyük bir belgede Found - 1'e kadar yinelemek, 500 elemanlı bir dizinin sonunu aşar. Min ile kırpın ya da her isabeti bir geri çağırıma teslim eden ve hiç tampon istemeyen SearchTextEach'e geçin. MatchText ise eşleşmeyi içeren bütün metin bloğudur ve MatchStart onun 1 tabanlı indeksidir; dolayısıyla eşleşen sözcüğün kendisi yukarıda gösterilen Copy'dir
Bunu Bäcker'i ayrıştırılmış saklayan bir dosyaya karşı çalıştırın, basılan uzunluk 7'dir; bir NFC dosyasına karşı 6'dır. Aynı sorgu, aynı seçenek kümesi. Dilim, her zaman belgede durduğu hâliyle metindir
İsabet, özgün metinde nereye düşer
O son özellik, normalleştirilmiş aramayı bir evet/hayır yanıtı ötesinde kullanılır kılan şeydir. PDF Library for Delphi, normalleştiricinin ürettiği her kod birimi için, geldiği özgün UTF-16 aralığının başını ve sonunu kaydeder. Özyinelemeli bir ayrıştırma üstünün aralığını devralır, bir birleştirme girdilerinin aralıklarını kaynaştırır ve bir eşleşme bulunduğunda arama, eşlenen aralıkta en küçük başlangıcı ve en büyük sonu tarar
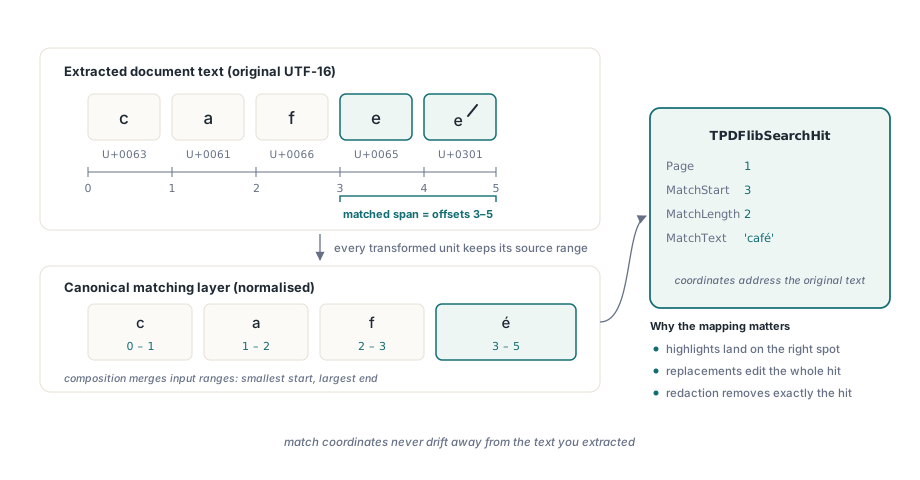
Sonuç olarak MatchStart, MatchLength, ContextBefore, ContextAfter ve iki değiştirme giriş noktası, çağıranın zaten elinde olan çıkarılmış metni adresler. "Bu blokta bir isabet var" diyebilen ama tam olarak nerede olduğunu diyemeyen bir arama, sonuç sayımı için yeterli olurdu ve geri kalan her şey için yanlış: vurgulamalar aksanlı harf başına bir iki karakter kayar, bir değiştirme ise yanlış metin parçasını yeniden yazardı
Normalleştirici kitaplığın içinde gelir. Unicode 15.1'den kurallı ayrıştırma, birleştirme ve kurallı birleştirme sınıfı için sıkıştırılmış tablolar taşır, Hangul için tablo girdileri yerine algoritmik kuralları uygular ve NFD sırasında birleştirme işaretlerini kararlı biçimde yeniden sıralar. Hiçbir harici veri dosyası yüklenmez ve hiçbir işletim sistemi normalleştirme çağrısı yapılmaz; böylece bir Windows servisi, bir Linux daemon'ı ve bir Free Pascal derlemesi aynı dosya için özdeş isabetler döndürür. İşletim sistemi Windows'ta işi yapabilirdi ama biz böyle yeğliyoruz: bir sunucuda kurulup ötekinde sorgulanan bir arama indeksi, iki makine farklı Unicode sürümleri çalıştırdığı için asla çelişmemelidir
Seçenek varsayılan olarak kapalıdır ve o varsayılan makuldür. NFD metnini ve konum eşlemesini kurmak zaman ister ve yalnızca ASCII içeren faturalar üzerindeki bir arama buna hiç ihtiyaç duymaz. soCanonicalEquivalent atandığında her metin bloğu iki dönüştürülmüş kopya tutar — biri birleştirme işaretli, öteki işaretsiz — böylece aynı blok üzerindeki bir sorgu yığını onu bir kez normalleştirir. Düz harf katlama, daha ucuz bire bir yolda ilerlemeye devam eder
Bir isabet bir karakterin içinde bittiğinde ne bozulur?
Kurallı eşdeğerlik "bu aynı metin mi" sorusunu yanıtlar ama bir isabetin nerede durmasına izin verildiği hakkında hiçbir şey söylemez. Ayrıştırılmış café'yi yalnızca soCanonicalEquivalent ile cafe için arayın; ilk dört kod birimi eşleşir ve ardından gelen birleştirme aksanı isabetin dışında kalır. soWholeWord bunu yakalamaz, çünkü sözcük karakterleri tanımlayıcı kurallarını izler (ASCII harfleri, rakamlar ve alt çizgi) ve bir birleştirme işareti sınır sayılır. Vurgulama cafe'i kapsar ve bir değiştirme, ardından gelen her neyse onun üzerinde başıboş bir aksan bırakır
Aynı şey Latin aksanlarının çok ötesinde olur. Bir bayrak emoji'si iki bölgesel gösterge kod noktasıdır. Bir aile emoji'si sıfır genişlikte birleştiricilerle birleştirilmiş birkaç kişidir. Bir Devanagari bağlaması bir ünsüz, bir virama ve bir ünsüz daha iken bir Vietnamca seslisi iki üst üste işaret taşıyabilir. Temel Çok Dilli Düzlem'in dışındaki her şey UTF-16'da bir vekil çiftidir ve birini ortadan ikiye bölmek, çok metin hattının U+FFFD ile değiştirdiği eşleşmemiş bir vekil üretir
soGraphemeClusters, her isabetin — sabit ya da joker — iki ucunun da Unicode Standard Annex #29'un tanımladığı genişletilmiş grafem küme sınırlarına düşmesini ister. Segmentasyon, CR/LF eşleşmesini, denetim karakterlerini, Hangul hece türlerini, Extend ve SpacingMark'ı, Prepend'i, emoji ZWJ dizilerini, bölgesel gösterge çiftlerini ve Hint bağlama kırılmalarını kapsar ve bir vekil çiftin içine asla sınır koymaz. Bayrak atandığında cafe, ayrıştırılmış bir café'yi artık hiç eşleşmez; gerçek istediğiniz aksana kör bir eşleştirmeyse soDiacriticInsensitive ekleyin
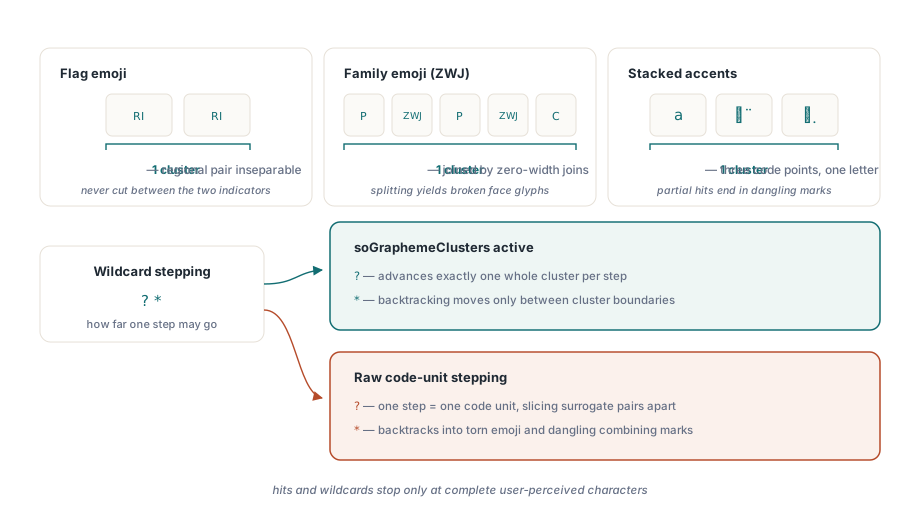
Jokerler, bayrağın sonuçları en görünür biçimde değiştirdiği yerdir. soCanonicalEquivalent altında sayfa metni NFD'de karşılaştırılır; böylece côté, dosyanın onu nasıl sakladığına bakılmaksızın c o U+0302 t e U+0301 olur. soGraphemeClusters olmadan c?té'deki ?, tam olarak bir kod birimi tüketir — o'yu — sonra bir t bekler ve U+0302 bulur. İsabet yok. Bayrakla ? bütün bir küme ilerler ve * için geri izleme de yalnızca küme sınırları arasında hareket eder:
// "?" bir kullanıcı algılanan karakter adımlar, dolayısıyla bu côté eşleşir
// PDF onu birleştirilmiş ya da ayrıştırılmış saklamış olsun
Found := Lib.SearchText('c?té',
  [soWildcards, soCanonicalEquivalent, soGraphemeClusters], '', Hits);

// Değiştirme aynı küme-güvenli aralıkları kullanır; bu yüzden asla
// bir emoji bölmez ya da sahipsiz bir aksan bırakmaz
Replaced := Lib.SearchAndReplaceTextInContent('naïve', 'plain',
  [soCanonicalEquivalent, soGraphemeClusters], '1-20');
if Replaced = 0 then
  Writeln(Lib.GetLastUnicodeReplacementDiagnostics)
else
Lib.SaveToFile('contracts-edited.pdf');SearchAndReplaceTextInContent, sayfa içeriğinin içindeki metni yeniden yazar ve değiştirdiği eşleşme sayısını döndürür. Sıfır döndürdüğünde GetLastUnicodeReplacementDiagnostics nedenini söyler; örneğin bir eşleşmenin, onu çizen içeriğe geri eşlenemediğini. Öteki giriş noktası olan SearchAndReplaceText aynı seçenek kümesini kabul eder ve değiştirmeyi eşleşen bloğun üzerine çizer
İş yükü başına seçenek kümesi seçmek
Üç kombinasyon çoğu uygulamayı kapsar. Belge görüntüleyici içindeki bir son kullanıcı arama kutusu için soCanonicalEquivalent artı soDiacriticInsensitive kullanın: iki kodlama biçimi de eşleşir, aksanlı ve aksansız yazımlar da; yıllardır web aramasından sonra insanların beklediği budur. Yanlış pozitifin birine bir öğleden sonrasına mal olduğu hukuki ya da uyumluluk incelemesi için soCanonicalEquivalent'i soCaseSensitive ve soWholeWord ile kullanın, aksan katlamayı kapalı bırakın; böylece eşdeğerlik, dosyanın onu nasıl kodladığını yok sayarken kesin kalır
Belgeyi değiştiren her şey için her seferinde soGraphemeClusters ekleyin. Zevke bırakmayacağımız tek yer burasıdır. Bir kod birimi eksik aralık döndüren bir arama yalnızca sonuçları okuyanı yanıltır; aynı aralığı kullanan bir değiştirme ya da silme hatayı dosyaya yazar ve kimse, sayfa basılana ya da yeniden çıkarılana dek fark etmez. İçeriği örtmek yerine yok etmek zorunda olan silme, kendi başına bir konudur; gerçek redaksiyon ve içerik silme yazısı bunu kapsar
Birçok terim aynı belgeye karşı çalışacaksa SearchTextBatch'i yeğleyin. Bir sayfanın metin blokları bellekte dururken boş olmayan her sorguyu değerlendirir; böylece her sayfa bir kez çıkarılır, her blok bir kez normalleştirilir ve her sorgu kendi seçenek kümesini taşır:
var
  Queries: array[0..2] of TPDFlibSearchQuery;
  BatchHits: array of TPDFlibSearchBatchHit;
  Count, I: Integer;
begin
  Queries[0].Query := 'Müller';
  Queries[0].Options := [soCanonicalEquivalent, soDiacriticInsensitive];
  Queries[1].Query := '서울';                // Hangul: dosyada NFC ya da jamo
  Queries[1].Options := [soCanonicalEquivalent, soGraphemeClusters];
  Queries[2].Query := 'Nguyễn';
  Queries[2].Options := [soCanonicalEquivalent, soCaseSensitive,
    soWholeWord, soGraphemeClusters];

  SetLength(BatchHits, 2000);
  Count := Min(Lib.SearchTextBatch(Queries, '', BatchHits),
    Length(BatchHits));
  for I := 0 to Count - 1 do
    Writeln(Format('query %d -> page %d',
      [BatchHits[I].QueryIndex, BatchHits[I].Hit.Page]));
end;
İsabetler sayfa, sonra blok, sonra sorgu sırasıyla döner ve QueryIndex, geçtiğiniz dizideki sıfır tabanlı konumdur. Önceden boyutlandıramayacağınız sonuç kümeleri için geri çağırımlı biçim SearchTextBatchEach'tir. Metin bloklarının başta nasıl çıkarıldığı metin araması ve sayfa öğesi numaralandırma yazısında anlatılır
Kurallı eşdeğerliğin isteğe bağlı olmadığı yazı sistemleri
Korece için kurallı eşdeğerlik, bir adın hiç bulunup bulunamayacağına karar verir; çünkü birleştirilmiş heceler de ayrıştırılmış jamo da gerçek belgelerde ortaya çıkar. Vietnamca, hâlihazırda bir kısa düz ya da şapkalı işaret taşıyabilen bir seslinin üstüne bir ton işareti koyar; dolayısıyla birleştirme biçimi tümüyle üreticiye bağlıdır. Devanagari, Bengalce ve öteki Hint yazı sistemleri için bağlama kuralları, bir isabet sınırının okurun tanıyabileceği bir yere düşüp düşmeyeceğine karar verir. Japonca ve Çince arama tarafında görece kolaydır — düzen tarafı öyle değildir; Japonca ve Çince için düşey yazım yazısı bunu kapsar
Tavsiyemiz dolaysızdır. Kaynağınız İngilizce dışında herhangi bir dil içeriyorsa önce soCanonicalEquivalent'i açın ve onu ancak kendi belgelerinizde sürelerini ölçüp maliyeti kabul edilemez bulduktan sonra kapatın. Önlediği başarısızlık, tam olarak kullanıcılarınızın en çok aradığı adlara düşer
Aynı Unicode farkında motor, aramayı, çıkarmayı, değiştirmeyi ve redaksiyonu Delphi, C++Builder ve Free Pascal'dan yürütür; seçenek kümeleri, toplu API ve metin araç takımının geri kalanı PDF Library for Delphi ürün sayfasında listelenir