Bir JBIG2 Tables segmentini (tip 53) bayt bayt dökerseniz ilk sürpriz, dışarıda bıraktığı şeydir: Huffman kodlarının kendisi. Elinize bir bayrak baytı, iki sınır ve küçük sayılarla dolu bir dizi geçer; o sayılar kod uzunluklarıdır. Encoder ile decoder, gerçek bit desenlerini o uzunluklardan ITU-T T.88 Ek B.3'teki prosedürle yeniden kurar. Biraz farklı bir sırada kurarsanız yine geçerli bir prefix code elde edersiniz, her desen yine çözülür ve her değer yanlış desene yapışmış olarak çıkar
Sembol kimlikleri Huffman ile kodlanmış ve tabloları encoder'in taşıdığı bir sayfada bu uyumsuzluk kötü bir tarama gibi görünür: glyph'lar birkaç piksel ötede, karakterler yanlış sembollerden kurulmuş ya da birkaç segment sonra bir genişlik menzil dışına çıkana dek inandırıcı sayılar. PDF dosyalarındaki JBIG2'nin çoğu aritmetik kodlamalıdır ve Huffman kodlamalı JBIG2'nin çoğu B.1'den B.15'e standart tablolara bağlı kalır. Kendi tablolarını taşıyan dosyalar nadirdir ve eğilimleri, tablo ayrıştırıcısını, Huffman kodlamalı iyileştirmeyi ve sıkıştırılmamış toplu bitmapleri bir seferde birden zorlamaktır
Tables segmenti aslında neyi taşır?
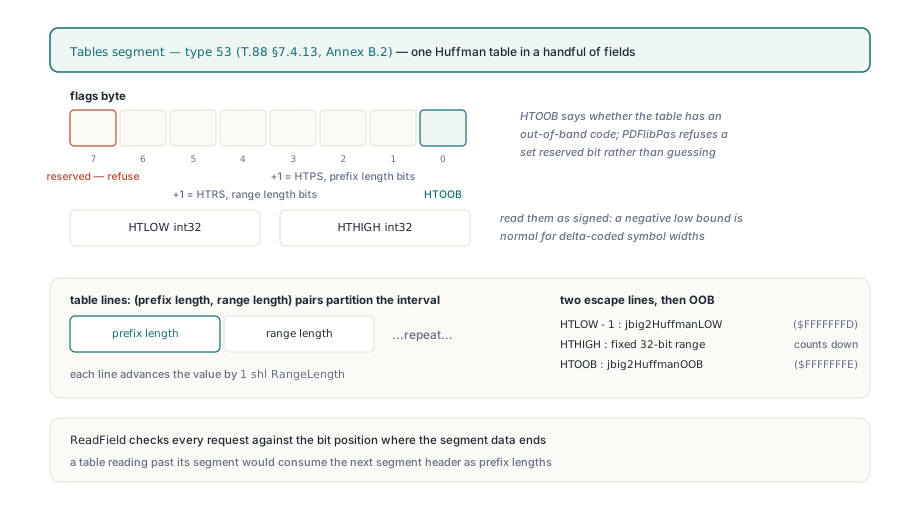
Bir Tables segmenti tam olarak bir Huffman tablosunu tanımlar. T.88 §7.4.13 ile Ek B.2 onu şöyle dizer: bir bayrak baytı, işaretli 32 bitlik HTLOW, işaretli 32 bitlik HTHIGH ve ardından HTLOW'dan HTHIGH'a uzanan aralığı döşeyen (prefix length, range length) ikilileri. Bayrakların 0. biti HTOOB'dır; tablonun bant dışı bir kodu olup olmadığını söyler. 1'den 3'e bitler artı bir, her prefix length alanının genişliği olan HTPS'i verir. 4'ten 6'ya bitler artı bir, her range length alanının genişliği olan HTRS'i verir. 7. bit ayrılmıştır
Sınırlar, elle yazılmış bir ayrıştırıcının ilk genelde takıldığı yerdir. HTLOW'u işaretsiz okuyun ve -2'den başlayan bir tablo — delta kodlanmış sembol genişlik ve yüksekliklerinde sıradandır — birden 4,3 milyarın hemen altında başladığını iddia eder. PDF Library for Delphi iki sınırı da işaretli okur, HTLOW'u HTHIGH'tan küçük olmayan ya da range length'i 32'yi aşan bir tabloyu reddeder ve okuduğu her alanı segmentin bildirdiği veri sonundaki bite karşı kontrol eder. Son kontrol, duyduğundan daha önemlidir: segmentinin ötesini okuyan bir tablo, sıradaki segment başlığını prefix length sanır ve tam bir saçmalığa ayrışır. Set edilmiş 7. bit reserved custom Huffman table flag ile başarısız olur. Tahmin yerine bu reddi tercih ediyoruz; çünkü tahmin edilmiş bir tablo, kimse nedenine bağlayamayacağı yanlış pikseller üretir
Düzenli satırlardan sonra Ek B.2'nin kaçış satırları gelir. Alt aralık satırı HTLOW eksi birden başlar ve 32 bitlik bir offset ile aşağı sayar; üst aralık satırı 32 bitlik bir aralıkla HTHIGH'ta başlar; bant dışı satır ise yalnızca HTOOB set edildiğinde vardır. Bu satırlar, yerleşik standart tabloların kullandığı işaretlerin aynısını taşır; böylece özel bir tablo ile Table B.6 tek bir çözme döngüsünden geçer. Özel bir tablo 65.536 satıra kadar tutabilir
Önek kodları neden tablo satırı sırasına göre atanmalıdır?
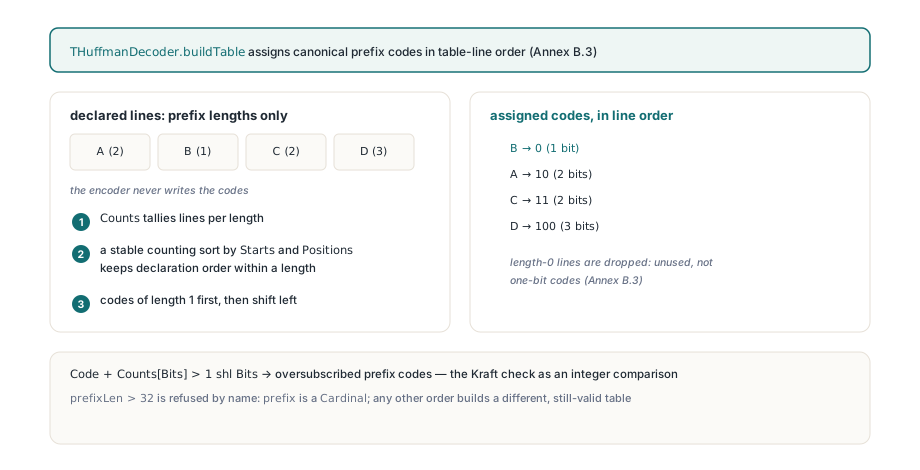
Çünkü bit desenini bir değer aralığına bağlayan tek şey bildirim sırasıdır. Ek B.3, her prefix length'i kaç satırın kullandığını sayar, 1 uzunluklu kodları önce dağıtır, 2 uzunluğa geçmek için sola kaydırır ve böyle gider; tek bir uzunluk içinde kodlar, satırların segmentte görünme sırasına gider. Küçük bir tablo bunu somutlaştırır. Dosya sırasında A'dan F'ye etiketlenmiş, şu prefix length'leri taşıyan altı satır:
| Satır | Önek uzunluğu | Kod (dosya sırası korunur) | B ile D yer değiştirirse kod |
|---|---|---|---|
| A | 2 | 00 | 00 |
| B | 3 | 100 | 101 |
| C | 2 | 01 | 01 |
| D | 3 | 101 | 100 |
| E | 3 | 110 | 110 |
| F | 0 | kullanılmıyor | kullanılmıyor |
İki sütun da geçerli prefix code'lardır. Ama yalnızca soldaki encoder'in kastettiğidir: B ile D yer değiştirdiğinde 100 deseni D'nin değer aralığını verir ve decoder yanlış aralıktan gelen bir sayıyla yola devam eder. F satırının uzunluğu 0'dır; B.3 bunu kullanılmıyor tanımlar. Ona tek bitlik bir kod verirseniz sonraki her atama kayar
Sağdaki sütunu elde etmenin kolay yolu, prefix length'e göre genel amaçlı bir sıralamadır. Delphi'nin TArray.Sort'u ile TList<T>.Sort'u stabil değildir; eşit uzunluklar herhangi bir sırada gelebilir. Kendi araçlarınızda kanonik kodlar için satırları, her uzunluk için bir kez dosya sırasında gezin:
uses
  System.SysUtils;

type
  TCodeLine = record
    PrefixLen: Integer;   // Tables segmentinden okunduğu gibi
    Code: Cardinal;       // aşağıda atanır
  end;

// Ek B.3 kanonik ataması, kendi araçlarınız için yazıldı.
// Eşit uzunluklar dosya sırasını korur; 0 uzunluk kod almaz.
procedure AssignCanonicalCodes(var Lines: array of TCodeLine);
var
  LenCount: array[0..32] of UInt64;
  FirstCode: array[0..32] of UInt64;
  NextCode: UInt64;
  CurLen, I: Integer;
begin
  FillChar(LenCount, SizeOf(LenCount), 0);
  for I := 0 to High(Lines) do
  begin
    if (Lines[I].PrefixLen < 0) or (Lines[I].PrefixLen > 32) then
      raise Exception.Create('prefix length out of range');
    Inc(LenCount[Lines[I].PrefixLen]);
  end;
  LenCount[0] := 0;
  FirstCode[0] := 0;
  for CurLen := 1 to 32 do
  begin
    FirstCode[CurLen] := (FirstCode[CurLen - 1] + LenCount[CurLen - 1]) shl 1;
    // Kraft kontrolü: bu uzunluğun taşıyabileceğinden fazla kod
    if FirstCode[CurLen] + LenCount[CurLen] > (UInt64(1) shl CurLen) then
      raise Exception.Create('oversubscribed prefix lengths');
    NextCode := FirstCode[CurLen];
    for I := 0 to High(Lines) do       // dosya sırası eşitlik bozucudur
      if Lines[I].PrefixLen = CurLen then
      begin
        Lines[I].Code := Cardinal(NextCode);
        Inc(NextCode);
      end;
  end;
end;
Yukarıdaki altı satırı verin; A 00'ı, C 01'i, B 100'ü, D 101'i, E 110'ı alır; F kod almaz. PDF Library for Delphi aynı işi bir sayma geçişinden yaptırır; bu, kurgusal olarak stabildir, tabloyu 32 kez yeniden taramayı gerektirmez ve aynı iki korumayı uygular. Aşırı abone uzunluklar oversubscribed Huffman prefix codes ile başarısız olur; bırakırsanız bir desen iki satırla eşleşebilir. 32 bitten uzun prefix'ler de adıyla reddedilir, gerçi T.88 kâğıt üstünde izin verir. O tavanın doğru takas olduğunu düşünüyoruz: her kod tek makine kelimesine sığar ve fazlasını gerektiren dosya, zekice olmaktan çok hasarlı olma ihtimali taşıyan dosyadır
Değerler de aynı özeni ister. Alt aralık satırı, HTLOW eksi bir eksi 32 bitlik işaretsiz bir offset olarak çözülür ve 32 bitlik bir Integer ara değerle o çıkarma, sıradan görünümlü pozitif bir genişliğe sarabilir. Decoder bunu 64 bitte yapar ve gerçek sonuç sığmadığında Huffman value exceeds signed integer range fırlatır
Selector sırası ve birbirini örten iki tuzak
Bir metin bölgesi ya da sembol sözlüğü tablolarını adıyla anmaz. İki bitlik selector'lar taşır ve custom olarak set edilmiş her selector, yönlendirilen listesinden sıradaki Tables segmentini yönlenme sırasına göre alır. T.88 §7.4.3.1.2 metin bölgesi selector'larını FS, DS, DT, RDW, RDH, RDX, RDY ve RSIZE olarak sıralar; §7.4.2.1.1 sembol sözlüğü selector'larını DH, DW, BMSIZE ve AGGINST olarak. 0 ile 1 değerleri standart tabloları seçer, 3 özel olanı seçer ve 2, yalnızca iki standart tablosu olan alanlarda ayrılmıştır. PDF Library for Delphi ayrılmış selector değerlerini reddeder ve selector'lar, bölgenin yönlendirdiğinden fazla özel tablo istediğinde missing custom Huffman table reference ile başarısız olur
Kendi decoder'ınızı yazıyorsanız burada iki hata kolaydır ve her biri ötekini örter. İlki Delphi'de, ya da Delphi modundaki FPC'de ısırır (objfpc modu kodu yinelenen tanımlayıcı olarak reddeder): parametresi alanla aynı adı taşıyan bir flags setter'ı. Parametre alanı gölgeler, Flags := Flags kendine atar ve alan sıfırda kalır. Her selector sonra sıfır okur; bir metin bölgesi, dosyanın ne istediğine bakmadan FS, DS ve DT için standart B.6, B.8 ve B.11 tablolarını kullanır ve özel yol hiç koşmaz
İkincisi sembol sözlüğünde oturur. Bir Huffman sözlüğü sembollerini sıkıştırılmamış toplu bitmap olarak da saklayabilir (BMSIZE sıfır); her satır kısmi bir baytla biter. Dolgu değeri, o bayttaki geçerli bit sayısıdır ve en düşük geçerli bit konumu sanıp okumak cazip gelir:
// Bir collective-bitmap satırının son baytı, bitler MSB önce okunur.
// Padding := TotalWidth mod 8  -> bu bayttaki GEÇERLİ bit sayısı

// Yanlış: Padding'i kopyalanacak en düşük bit indeksi sayar
for BitPos := 7 downto Padding do
  CopyPixel((LastByte shr BitPos) and 1);

// Doğru: en düşük geçerli bit indeksi 8 - Padding'tir (Padding = 0 iken 0)
for BitPos := 7 downto ((8 - Padding) and 7) do
  CopyPixel((LastByte shr BitPos) and 1);

// CopyPixel, kendi decoder'ınızda pikseli yazan her neyse onun yerine geçer
Sınır genişliklerini kontrol edin. 63 piksellik bir satırın dolgusu 7'dir: yanlış döngü son baytın bir bitini kopyalar, doğrusu yedisini. 9 piksellik satırın dolgusu 1'dir: yanlış döngü yedisini kopyalar, doğrusu birini. 64 pikselde ikisi de sekizin tamamını kopyalar; 8'in katları bunu hiç açığa çıkarmaz. 7 ve 9 piksel genişliğinde sentetik toplu bitmap'ler, bayt sınırının iki yanını da çiviler. Ve hasar yayılır, çünkü iyileştirme bu sembolleri referans olarak kullanır
Kendi decoder'ınızda iki tuzak da varsa debugging çekilmez hâle gelir. Yalnızca setter'ı düzeltin: özel yol sonunda koşar ve doğrudan bozuk toplu bitmap'lere dalar, sayfa hâlâ yanlış görünür. Yalnızca dolguyu düzeltin: görünürde hiçbir şey değişmez, çünkü özel yol hâlâ ulaşılamazdır. İkisini de sentetik girdilerle test edin, sonra hiçbir değişikliğe güvenin. İlgili bir ayrıntı: girdisi ile yeni sembollerinin toplamı bire inen bir Huffman sembol sözlüğü, log2 formülünden 0 sembol kod uzunluğu alır; oysa Huffman varyantı her sembol kimliğini en az bir bit ile yazar. PDF Library for Delphi bu uzunluğu Huffman modunda 1'e çeker
Huffman iyileştirmesi bitmap boyutunu nereden okur?
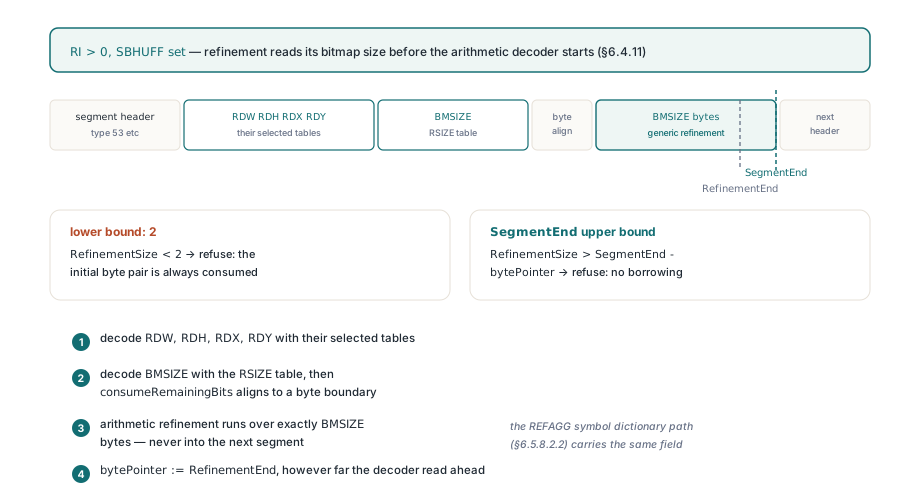
Yalnızca Huffman modunda var olan, aritmetik iyileştirme verisinden önce çözülen bir BMSIZE alanından. Bir metin bölgesi örneğinin iyileştirmesi varsa (RI sıfırdan farklı) ve SBHUFF set edilmişse T.88 §6.4.11, decoder'ın önce RDW, RDH, RDX ve RDY'yi seçtikleri tablolarla okumasını, sonra BMSIZE'ı RSIZE tablosuyla okumasını, sonra bayt sınırına atlamasını ve en son tam olarak BMSIZE bayt üzerinden genel iyileştirme çözmeyi koşturmasını söyler. Aritmetik modlu metin bölgelerinde böyle bir alan yoktur; modlar arasında tek kod yolunu paylaşan bir decoder onu atlar, aritmetik decoder'ı erken başlatır ve her sembolü gürültüye karşı iyileştirir. REFAGG ve tek iyileştirme örneği taşıyan sembol sözlüğü yolu (§6.5.8.2.2) aynı alana sahiptir
PDF Library for Delphi, BMSIZE'ı iki yönde de sınırlar. Alt sınır 2'dir; aritmetik decoder'ın daima tükettiği başlangıç bayt çifti. Üst sınır, geçerli segmentten artandır — bilerek tüm akıştan değil: yalnızca sıradaki segmentten bayt ödünç alarak sığan bir BMSIZE bozuktur ve akış uzunluğu kontrolü, aritmetik decoder'ın sıradaki başlığa taşmasına izin verirdi. Menzil dışı boyutlar invalid refinement bitmap size ile başarısız olur. Sonrasında Huffman okuyucusu, aritmetik decoder ne kadar ileri okumuş olursa olsun alanın tam olarak BMSIZE bayt ötesinden sürer
Bildirilen segment uzunluğu sınırdır
Her segment başlığı kaç veri baytının izlediğini belirtir ve decoder segmenti iki yönde de o sayıya bağlar: sonun ötesini okumak hatadır, erken bitirmek normaldir ve sıradaki başlık daima dosyanın başladığını söylediği yerden okunur. Daha küçük kurallar onu izler. T.88 §7.2.7'nin bilinmeyen veri uzunluğu, bir sonlandırıcı aranmak yerine baştan reddedilir. Yönlendirilen segmentler, geçerliden daha küçük numaralar taşımalı ve çoktan var olmalı. END_OF_PAGE ile END_OF_FILE sıfır veri baytı bildirmeli. Bir Profiles segmenti (tip 52) tam olarak 4 artı tanımlayıcı sayısının 4 katı olmalı; sonra atlanır ama saklanır, böylece sonraki segmentler yine ona yönlenebilir ve bilinmeyen bir profil tanımlayıcısı çözmeyi durdurmaz
Erken bitirmenin klasik hâli MMR'dir. Bir MMR decoder'ı, son satırın son pikselini ürettiği an biter; bu, T.88 §6.2.5.7'nin veri sonuna koyduğu EOFB sonlandırıcısından önce olabilir. Artık sıradaki başlıkta olduğunu varsayan bir okuyucu, artan EOFB baytlarını segment numarası olarak ayrıştırır ve birkaç bayt sonra, gerçek nedenin hayli uzağında başarısız olur. Bildirilen sona atlamak soruyu ortadan kaldırır. Aynı alışkanlık, PDF Library for Delphi'nin güvenilmeyen PDF yapılarını ayrıştırma biçiminin tamamına sinmiştir
Delphi'den bir JBIG2 görüntü akışını çözmek
Decoder, PDFlibJBIG2 unit'inde TPLJBIG2Decoder olarak yaşar. LoadFromByteArray, bir /JBIG2Decode görüntüsünün gömülü JBIG2 verisini ve isteğe bağlı olarak /JBIG2Globals akışının verisini alır; özel tablolar ile paylaşılan sembol sözlükleri genelde orada oturur. Herhangi bir ret durumunda False döndürür ve nedeni LastError'da bırakır; önceki bir çağrının çıktısı her çağrının başında temizlenir, böylece başarısız bir çözüm, çağıranın sonuç sanabileceği eski pikselleri geride bırakmaz
uses
  System.SysUtils, PDFlibJBIG2;

// ImageBytes: JBIG2Decode'den önceki filtreleri tamamen arındırılmış
//   görüntü akışı verisi
// GlobalBytes: /JBIG2Globals akış verisi ya da boş dizi
function DecodeAndCountBlack(const ImageBytes, GlobalBytes: TJBIG2ByteArray;
  out BlackPixels: Int64): Boolean;
var
  Decoder: TPLJBIG2Decoder;
  Line: TJBIG2ByteArray;
  Row, Col: Integer;
begin
  BlackPixels := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    Result := Decoder.LoadFromByteArray(ImageBytes, GlobalBytes);
    if not Result then
    begin
      // Biçim: 'JBIG2 segment <n> (type <t>) at byte <offset>: <reason>'
      Writeln('JBIG2 refused: ', Decoder.LastError);
      Exit;
    end;
    for Row := 0 to Decoder.Height - 1 do
    begin
      Decoder.GetScanline(Row, Line);   // piksel başına bir bayt, 0 ya da 1
      for Col := 0 to Decoder.Width - 1 do
        Inc(BlackPixels, Line[Col]);    // JBIG2'de 1 = siyah
    end;
  finally
    Decoder.Free;
  end;
end;
Siyah piksel sayacı sizin kendi kontrolünüzdür; ikinci bir renderer ile kıyaslamaya yarayan ucuz bir parmak izi. Segment düzeyi başarısızlıklar, segment numarası, tipi ve bayt ofseti önde olarak gelir; oversubscribed Huffman prefix codes önündeki (type 53) doğrudan bir Tables segmentini işaret eder. İki hata kanalını ayrı tutun: TPLJBIG2Decoder.LastError bu decoder'ın teşhis metnidir, TPDFlib.LastErrorCode ise kütüphane düzeyi API'nin sayısal kodudur. Sayfa seçimi akışı izler: decoder karşılaştığı ilk page-information segmentinin bitmap'ini döndürür ve 0 sayfa ilişkisine bakmaz; çünkü PDF gömülü JBIG2 tek sayfa taşır ve encoder'lar ona her zamanki gibi 1 numarası verir
Bu dosyalarda renderer'ları kıyaslamak biraz alçakgönüllülük ister, çünkü bağımsız JBIG2 decoder'ları, özel tablolu ve Huffman iyileştirmeli dosyalarda her zaman aynı sonuca varmaz. İki decoder'ın anlaşamadığı hiçbir şeyi kesinleştirmez. Kesinleştiren format alanlarıdır: selector'ların hangi tabloları seçtiği, BMSIZE'ın ne bildirdiği, her segmentin nerede bittiği
Kodlama tarafı JBIG2 encoder backend'leri ve nasıl bağlandıkları yazısında kapsanır. Okuma yolu, başkasının encoder'inin çıkardığı her şeyi almak zorundadır ve kurallarını yerleşik TIFF decoder'ı ile onun BigTIFF ve döşemeli düzen kontrolleriyle paylaşır: adıyla reddet, bildirilen bir sınırın ötesinden asla bayt ödünç alma, ara aritmetiği geniş tut. Taranmış PDF klasörü başka toolkit'leri şikayet ettiriyorsa görüntülerin özel tablolu, Huffman kodlamalı JBIG2 olup olmadığına bakın, sonra PDF Library for Delphi ürün sayfasında anlatılan native Delphi ve C++Builder okuma yoluna karşı deneyin