Müşteri yorumunu düzgün escape edin; <b>urgent</b> HTML şablonunuza <b>urgent</b> olarak girsin; işaretleme işaretlemeyi iki kez ayrıştıran bir renderer'a verin; PDF, urgent kelimesiyle kalın yazılmış olarak dönebilir. Kaçış doğruydu. Renderer, her geçişte bir kez decode etti. Ayrıştıran, sonucu HTML olarak geriye yazan ve yeniden ayrıştıran her HTML-to-PDF yolu, entityleri bütün yolculukta tam olarak bir kez çözmek zorundadır
Bu hikâyenin help desk versiyonu sıradandır. Talepler PDF'e export edilir, müşteri yorumu bir <p> içinde oturur ve birileri yorum kutusuna açı parantezleri yazar. Bilinmeyen bir tag adı sayfadan sessizce kaybolur. Kaçılmış bir anchor, personelinizin güvendiği bir belgede tıklanabilir bir link annotation olur. Dosya geçerlidir ve her yerde açılır; yalnızca veriden başka bir şey söyler
Kaçılmış metin nerede yeniden işaretlemeye döner?
Kaçılmış metin, iki geçişli bir renderer'ın çoktan çözülmüş metni yeniden escape etmeden HTML olarak geriye yazdığı noktada işaretlemeye döner. İlk ayrıştırmanın çözümlediği her şey, ikinci ayrıştırma için canlı sözdizimi olur
PDF Library for Delphi (PDFlibPas)'in DrawHTMLText ile DrawHTMLTextBox'ındaki iki geçiş iyi bir nedenle vardır. İlk ayrıştırma girdiyi tag'lere ve kelimelere böler. Renderer sonra stylesheet kaskadını çözer: <style> bloklarındaki kurallar her tag ile eşleştirilir, inline style öznitelikleriyle birleştirilir ve tüm element listesi, her tag son stilini taşıyan tek bir normalize edilmiş HTML string'i olarak geriye yazılır. Düzen geçişi o string'i ayrıştırır. Seçici eşleme, flexbox, grid ve PDFlibPas HTML render'ında flexbox, CSS grid ve dipnot düzeni yazısındaki diğer CSS desteğinin tamamı o ara adıma bel bağlar
Tehlike kelimelerin nasıl geriye çıktığında oturur. Tag'ler kaynak biçimlerinden geriye yazılabilir ama kelimeler çözülmüş metin olarak tutulur; çünkü satır kırıcı onu ölçer. <unsafe>'ten gelen kelimeyi olduğu gibi normalize string'e eklerseniz <unsafe>, ikinci ayrıştırmaya bir element olarak ulaşır. Bir kez çözen bir tasarım, üç küçük sızıntıyı da kapatmak zorundadır:
&çözülen kümede yoksaR&Dbirebir yazılır ve<yazımını sayfaya metin olarak koymanın hiçbir yolu kalmaz- Çizim aşaması, ayrıştırma bittikten sonra
'i yeniden değiştiriyorsa birebir bir entity yazımı son anda kaybolur - Markdown converter ya da dataset exporter gibi yukarı akıştaki bir HTML üreticisi yalnızca açı parantezlerini kaçırıyorsa, kod örneği ya da hücre değeri içindeki bir entity yazımı işaretlemeye çözülür
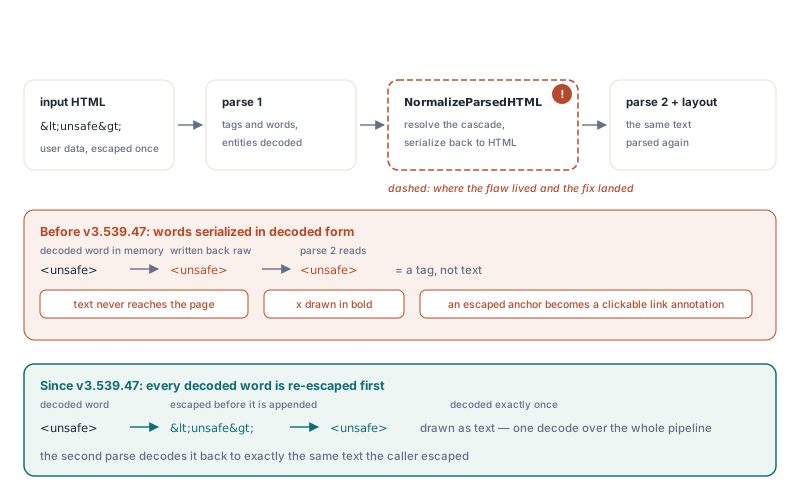
Aşağıdaki tablo, bir avuç girdi için sayfaya ne ulaştığını listeler; saf iki geçişli bir renderer ile PDFlibPas pipeline'ını kıyaslar
| Renderer'a ulaşan girdi | Saf iki geçişli renderer | PDFlibPas |
|---|---|---|
<unsafe> | Tag olarak ayrıştırılır, metin sayfaya ulaşmaz | <unsafe> metin olarak çizilir |
<b>x</b> | x kalın çizilir | <b>x</b> metin olarak çizilir |
R&D | R&D birebir yazılır | R&D |
&lt; | &lt; birebir yazılır | < |
içeren Markdown code span'i | Bölünemez bir boşluk | metin olarak çizilir |
Dataset hücre değeri < | < | < |
PDF Library for Delphi her entityyi tam olarak bir kez nasıl çözer?
PDF Library for Delphi her entityyi tam olarak bir kez, üç kuralı birlikte izleyerek çözer: parser &'i en son çözer, çizim aşaması hiçbir şey çözmez ve çözülmüş kelimeleri yeniden HTML'e çeviren her yer önce onları kaçırır. Üçünden birini düşürün; yukarıdaki tablo satırlarından biri saf sütuna döner
Neyin çözüldüğünden başlayın. Metin içeriğinde parser <, >, & ile 'i tanır. A gibi sayısal referanslar ile " gibi adlandırılmış entityler birebir metin kalır. Kısa o liste, kendi girdinizi nasıl kaçırmanız gerektiğine karar verir; aşağıda yeniden gelecek bir konu
Decoder'ın içindeki sıra, tek geçişin içinde bile önemlidir. &'i önce çözün; &lt; girdisi < olur ve ta ilk sonraki değiştirme onu <'e çevirir: ikinci bir ayrıştırma olmadan çift çözüm. Bu yüzden 8 bitlik kelime yolu önce <, > ile 'i çözer ve &'i en son; ürettiği ampersand bir daha hiç bakılmaz. UTF-16 kelime yolu aynı sonuca başka bir yoldan gider — her eşleşmeyi yerinde yeniden yazan ve onu geçen, iki baytlık adımlarla tek bir soldan sağa tarama
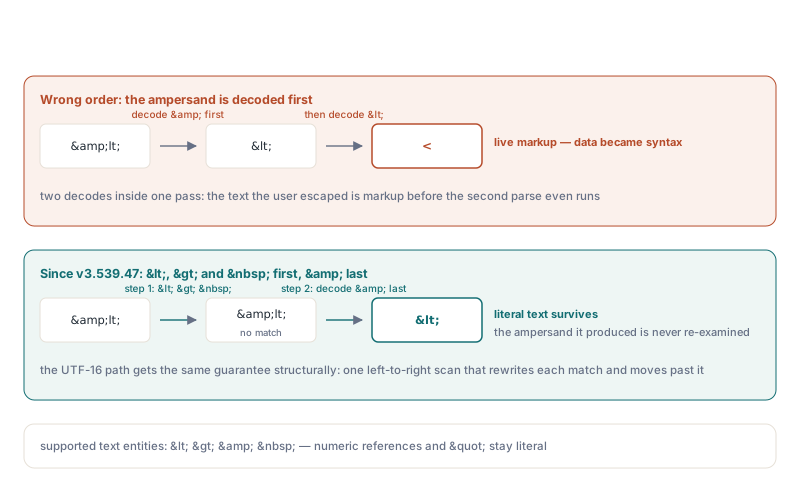
Çizim aşaması geç değişimi almaz. Satır kırıcıya ulaşan bir kelime kesin metindir ve çözüm parser'da yaşar, başka hiçbir yerde
Sınır kuralı en ağırı taşır. Renderer normalize HTML'i yazarken, eklediği her çözülmüş kelimede &, < ile >'yi kaçırır ve ikinci ayrıştırma aynı karakterlere geri çözer. İki geçişin üzerinden net etki: tek çözüm. DrawHTMLTextBox'un döndürdüğü devam string'i aynı kuralı izler. Sığmayan kelimeler kalana girmeden önce kaçırılır ve kalanın geri kalanı, çoktan kaçırılmış olan normalize HTML'den kopyalanır. Her şeyi alan kutu boş string döndürür
UTF-16BE kaçışı neden bayt düzeyinde bir replace kullanamaz?
UTF-16BE kaçışı bayt düzeyinde bir replace kullanamaz; çünkü bir ampersand'ın iki baytı, birbirinden bağımsız iki karakterin üstüne oturabilir. Güvenli tek iş birimi, bütün 16 bitlik code unit'tir
Renderer Unicode kelimeleri, yüksek bayt önde olacak biçimde byte string'lere paketlenmiş big-endian UTF-16 olarak tutar; yani bir ampersand 00 26'dır. U+0100'u (makronlu Latin büyük A, baytları 01 00) U+2603'ün (kardan adam, baytları 26 03) izlediği yeri düşünün. Tampon 01 00 26 03 okur ve iki ile üçüncü baytlar 00 26 yazar. #0'&' için bir bayt araması, hiçbir karakterin taşımadığı bir ampersand bulur, &'i iki code point'in ortasına diker ve sonraki her karakteri bir bayt öteler
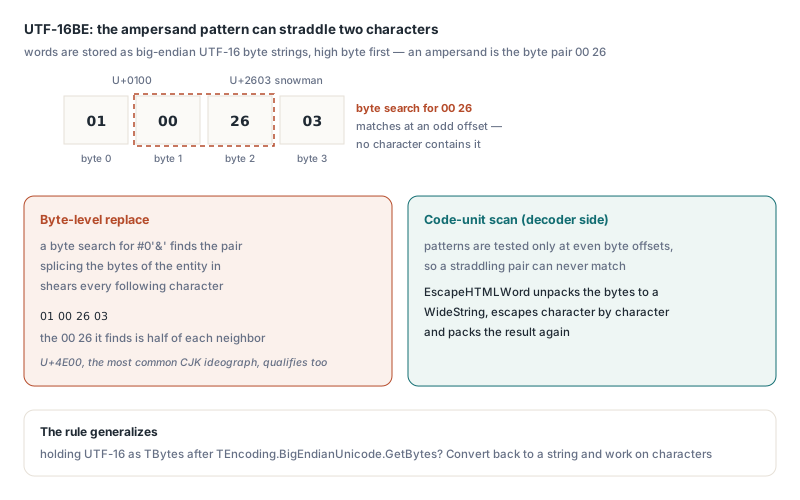
Bu egzotik bir köşe değil. Düşük baytı sıfır olan her karakter ilk yarısını sağlayabilir ve U+4E00 — en sık görülen CJK ideografından biri — tam da öyle bir karakterdir. Açı parantezleri aynı biçimde açığa çıkar: böyle bir karakterin CJK Extension A'dan U+3C00 ile U+3EFF arasından biriyle izlediği her yerde 00 3C ile 00 3E görünür. Bu yüzden PDFlibPas Unicode kelimelerini, bir WideString'e açarak, karakter karakter kaçırarak ve sonucu yeniden paketleyerek kaçırır. Decoder uyumlu nedenle güvenlidir: desenleri yalnızca çift ofsetlerde sınar
Kendi kodunuz da aynı duvara çarpabilir. UTF-16 metni bir TBytes'te yaşadığında — örneğin TEncoding.BigEndianUnicode.GetBytes sonrasında — onu bayt desenleri için aramak, doğru karakter çiftini bekleyen bir hatadır. String'e geri çevirin ve karakterler üzerinde çalışın
Markdown kodu ve dataset hücreleri: ampersand önce gelir
PDFlibPas'in içindeki iki HTML üreticisi — Markdown converter ile dataset exporter — ampersandı açı parantezlerinden önce kaçırır; renderer'daki tek çözüm, orijinal metni bayt bayt geri getirir
MarkdownToHTML'de inline code span'leri ile fenced ya da girintili kod blokları &'i &'e, <'i <'e ve >'yi >'e eşler. Boşluklar olur ve bir tab dört taneye dönüşür; girinti bozulmadan kalır. Sıradan düzyazı yalnızca açı parantezlerini kaçırır: düzyazıya yazılan ham HTML tag enjekte edemez; & yazmayı bilerek seçen bir yazar yine de ampersand alır, Markdown yazarlarının beklediği gibi. DrawMarkdownText ile DrawMarkdownTextBox aynı dönüşümü koşturur; kod bloğu yazıldığı gibi görünür:
uses
System.SysUtils, PDFlibrary;
procedure RenderCodeSample;
var
Lib: TPDFlib;
Md, Html: WideString;
begin
Md := 'Comparison helper:' + sLineBreak + sLineBreak +
'```' + sLineBreak +
'if (A < B) and (Flags <> 0) then' + sLineBreak +
' WriteLn(''<tag> & R&D'');' + sLineBreak +
'```';
Lib := TPDFlib.Create;
try
// HTML'i incele: kod içinde '&', '&' olur ve '<', '<' olur
Html := Lib.MarkdownToHTML(Md);
Lib.SetOrigin(1); // sol üst köşe orijin, Y aşağıya büyür
Lib.SetMeasurementUnits(0); // punto
// Sayfa kodu, entity yazımları dahil, yazıldığı gibi gösterir
Lib.DrawMarkdownText(50, 50, 495, Md);
Lib.SaveToFile('code-sample.pdf');
finally
Lib.Free;
end;
end;Cazip kısayol dataset exporter'da oturur. Renderer &'i çözmeseydi ampersandı kaçırın, ampersand taşıyan her hücrede & yazdırırdı; yalnızca açı parantezlerini kaçırın, daha samimi seçim gibi görünür. Değeri tesadüfen < içeren ilk hücrede çöker; o hücre sayfaya < olarak ulaşır. Renderer &'i çözdüğü için PDFlibExportDataSet'in arkasındaki exporter &'i önce kaçırır ve R&D < & gibi bir değer PDF'e birebir düşer. O exporter'ın gerisi Bir TDataSet'i Delphi'de PDF raporuna export etmede kapsanır
Neden önce, zincirde bir yerde değil? <'i önce kaçırın; < alırsınız. &'i ikinci kaçırın; &lt;'e döner ve doğru tek çözüm onu < yerine < gösterir. Sıralı bir replace zinciri yalnızca kaçış karakterinin kendisi, onu üreten her adımdan önce ele alındığında çalışır
DrawHTMLTextBox için güvenilmeyen metni nasıl escape etmelisiniz?
PDFlibPas için güvenilmeyen metin içeriğini kaçırın: &'i, sonra <'i, sonra >'yi tam olarak bir kez değiştirin ve güvenilmeyen veriyi attribute değerlerinin dışında tutun. Aşağıdaki yardımcı sizin ekleyeceğiniz; düz RTL kodudur:
uses
System.SysUtils, PDFlibrary;
// Kendi yardımcınız (kütüphanenin parçası değil): güvenilmeyen metni
// PDFlibPas HTML metin içeriği için kaçırır. '&' önce değiştirilmeli;
// yoksa yeni üretilmiş bir '<'in içindeki ampersand
// ikinci kez kaçırılır
function EscapeHTMLText(const S: string): string;
begin
Result := StringReplace(S, '&', '&', [rfReplaceAll]);
Result := StringReplace(Result, '<', '<', [rfReplaceAll]);
Result := StringReplace(Result, '>', '>', [rfReplaceAll]);
end;
procedure RenderTicket(const CustomerComment: string);
var
Lib: TPDFlib;
Html: WideString;
begin
Lib := TPDFlib.Create;
try
Lib.SetOrigin(1);
Lib.SetMeasurementUnits(0);
Html := '<p><b>Customer comment</b></p>' +
'<p>' + EscapeHTMLText(CustomerComment) + '</p>';
Lib.DrawHTMLText(50, 50, 495, Html);
Lib.SaveToFile('ticket.pdf');
finally
Lib.Free;
end;
end;Ona Try <a href="https://example.com">this</a> & <b> yorumunu verin; sayfa o karakterleri bire bir gösterir. İki kez çözen bir renderer altında aynı kaçırılmış girdi, canlı bir link annotation olur. Kozmetik arızadan güvenlik sorununa basamak budur: bir talep yorumu, kendi personelinize giden bir PDF'e tıklanabilir bir URL ekleyebilmemelidir
Yardımcının neleri bozulmadan bıraktığına dikkat edin. Genel amaçlı escaper'lar ayrıca "'i "'e ve ''i ''e çevirir; tarayıcı için doğru, burada yanlış — PDFlibPas metin çözümü, yukarıda listelenen dört entityyi bilir; o ikisi birebir " ile ' yazılır. Bunun için bir tarayıcı escaper'ını yeniden kullanmayın. Tırnaklar metin içeriğinde zararsızdır; yalnızca attribute değerlerinin içinde önemli olurlar ve renderer entityleri attribute'lerde hiç çözmez. Attribute'ler için daha zekice bir escaper'dan çok bir kural isteriz; çünkü orada kaçırma şeması yine de kontrol edilmez: kullanıcı değerlerini href, src ile style dışında tutun. Bir link hedefi gerçekten kullanıcı girdisinden gelecekse kendiniz, şemalar ile karakterlerin bir izin listesine karşı doğrulayın ve tırnak ya da açı parantezi taşıyan her şeyi reddedin
İki alışkanlık tek geçişli çözümden doğrudan izler:
- Daima
&'i kaçırın. Atlarsanız<içeren kullanıcı metni<olarak görünür — zararsız, ama kullanıcının yazdığı bu değil - Tek noktada kaçırın. İki escaper'dan geçen metin
<'i görünür<yazımıyla render eder; verinizin HTML string'ine girdiği tek yeri bulun ve orada kaçırın
LeftOverText ile sayfalama, kaçışları bozmadan
DrawHTMLTextBox sığmayan HTML'i döndürür — genelde LeftOverText denir — ve o kalan, sonraki kutuya girerken birebir entity yazımları ile kaçırılmış açı parantezlerini sağlam tutar. Aldığınız gibi geriye geçirin
const
  BoxLeft = 50;
  BoxTop = 50;
  BoxWidth = 495;    // punto cinsinden bir A4 sayfa için boyutlu
  BoxHeight = 740;
  MaxPages = 500;    // kendi güvenlik tavanınız

procedure RenderLongHTML(Lib: TPDFlib; const Html: WideString);
var
  Rest: WideString;
  Pages: Integer;
begin
  Lib.SetOrigin(1);
  Lib.SetMeasurementUnits(0);
  Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Html);
  Pages := 1;
  while (Rest <> '') and (Pages < MaxPages) do
  begin
    Lib.NewPage;
    Inc(Pages);
    // Kalan çoktan kaçırılmış HTML'dir: asla kaçırma ya da çözme
    Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Rest);
  end;
  if Rest <> '' then
    raise Exception.CreateFmt('Content still left after %d pages', [MaxPages]);
end;
Kalanı opak muamele edin. Stilleri her tag üzerine çözülmüş normalize HTML'dir; kendi escaper'ınızdan geçirmek her <'i &lt;'e çevirir, çözmek ise sonraki kutuya canlı tag verir. İçine taze kullanıcı metni dikmek aynı iki başarısız biçimde biter. Sayfa tavanı bir karşılaştırma masrafıdır: bir element kutuya asla sığamıyorsa tavansız döngünün doğal çıkışı yoktur
Markdown'ın kendi devamı vardır. DrawMarkdownTextBox, bir işaret yorumuyla başlayan bir kalan döndürür; o işaret Markdown giriş noktalarına, sıradaki çağrıda dönüşümü atlamasını söyler. Onu DrawMarkdownTextBox'a ya da DrawMarkdownText'e geri verin, LeftOverText'i DrawHTMLTextBox'a geri verdiğiniz gibi. Bir Markdown kalanı Markdown giriş noktalarına aittir; o tarafta tutun ve yalnızca DrawHTMLTextBox kalanlarını HTML çağrılarına yönlendirin
Bütün bunların arkasındaki biçim — ayrıştır, aynı sözdizimine geri yaz, yeniden ayrıştır — template engine'lerde, HTML sanitizer'larda ve Markdown-to-HTML-to-PDF zincirlerinde de ortaya çıkar ve başarısızlık iki yönlü gelir. Az yeniden kodlama veriyi sözdizimine çevirir. Çok kodlama ya da iki kez koşan bir decoder, okuyucuya entity yazımlarını gösterir ya da onları yutar. Tek yönü yamamak ötekini bozma eğilimindedir; PDFlibPas renderer'ı bu yüzden & çözümünü, en son çözmeyi, geç çözümün olmamasını ve her sınırda yeniden kaçtırmayı tek bir paket olarak görür. Export yönü aynı kuralı Delphi'den PDF'den Markdown ve DOCX semantik exportta izler; her birebir karakter, hedef sözdizimi için tam olarak bir kez kaçırılır
HTML ile Markdown çizimi, dataset rapor exporter'ı ve düzen engine'inin gerisi, Delphi ile Free Pascal için native Pascal kaynağı olarak PDF Library for Delphi ile gelir. Sürümler, platform kapsamı ile deneme indirmesi PDF Library for Delphi ürün sayfasında listelenir