PDF'leri art arda eklemek ucuz olmalıymış gibi görünür. Sayfa içeriği zaten yerleştirilmiştir, fontlar zaten gömülüdür, görseller zaten sıkıştırılmıştır. İlke olarak birleştirme sadece muhasebe işidir: iki dosyanın numaralandırma alanları çakışmasın diye nesneleri yeniden numaralandır, sayfa ağaçlarını birbirine dik, cross-reference tablosunu düzelt ve yaz. Pratikte çoğu merge kodu bu ucuzluğu çöpe atar. Her girdi dosyasındaki her nesne için token'lara ayrılmış tam nesne ağacına ayrıştırma yapar, birkaç dolaylı başvuruyu değiştirir, sonra ağacı tekrar baytlara serileştirir. Pahalı olan yarılar parse ile yeniden serileştirmedir; nesnelerin büyük çoğunluğu için bunların ürettiği bayt dizisi, girene neredeyse birebir aynıdır
PDF Library for Delphi, Delphi ve C++Builder için yerel bir Object Pascal PDF motorudur ve hızlı merge yolu, kanıtlanabilir biçimde güvenli olan her yerde o gidiş-dönüşü atlamak için vardır. Fikir dardır ama bütün belge setleri üzerinden geri öder: değiştirilmemiş bir stream olmayan nesne için özgün kaynak baytlarını aynen alın ve içerdikleri dolaylı başvuruların tek seferlik bayt düzeyinde yeniden yazımını yapın; her N G R'yi (N+Offset) G R'ye çevirin. Ne tokenizer var ne nesne ağacı ne serileştirici. Bu yazı, o kısayolun nerede meşru olduğunu, bayt yeniden yazımını hiçbir şeyi bozmadan yapan ayrıştırıcı durum makinesini, bookmark merge'inin neden bambaşka bir mekanizma istediğini ve sıradan merge yolunun aynı tek doğrusal geçişi nasıl paylaştığını ele alıyor
Nesne yeniden numaralandırması neden merge'in asıl maliyetidir
Her PDF kendi nesne numaralandırma alanını taşır. Dosya A'da nesne 1, nesne 2 ve devamı vardır; dosya B'de de kendi nesne 1'i, 2'si ve devamı vardır. B'nin nesnelerini A'nın dosyasına değiştirmeden bırakamazsınız; çünkü numaralar çakışır ve B'nin içindeki her dolaylı başvuru artık yanlış nesneye çözülür. Çözüm bir ofsettir: A, Offset nesne sayısında bitiyorsa B'nin N nesnesi çıktıda N+Offset nesnesi olur ve B nesnelerinin herhangi bir yerinde görünen her N G R başvurusu da buna uyacak şekilde (N+Offset) G R başvurusuna kaydırılmalıdır
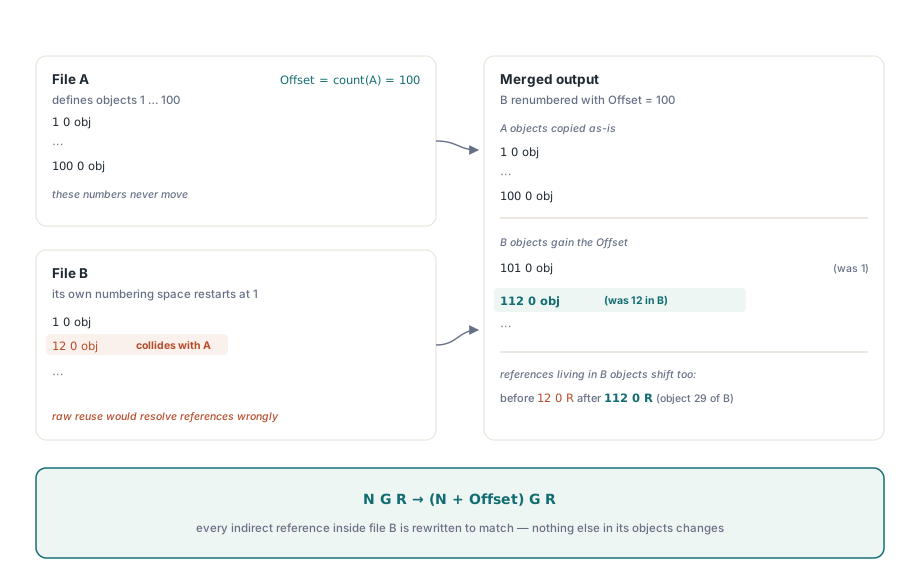
Bu kaydırma, gövdeyi birleştirmenin bütün anlamsal işidir. Sayfa ağacı düzeltmeleri ile AcroForm merge, bir avuç nesne üzerinde yapılan küçük ve sınırlı düzenlemelerdir. Asıl kütle işi, binlerce nesne boyunca başvuruları yeniden yazmaktır ve bunu saf yoldan yapmanın yöntemi, başvuruları yapısal olarak bulabilmek için her nesneyi ayrıştırmaktır. PDF Library for Delphi içindeki MergeFileListFast yordamı ters görüşü benimser: yeterince dikkatli olursanız başvurular ham baytlarda da bulunabilir; önemli olan, rakam-boşluk-rakam-boşluk-R dizisinin gerçekte başvuru olmadığı bağlamları ayırmaktır. Parse'i atlayın, yerinde kaydırın ve nesne başına maliyet, zaten kopyalayacağınız baytlar üzerinde tek lineer taramaya düşsün
Kaynak baytlarını yeniden kullanmak hangi durumda kanıtlı biçimde güvenlidir
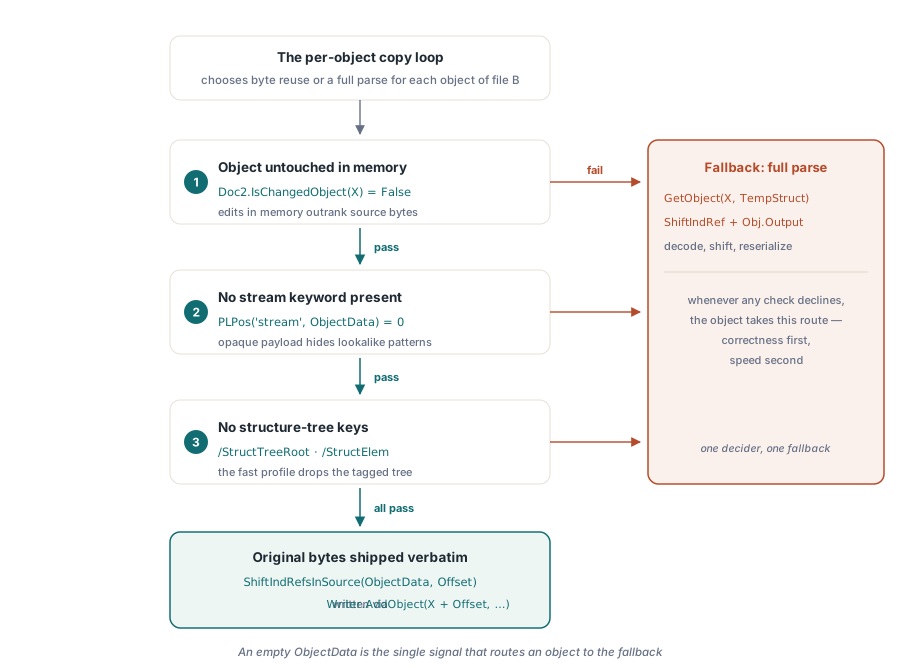
Bayt yolu, yalnızca takip eden belgeden çıkışa kopyalanan nesne için üç koşulun da sağlandığı durumda alınır. Bunlardan herhangi biri başarısız olduğunda nesne tam decode-and-reserialize yoluna geri gönderilir; dolayısıyla doğruluk her zaman hızdan önce gelir:
Doc2.IsChangedObject(X)değeri False olmalıdır. Merge motoru nesneyi bellekte zaten değiştirdiyse — örneğin/Parentalanı yeniden işaretlenmiş sayfa nesnesi gibi — bellekteki ağaç doğruluk kaynağıdır ve özgün baytlar bayat kalmıştır. Yalnızca dokunulmamış nesneler uygundur- Kaynak baytlar
streamanahtar sözcüğünü içermemelidir. Stream nesnesinin gövdesi,stream/endstreamile çerçevelenmiş opak ikili veridir ve sıkıştırılmış veya şifrelenmiş stream verisi üzerinde saf başvuru taraması, başvuruya benzeyen bayt desenlerini seve seve bulup bozar. Stream nesneleri özgün stream farkındalıklı yolda kalır - Kaynak baytlar ne
/StructTreeRootne de/StructElemiçermelidir. Hızlı profilde tagged-PDF structure tree merge edilmek yerine bırakılır; bu nedenle bu nesnelerin, motorun bunları bilinçli biçimde null yapabildiği decode yolundan geçmesi gerekir
Karar, nesne başına kopyalama döngüsünde yaşar. Üç denetim de geçerse nesnenin baytları doğrudan ShiftIndRefsInSource içine ve oradan yazıcıya gider; aksi halde baytlar atılır ve nesne GetObject ile yeniden kurulur, ShiftIndRef ile kaydırılır ve serileştirilir. Bu dalın yapısını görmekte fayda var; güvenliği sağlayan şey denetimlerin sırasıdır:
ObjectData := '';
if not Doc2.IsChangedObject(X) then
begin
  ObjectData := FastMergeObjectSource(Reader2, X);
  if (PLPos('stream', ObjectData) > 0) or
     ((not PreserveStructTree) and (PLPos('/StructTreeRoot', ObjectData) > 0)) or
     ((not PreserveStructTree) and (PLPos('/StructElem', ObjectData) > 0)) then
    ObjectData := ''                                  // decode işlemine geri dön
  else
    ObjectData := ShiftIndRefsInSource(ObjectData, Offset);
end;

if ObjectData <> '' then
  Writer.AddObject(X + Offset, Doc2.GetGenNum(X), ObjectData)
else
begin
  Obj := Doc2.GetObject(X, TempStruct);              // tam ayrıştırma yolu
  // ... struct-tree nesnelerini, ShiftIndRef'i ve Obj.Output'u null yap ...
end;
Boş bir ObjectData, bayt yolunun nesneyi reddettiğinin işaretidir. Bu tek işaret değeri, hızlı ve yavaş yolların birbirinden kopmasını engeller: karar veren tam bir yer vardır ve geri düşme de tam bir yerdedir
Başvuru kaydırma durum makinesi ve köşe durumları
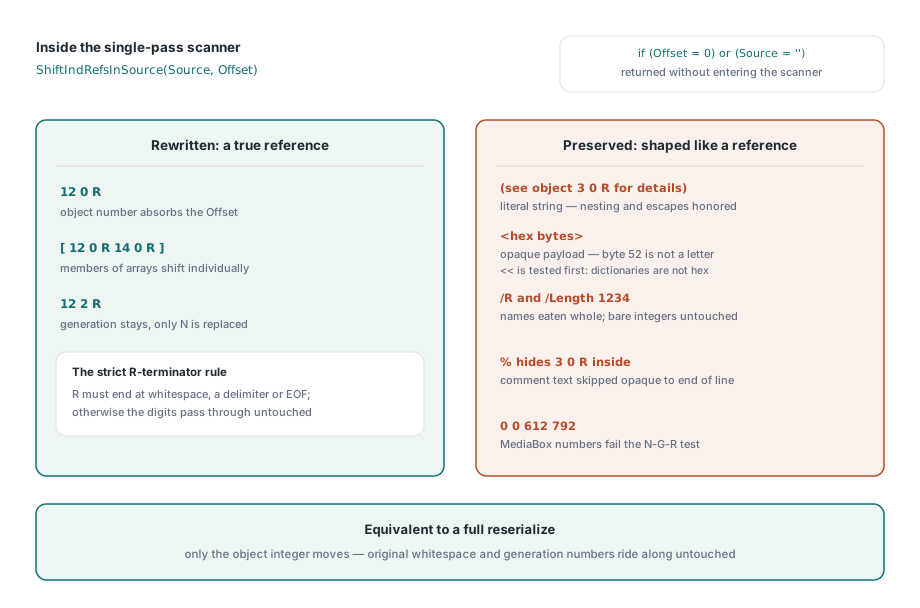
Dolaylı başvuruların bayt düzeyinde yeniden yazımı aldatıcı biçimde kolay görünür; çünkü R ve rakam dizileri, başvuru olmayan bağlamlarda da PDF nesnesinin her yanında görünür. ShiftIndRefsInSource, baytları bir kez yürüyen küçük el yazımı tarayıcıdır ve bir sayıyı yalnızca sonrasında PDF boşluğu ile ayrılmış başka bir sayı ve ardından R ayıracı geldiğinde yeniden yazar. Ucuz çıkışlar en başta gelir: ofset sıfırsa veya kaynak boşsa, tarayıcıya hiç girmeden baytlar dokunulmadan döndürülür
Tarayıcının doğruluğu, başvuru şeklindeki dizinin dokunulmadan bırakılması gereken bağlamları tanımaya dayanır. Kaçırması en kolay sınırlar bunlardır ve her biri açıkça ele alınır:
- Literal string'ler,
(ile)arasında sınırlanır ve aynen kopyalanır; iç içe geçme derinliği izlenir, ayrıca backslash escape dikkate alınır; böylece escape edilmiş parantez derinlik sayımını bozmaz.(see object 3 0 R for details)gibi bir dizge, kitap gibi başvuru desenini aslında düz yazı olarak taşır ve bayt bayt korunmalıdır - Hexadecimal string'ler,
<ile>arasında sınırlanır ve yorumlanmadan geçirilir. Hex string içindeki52baytlarıRiçin ASCII kodudur; hex yükünü metin gibi ele alan tarayıcı hayalet başvuru üretebilir. Sözlüğün açılışındaki<<işareti önce tanınır; böylece sözlük, hex string sanılmaz - Name nesneleri,
/ile başlar ve slash'tan sonraki ilk boşluk ya da ayıraca kadar bütünüyle tüketilir. Bu olmazsa/Rgibi bir ad — yaygın bir resource anahtarıdır — başvurununRkısmı gibi okunabilir - Yorumlar,
%ile başlar, satır sonuna kadar gider ve opak metin olarak atlanır - Sayı-sonra-R testi katıdır Bir başvuru ancak
NboşlukGboşlukRbiçimindeyse veR, boşlukla, ayıraçla veya giriş sonuyla sonlanıyorsa tanınır. Nesil numarası yoksa ya daRsonrası harfse, rakamlar olduğu gibi yazılır./Length 1234içindeki tamsayıyı veMediaBoxiçindeki dört sayıyı sessizce artırmaktan koruyan şey budur
Bu katı testin kalbi, neredeyse belirtim cümlesinin anlattığı gibi okunur:
if (P <= N) and (Source[P] = 'R') and
   ((P = N) or PLIsPdfWhite(Source[P + 1]) or PLIsPdfDelimiter(Source[P + 1])) then
  Obj1 := PLStrToIntDef(PLCopy(Source, I, E1 - I), -1);

if Obj1 >= 0 then
begin
  AppendStr(PLIntToStr(Obj1 + Offset));   // kaydırılmış nesne numarası
  AppendBytes(E1, P - E1);                 // original whitespace + generation
  AppendBytes(P, 1);                       // the 'R'
end;
Yalnızca nesne numarası yeniden yazılır; nesil numarası ve token'lar arasındaki tam özgün boşluk aynen kopyalanır, böylece çıktı, değişmesi gereken tek tamsayı dışında girdiyle bayt bayt aynıdır. O hassasiyet tüm noktadır — kaynak baytları yeniden kullanmayı tam bir yeniden serileştirmeye eşdeğer kılan da odur, yalnızca ona yakın olan değil. Böyle bir tarayıcıyı kendiniz yazarsanız onu çıplak başvurularla, diziler içindeki başvurularla, başvuru olmayan sayılarla, literal stringlerle, hex stringlerle ve sıfır olmayan, ofset uygulanmış nesil numaralarıyla test edin
Yer imleri neden AppendOutline'ı yeniden kullanamadı
Birden çok belgenin yer imlerini tek outline ağacında birleştirmek, bir belgenin üst düzey yer imlerini diğerine eklemeyi zaten bilen mevcut AppendOutline yardımcısının işi gibi görünür. Ama burada yanlış araçtır ve nedeni ince bir katmanlama uyuşmazlığıdır. AppendOutline, güncel son üst düzey yer imini, reader'ı özgün dosya baytları üzerinde gezdirerek bulur. Oysa hızlı merge, düzenlemelerini ChangeObject üzerinden bir yeni-nesneler tamponunda bekletir; reader o düzenlemeleri hiç görmez. Üç ya da daha çok belgeyi zincirleyseniz her ekleme, birinci belgenin özgün son yer imini en yeni belgeye yeniden işaretlerdi; böylece ara belgelerin yer imleri zincirden düşerdi — yalnızca kümülatif /Count doğru kalırdı, bu da sorunu, biri yer imi panelini açana kadar gözden kaçması kolay kılar
Hızlı yol bunu, reader üzerinde yeniden yürümeyen iki aşamalı metadata tabanlı enjeksiyonla çözer. Tüm girdiler üzerindeki ilk geçiş, belge başına outline root nesnesini ve nesil numaralarını, ilk ve son üst seviye yer imi numaralarını ve root'un /Count değerini toplar. Bu özetten kod, inşa etmesi gereken her bağlantının global nesne numaralarını hesaplar — her belgenin üst seviye /Parent bağlantısı paylaşılan root'a, ilk yer iminin /Prev bağlantısı önceki belgenin son yer imine, son yer iminin /Next bağlantısı sonraki belgenin ilk yer imine — ve bunu saf nesne numarası aritmetiğiyle yapar. Bunun arkasında yazma sırası kısıtı vardır: ilk belgenin nesneleri, sonraki belge daha açılmadan yazıldığı için ilk belgenin tüm outline düzenlemeleri (root /Count ve /Last ile eski son yer iminin /Next değeri), elde daha sonraki belge yokken yalnızca aritmetikle ifade edilebilir olmalıdır. Sonraki her belgenin düzenlemesi ise belge açıldıktan sonra ama yazılmadan önce yerinde uygulanır; dolayısıyla aynı change-object yolu üzerinden dışarı taşınır
Her şeyi bağlayan ofset hizalama değişmezi
Hem başvuru kaydırma hem yer imi enjeksiyonu tek aritmetik değişmeze dayanır; bu da tasarımın en kırılgan varsayımıdır. Takip eden belge içine enjekte edilen başvuru, hedef global nesne numarası eksi o belgenin Offset değeri olarak yazılır; böylece nesne daha sonra ShiftIndRef(Offset) ile kaydırıldığında değer hedef global numaraya iner. İlk belge Offset = 0 alır ve global numaraları doğrudan kullanır. Bu çıkarmanın doğru olması için enjeksiyon sırasında kullanılan akış ofset dizisinin, nesneler gerçekten yazılırken kullanılan ofset dizisiyle birebir eşleşmesi gerekir
Eşleşir; çünkü sayfa ve form merge işlerinin çalışma biçimi buna izin veren özelliğe sahiptir: AddPages, AddFields ve AddFieldFonts yalnızca ilk belgenin mevcut nesnelerini değiştirir; yeni nesne eklemez. Dolayısıyla ilk belgenin nesne sayısı sayfa-merge aşamasında değişmez ve her takip eden belgenin ofseti — ondan önce gelen tüm belgelerin nesne sayılarının toplamı — enjeksiyondan yazmaya kadar sabit kalır. Bunu bozarsanız, yani merge ortasında yeni nesne oluşturan aşama eklerseniz, aşağı akıştaki her sayfa ve yer imi başvurusu, eklediğiniz nesne sayısı kadar kayar. Değişmez sessizdir ama taşıyıcıdır
Tek motor üzerinde üç giriş noktası
Hızlı yol, merge kodunun bir çatalı değildir. Bayt düzeyindeki motor, MergeFileListInternal(ListName, OutputFileName, PreserveStructTree, StrictMode) adında tek bir iç yordamdır ve genel API'ler iki bayrağı seçen ince sarmalayıcılardır:
MergeFileListFast, structure-tree korumayı kapalı olarak motoru çağırır; bu en yalın yoldur ve tagged-PDF tree'si bırakıldığı için bayt yolu en çok nesneye uygulanabilirMergeFileList, korumayı açık çağırır; böylece structure tree yaşar ve sonuç kullanılabilir tagged PDF olarak kalır. Bu sıradan yol aynı zamanda çok belgeli yer imi ve form merge işini de devralırMergeFileListStrict, strict mode'u açar: ilk metadata geçişi temiz merge rapor etmeyen ilk girdide durur; böylece kötü dosyayı atlayıp devam etmek yerine yalnızca ondan önce toplanmış belgeler dahil edilir
Üçü de tek motoru paylaştığı için sıradan merge de her girdiyi bir kez açan tek bir doğrusal geçiş olarak çalışır; dosya bir-ikiyi merge edip sonucu üçle merge eden ve her adımda büyüyen biriktiriciyi yeniden ayrıştıran ikili O(N²) bir döngü yerine. Gerçekten ikili bir merge isteyen çağıranlar için MergeFiles ve MergeStreams giriş noktaları hâlâ duruyor
Structure-tree davranışı hakkında bir not; çıktıyı baytlara bakarak doğruluyorsanız önemlidir. Hızlı yol, ağacı birinci belgenin kataloğunun /StructTreeRoot başvurusunu kaldırarak düşürür; structure-tree nesnesinin kendisi hâlâ yazılır, ancak artık hiçbir yerden başvurulmaz. Yani hızlı çıktının baytlarında /StructTreeRoot stringi hâlâ vardır ve o stringi aramak hızlıyı sıradan çıktıdan ayırt etmez — gerçek fark, kataloğun structure ağacına hâlâ ulaşıp ulaşmadığıdır ve dosyanın hâlâ gezilebilir bir tagged PDF olup olmadığını belirleyen de budur
Hangi yol ne zaman seçilmeli
Bayt yolu, tagged-PDF structure ağacının korunmasına gerek olmayan çok belgeli birleştirmeler için bir verim optimizasyonudur — rapor demetleri, hesap dökümü serileri, toplu art arda ekleme. Orta-büyük girdi setlerinin tekrarlanan mergeleri üzerinden ölçüldüğünde bayt yeniden kullanımı, nesne karışımına bağlı olarak duvar saati süresinden kabaca yüzde dört ile on üç arası kesebilir; küçük ya da bozuk girdiler tam yol ile birebir aynı davranır, çünkü tarayıcının güvenli olduğunu kanıtlayamadığı her nesne tam ayrıştırmaya döner. Structure ağacına erişilebilirlik için ihtiyacınız varsa onu koruyan sıradan tagged-PDF merge yolunu kullanın; çok sayıda girdi yerine çok büyük tek dosyalarla çalışıyorsanız, doğrudan dosya erişimiyle büyük PDF merge ve split yardımcı yazısındaki bayt kopyalama teknikleri, aynı "baytları kopyala, tam nesne ağacından kaçın" felsefesini dosya ölçeğinde uygular
Merge yordamları ile onların hızlı ve strict varyantları, PDF Library for Delphi Delphi PDF Library ürününün parçasıdır; dokümantasyonu burada anlatılan file-list API'si ve merge seçenekleri için tam başvuruyu taşır