Delphi และ Lazarus คอมไพล์ Object Pascal ตัวเดียวกัน และความคล้ายกันในผิวหน้านี่แหละที่ทำให้การพอร์ตตัวแสดงผลระหว่างสองฝั่งดูลวงตาว่าง่าย สองทูลเชนนี้แตกต่างกันในสามจุดที่สำคัญต่องาน PDF: ชนิด string ดั้งเดิมเป็น UTF-16 ใน Delphi แต่เป็น UTF-8 ในแอปพลิเคชัน LCL; VCL กับ LCL เป็นเฟรมเวิร์กด้านภาพที่ต่างกัน มีคอนโทรล ไดอะล็อก และรูปแบบการสตรีมฟอร์มเป็นของตัวเอง; และไบนารีของ Delphi มุ่งเป้าไปที่ Windows ในขณะที่ไบนารีของ FPC อาจมุ่งไปที่ Linux หรือ macOS ก็ได้ ความแตกต่างเหล่านี้ไม่มีสักข้อที่จะโผล่ให้เห็นตอนคอมไพล์ ตัวแสดงผลที่สร้างบน PDFium Component ซึ่งมีรุ่น VCL และ LCL มาจากซอร์สโค้ดต้นทางชุดเดียวกัน จะคอมไพล์ผ่านฉลุยบน Lazarus หลังจากสลับชื่อยูนิตไม่กี่ตัวและเพิ่มบล็อก {$IFDEF FPC} อีกไม่กี่จุด ความล้มเหลวจะมาปรากฏทีหลัง เมื่อข้อมูลจริงและการดีพลอยจริงเผยให้เห็นข้อสมมติที่บิลด์ Delphi แอบตั้งไว้เงียบ ๆ
ข้อสมมติสี่ข้อในนั้นคือต้นเหตุของเวลาที่เสียไปส่วนใหญ่: การเข้ารหัสข้อความที่จุดต่อ UI, สิ่งล่อใจให้ดูแลฟอร์มสองชุดคู่ขนานกัน, วิธีที่ไบนารีเอนจินเนทีฟถูก resolve ตอนรันไทม์ และจังหวะที่ text-to-speech หมดแพลตฟอร์มให้ใช้เมื่อ SAPI หายไป แต่ละข้อจัดการได้ง่ายและถูกถ้าคุณรู้ล่วงหน้าว่ามันจะมา แต่จะแพงและตามแก้ยากถ้าคุณไม่รู้
Pascal ตัวเดียวกัน แต่ payload ของสตริงต่างกัน
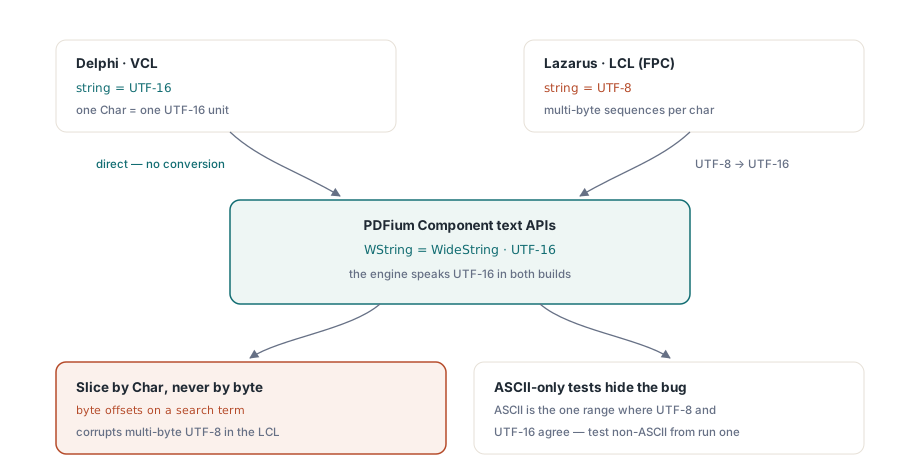
string ดั้งเดิมของ Delphi เป็น UTF-16 มาตั้งแต่ปี 2009 ส่วน Lazarus และ Free Pascal ใช้ UTF-8 เป็นค่าเริ่มต้นในแอปพลิเคชัน LCL API ฝั่งข้อความของคอมโพเนนต์สื่อสารด้วย UTF-16 ผ่านชนิด WString ซึ่งบิลด์ FPC ตั้งเป็นชื่อสำรอง (alias) ของ WideString ดังนั้นทุกจุดต่อที่ข้อความข้ามระหว่าง UI ฝั่ง LCL ของคุณกับเอนจิน PDF จึงเป็นจุดแปลงรหัสทั้งสิ้น
การแปลงรหัสจะเกิดขึ้นอัตโนมัติในการกำหนดค่าแบบตรงไปตรงมา และโค้ดส่วนใหญ่ไม่ต้องคิดถึงมันเลย มีสองนิสัยที่ช่วยกันบั๊กเรื่องการเข้ารหัสไว้ได้ ข้อแรกคือส่งต่อข้อความตรง ๆ โดยไม่ไปแตะระดับไบต์: โค้ดที่ตัดคำค้นหาตาม byte offset ใช้งานได้ใน Delphi ที่หนึ่ง Char เท่ากับหนึ่งหน่วย UTF-16 แต่จะทำให้ UTF-8 แบบหลายไบต์เสียหายใน LCL ข้อสองคือให้ทดสอบด้วยข้อมูลที่ไม่ใช่ ASCII ตั้งแต่การรันครั้งแรก ชื่อไฟล์ภาษาเยอรมัน คำค้นหาภาษารัสเซีย (Cyrillic) ชื่อผู้เขียนที่มีเครื่องหมายเน้นเสียงในเมทาดาทาของเอกสาร: ข้อมูลทดสอบที่เป็น ASCII ล้วนจะซ่อนข้อบกพร่องด้านการเข้ารหัสทุกอย่างไว้ เพราะ ASCII เป็นช่วงเดียวที่ UTF-8 กับ UTF-16 ตรงกันไบต์ต่อตัวอักษรพอดี บั๊กมีอยู่จริงตลอดเวลา เพียงแต่ ASCII ทำให้มันมองไม่เห็นจนกว่าลูกค้าที่มิวนิกจะเปิดไฟล์ที่คุณไม่เคยลองมาก่อน
บล็อกเงื่อนไขบล็อกเดียว ไม่ใช่การแยกโค้ดต่อ IDE
หลังจากผ่าน IFDEF ไปสักสิบกว่าตัว โค้ดเบสจะเริ่มรู้สึกเหมือนสองโปรเจกต์ที่สวมเสื้อรีโพเดียวกัน และการแยกโค้ดต่อ IDE ก็เริ่มดูล่อใจ แต่นั่นเป็นการตัดสินใจที่ผิด เพราะความแตกต่างที่แท้จริงย่อรวมลงในบล็อกประกาศที่ใช้ร่วมกันบล็อกเดียวได้ ในขณะที่การแยกโค้ดจะทำให้ต้นทุนของการแก้บั๊กทุกครั้งนับจากนั้นเพิ่มเป็นสองเท่า ให้เก็บชั้นเงื่อนไขนี้ให้เล็กที่สุดแบบนี้:
{$IFDEF FPC}
uses
  LCLType, Forms, Graphics, Controls;

type
  WString = WideString;   // API ข้อความของคอมโพเนนต์เป็น UTF-16
  TBytes  = array of Byte;
{$ELSE}
uses
  Winapi.Windows, Vcl.Forms, Vcl.Graphics, Vcl.Controls;
{$ENDIF}
ทุกอย่างที่อยู่ใต้บล็อกนั้นคอมไพล์เหมือนกันทุกประการในทั้งสอง IDE การจัดการเอกสาร การเปลี่ยนหน้า การเรียกเรนเดอร์: TPdf และ TPdfView เปิดพื้นผิว API เดียวกันทั้งในรุ่น VCL และ LCL ดังนั้นตัวแสดงผลส่วนใหญ่จึงไม่มีวันเห็นเงื่อนไขคอมไพเลอร์เลย การรักษาให้เป็นแบบนี้คือวินัยเชิงโครงสร้าง ไม่ใช่เทคนิคเจ๋ง ๆ ตรรกะ PDF ที่ใช้ร่วมกันอยู่ในยูนิตที่ไม่ดึงไดอะล็อกหรือแผงเฉพาะเฟรมเวิร์กใด ๆ เข้ามาเลย ส่วนสิ่งเล็ก ๆ น้อย ๆ ไม่กี่อย่างที่ต่างกันจริง ๆ เช่นไดอะล็อกพิมพ์และตัวเลือกไฟล์ที่ตามธรรมเนียมของแต่ละแพลตฟอร์ม จะซ่อนอยู่หลังอินเทอร์เฟซบาง ๆ ที่ทำไว้ครั้งเดียวต่อเฟรมเวิร์ก บล็อก IFDEF จึงกลายเป็นที่เดียวที่ยอมให้ความต่างของแพลตฟอร์มในอนาคตมาลงจอด แทนที่จะให้ directive ของคอมไพเลอร์รั่วไหลกระจายไปทั่วสี่สิบยูนิต
สร้างฟอร์มด้วยโค้ด ไม่ใช่ด้วยดีไซเนอร์สองตัว
การสตรีมฟอร์มคือจุดที่โปรเจกต์แบบสอง IDE ค่อย ๆ ผุพังไปอย่างเงียบ ๆ ไฟล์ .dfm กับ .lfm ที่อ้างว่าอธิบายฟอร์มเดียวกัน จะค่อย ๆ เพี้ยนออกจากกันทีละพร็อพเพอร์ตี้ จนสองบิลด์ทำงานต่างกันด้วยเหตุผลที่ไม่มีใคร diff ได้ เพราะไฟล์ทั้งสองไม่ได้อยู่ในฟอร์แมตเดียวกันด้วยซ้ำ การสร้างตัวแสดงผลตอนรันไทม์หลีกเลี่ยงปัญหาทั้งหมดนี้ไปเลย มีลำดับ constructor เดียว ควบคุมเวอร์ชันเป็นโค้ดธรรมดา และอ่านเหมือนกันทั้งสองแพลตฟอร์ม:
procedure TViewerForm.FormCreate(Sender: TObject);
begin
  Pdf := TPdf.Create(Self);

  PdfView := TPdfView.Create(Self);
  PdfView.Parent := Self;
  PdfView.Align := alClient;
  PdfView.Pdf := Pdf;
  PdfView.FitMode := pfmFitWidth;

  if ParamCount > 0 then
  begin
    Pdf.FileName := ParamStr(1);
    Pdf.Active := True;   // เปิดเอกสาร; PageCount ใช้งานได้ถูกต้องหลังจากบรรทัดนี้
  end;
end;
ลำดับที่แน่นอนของการกำหนดค่าเหล่านั้นสำคัญน้อยกว่าบรรทัดเดียวที่ทำงานจริง ๆ PdfView.Pdf := Pdf ผูกคอนโทรลที่แสดงผลเข้ากับคอมโพเนนต์เอกสาร และนับจากจุดนั้น การเปลี่ยนหน้าผ่าน PageNumber และพฤติกรรมการปรับพอดีผ่าน FitMode จะตอบสนองเหมือนกันทุกประการทั้งใน VCL และ LCL มีความแปลกประหลาดข้ามเฟรมเวิร์กจุดหนึ่งที่ควรรู้ไว้ก่อนที่ผู้ใช้จะแจ้งว่าเป็นบั๊ก: การกำหนดค่า Zoom ด้วยมือจะดีด FitMode กลับไปเป็น pfmNone ในทั้งสองเฟรมเวิร์ก ดังนั้นถ้าทูลบาร์ของคุณถือว่า "fit width" เป็นค่าที่ต้องติดค้างไว้ (sticky preference) คุณต้องกำหนดโหมดปรับพอดีใหม่หลังการซูมด้วยโปรแกรมทุกครั้ง ไม่อย่างนั้นค่าที่ตั้งไว้จะเลิกติดค้างไปเงียบ ๆ ทันทีที่โค้ดแตะระดับการซูมเป็นครั้งแรก
ไบนารีที่ IDE ไม่เคยเตือนคุณล่วงหน้า
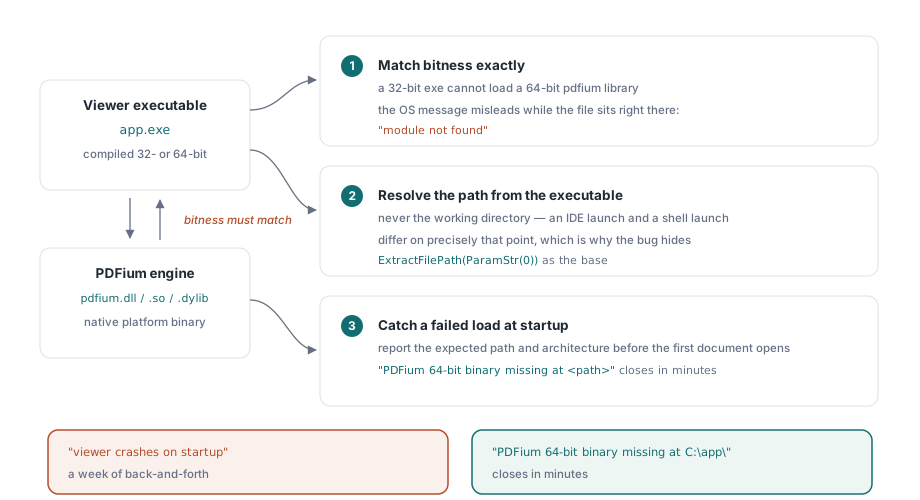
คอมโพเนนต์นี้ห่อหุ้มเอนจิน PDFium ซึ่งมาในรูปไบนารีเนทีฟของแต่ละแพลตฟอร์ม และไบนารีตัวนี้แหละคือต้นตอของรายงานแบบ "ใช้งานได้ใน IDE แต่พังตอนรันจากช็อตคัตที่ติดตั้งแล้ว" เกือบทุกครั้ง มีสามกฎที่อธิบายกรณีส่วนใหญ่ได้ ข้อแรก bitness ต้องตรงกันเป๊ะ ๆ executable แบบ 32 บิตโหลดไลบรารี pdfium แบบ 64 บิตไม่ได้ และข้อความที่ OS ส่งกลับมา ("module not found" ใน Windows บางเวอร์ชัน) ทำให้เข้าใจผิดไปเลย เพราะไฟล์นั้นก็นอนอยู่ข้าง ๆ executable นั่นแหละ ข้อสอง resolve เส้นทางไลบรารีโดยอ้างอิงกับ executable เสมอ ไม่ใช่ working directory เพราะการรันจาก IDE กับการรันจาก shell ต่างกันตรงจุดนี้พอดี นี่คือเหตุผลที่บั๊กซ่อนตัวอยู่ตลอดช่วงพัฒนา และข้อสาม ให้ดักจับการโหลดที่ล้มเหลวก่อนที่เอกสารแรกจะเปิด แล้วรายงานออกมาพร้อมระบุเส้นทางและสถาปัตยกรรมที่คาดหวังไว้ชัดเจน ตั๋วซัพพอร์ตที่เขียนว่า "PDFium 64-bit binary missing at <path>" ปิดจบได้ในไม่กี่นาที ส่วนตั๋วที่เขียนว่า "viewer crashes on startup" กลายเป็นการโต้ตอบไปมาทั้งสัปดาห์
ในระหว่างนี้ ให้กำหนดเวอร์ชันของไบนารีเอนจินควบคู่ไปกับ executable ด้วยเลย PDFium อัปเดตเร็วมาก และตัวติดตั้งที่อัปเดตแอปพลิเคชันแต่ทิ้งไลบรารีเก่าค้างไว้บนดิสก์ จะทำให้เกิด crash ที่ไม่มีใครในออฟฟิศคุณทำซ้ำได้ ด้วยเหตุผลง่าย ๆ ว่าทุกเครื่องในออฟฟิศของคุณบังเอิญมีคู่ที่ตรงกันอยู่แล้ว ให้ถือว่าไลบรารีเป็นส่วนหนึ่งของ build artifact ใช้ตัวติดตั้งเดียวกัน ตราเวอร์ชันเดียวกัน และเส้นทาง rollback เดียวกันกับ executable ที่โหลดมันอยู่
การลงทะเบียนคอมโพเนนต์ใน Lazarus IDE
การสร้างตอนรันไทม์ไม่ต้องลงทะเบียนแบบ design-time เลยแม้แต่นิดเดียว ซึ่งเป็นการตั้งค่าที่สะอาดที่สุดสำหรับตัวแสดงผลที่สร้าง UI ของตัวเองด้วยโค้ด แต่ถ้าคุณต้องการให้คอมโพเนนต์ปรากฏบนพาเลตของ Lazarus สำหรับงานแบบ design-time จริง ๆ ให้ติดตั้งแพ็กเกจแล้วปล่อยให้ยูนิตลงทะเบียนเฉพาะของมัน คือ PDFiumLazReg ใน Lib/FPC/PDFiumLaz.lpk จัดการเรื่องนี้ให้ ยูนิตนั้นถูกทำเครื่องหมายเป็น design-time โดยตั้งใจ เพราะมันอ้างอิงอินเทอร์เฟซตัวแก้ไขพร็อพเพอร์ตี้ของ IDE ที่ต้องไม่ถูกลิงก์เข้าไปใน executable ที่คุณส่งมอบจริงเด็ดขาด
ถ้าทำเรื่องนี้ผิด อาการที่ได้คือแอปพลิเคชันที่พึ่งพาแพ็กเกจของ IDE อย่างไม่มีเหตุผล ซึ่งจะปรากฏเป็นความล้มเหลวในการดีพลอยบนเครื่องลูกค้าเครื่องแรกที่ไม่เคยติดตั้ง Lazarus มาก่อน
การอ่านออกเสียงและโปรแกรมอ่านหน้าจอนอกเหนือจาก Windows
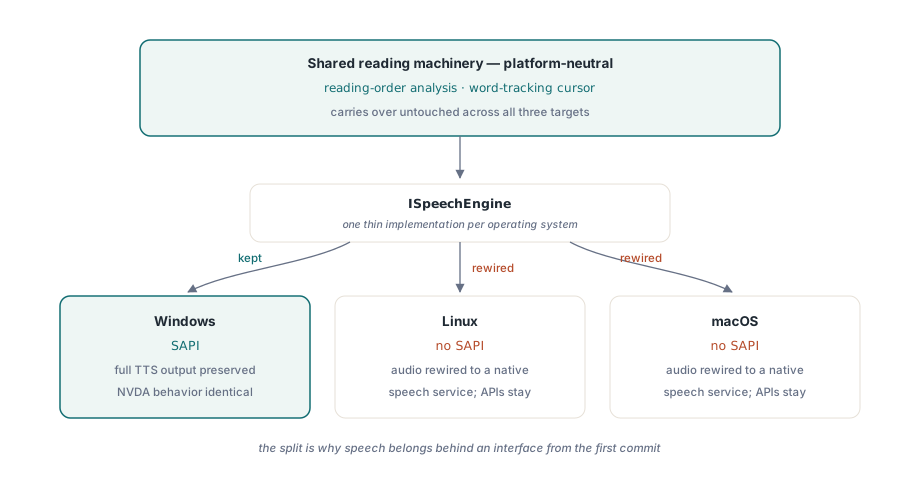
Text-to-speech คือฟีเจอร์เดียวที่เรื่องราวข้ามแพลตฟอร์มพังลง และมันพังที่ระดับระบบปฏิบัติการ ไม่ใช่ที่คอมโพเนนต์ SAPI ซึ่งเป็น backend TTS ปกติบน Windows มีอยู่เฉพาะบน Windows เท่านั้น บิลด์ Lazarus ที่ยังมุ่งเป้าไปที่ Windows จะยังคงให้เสียงออกจาก SAPI เต็มรูปแบบ และมีพฤติกรรมที่เข้ากันได้กับ NVDA เหมือนกับต้นฉบับ Delphi ทุกประการ ดังนั้นการพอร์ตจาก Windows ไป Windows จึงไม่เสียอะไรไปเลยในจุดนี้ และผู้ใช้ NVDA จะแยกสองบิลด์นี้ออกจากกันไม่ได้เลย
แต่เป้าหมายที่เป็น Linux หรือ macOS เป็นอีกเรื่องหนึ่งเลย ไม่มี SAPI ให้เรียกใช้ ดังนั้นเอาต์พุตเสียงต้องต่อสายใหม่ไปยังบริการเสียงพูดเนทีฟของแพลตฟอร์มนั้น ในขณะที่ API การอ่านที่อยู่เหนือมันยังคงอยู่เหมือนเดิม การแยกส่วนนี้แหละคือเหตุผลที่ควรวางเสียงพูดไว้หลังอินเทอร์เฟซตั้งแต่คอมมิตแรก: การวิเคราะห์ลำดับการอ่านและเคอร์เซอร์ที่ไล่ตามคำเป็นกลางต่อแพลตฟอร์มและยกไปใช้ต่อได้โดยไม่ต้องแตะเลย มีแค่ชั้นบาง ๆ ที่ทำหน้าที่ผลิตเสียงจริง ๆ เท่านั้นที่ต้องเปลี่ยนไปตามแต่ละแพลตฟอร์ม บทความการอ่านเพื่อการช่วยการเข้าถึงครอบคลุมกลไกการอ่านนี้อย่างละเอียด
เช็กลิสต์ความเท่าเทียมก่อนประกาศว่าการพอร์ตเสร็จสมบูรณ์
การไล่ตรวจต่อไปนี้เคยจับ regression จริง ๆ ได้มาแล้ว เรียงตามลำดับคร่าว ๆ ที่ความล้มเหลวมักจะโผล่ออกมา เปิดเอกสารที่มีเส้นทาง (path) ที่มีอักขระที่ไม่ใช่ ASCII ค้นหาคำที่มีอักขระที่ไม่ใช่ ASCII แล้วยืนยันว่าผลลัพธ์ไฮไลต์ตรงตำแหน่งที่ควรจะเป็น ลองใช้การเลื่อนล้อเมาส์ การลากเพื่อเลือก และการเปลี่ยนหน้าด้วยคีย์บอร์ดบนแต่ละชุด widget ที่คุณส่งมอบ เพราะการจัดการ focus และพฤติกรรมล้อเมาส์เป็นมุมที่ขึ้นอยู่กับชุด widget มากที่สุดใน LCL ตรวจสอบการเรนเดอร์ที่สเกลการแสดงผล 100%, 150% และ 200% สุดท้าย ให้รันบิลด์ที่ติดตั้งแล้ว ไม่ใช่บิลด์จาก IDE บนเครื่องที่ไม่เคยมี IDE ติดตั้งมาก่อน เพราะนั่นเป็นการทดสอบเดียวที่ทดสอบการ resolve ไบนารีได้จริงอย่างซื่อตรง ทุกอย่างอื่นอาจผ่านได้ทั้งหมดในขณะที่ข้อนี้ล้มเหลวอยู่อย่างเงียบ ๆ
ปริมาณงานเรนเดอร์ (throughput) ยกข้ามระหว่างสองรุ่นได้โดยไม่เปลี่ยนแปลง ดังนั้นแนวทางการแคชจากบทความแคชการเรนเดอร์และประสิทธิภาพการซูมจึงใช้กับตัวแสดงผลฝั่ง LCL ได้ตรงตามที่เขียนไว้สำหรับฝั่ง VCL ทุกประการ
ไม่มีข้อไหนในนี้ที่ทำให้รุ่น LCL ด้อยกว่า พื้นผิวหลักเหมือนกันทุกประการทั้งสองฝั่ง: TPdf, TPdfView, การเรนเดอร์, ฟอร์ม, การดึงข้อความ และ API ด้านการช่วยการเข้าถึงทำงานเหมือนกันไม่ว่า IDE ไหนจะเป็นคนคอมไพล์ ความแตกต่างทุกจุดที่ควรติดตามล้วนผูกกับแพลตฟอร์ม ไม่ใช่ผูกกับรุ่น เสียง SAPI มีเฉพาะบน Windows ไดอะล็อกเป็นไปตามธรรมเนียมของแต่ละเฟรมเวิร์ก และไบนารีต้องตรงกับสถาปัตยกรรมที่มันถูกโหลดเข้าไป จัดการจุดต่อของการเข้ารหัส รูปแบบฟอร์มตอนรันไทม์ และการ resolve ไบนารีให้ถูกต้อง ที่เหลือของการพอร์ตก็เป็นแค่งานเชิงกลไกที่คอมไพเลอร์จัดการให้คุณอยู่แล้ว
รุ่น VCL และ LCL ที่กล่าวถึงในบทความนี้มาด้วยกันในชื่อ PDFium Component พร้อมซอร์สโค้ดและ public API ที่เหมือนกันทุกประการสำหรับ Delphi, C++Builder และ Lazarus/FPC