PDFium Component สามารถเปิด PDF ที่อยู่ภายใน buffer ที่ใหญ่กว่าได้โดยตรงจาก byte range overload LoadDocument(const Data: TBytes; Index, Count: Integer; Buffered: Boolean) ระบุตำแหน่งหน้าต่างข้อมูลในที่เดิม ดังนั้นจึงไม่ต้อง Copy ล่วงหน้า แลกกับการที่มันขอให้คุณเข้าใจกฎหนึ่งข้อ เมื่อ Buffered เป็น False array ที่รองรับข้อมูลจะถูกยืมมา ไม่ใช่ถูกคัดลอก
นี่เป็นกลไกที่ต่างจากแนวทางแบบ callback-driven ที่อธิบายไว้ใน streaming PDF ขนาดใหญ่แบบ on-demand ด้วย PDFium VCL ซึ่งส่งตัวอ่าน FPDF_FILEACCESS ให้ PDFium และให้มันดึงบล็อกข้อมูลจากดิสก์ตามที่ต้องการ อันนั้นสำหรับเอกสารที่ใหญ่เกินกว่าจะเก็บไว้ใน RAM ได้ทั้งหมด อันนี้สำหรับเอกสารที่อยู่ใน RAM แล้ว วางอยู่ที่ offset ที่รู้ค่าภายในอะไรอย่างอื่น ทั้งสองเสริมกัน และหัวข้อสุดท้ายจะอธิบายว่าสถานการณ์ไหนเหมาะกับอะไร
การคัดลอก 40 MB ที่ไม่มีใครขอ
สถานการณ์นี้ปรากฏทุกที่ที่ PDF เดินทางอยู่ภายในรูปแบบอื่น mail store เก็บเนื้อความข้อความและไฟล์แนบไว้ใน record เดียว archive container ต่อ manifest, รูปภาพสองสามรูป และ PDF เข้าด้วยกัน wire protocol แบบกำหนดเองใส่กรอบเอกสารด้วย header ที่มี length นำหน้า ทุกกรณีคุณจะจบลงด้วยการถือ TBytes ขนาดใหญ่หนึ่งตัว และรู้ว่า PDF เริ่มที่ byte 1,182,336 และยาว 312 กิโลไบต์
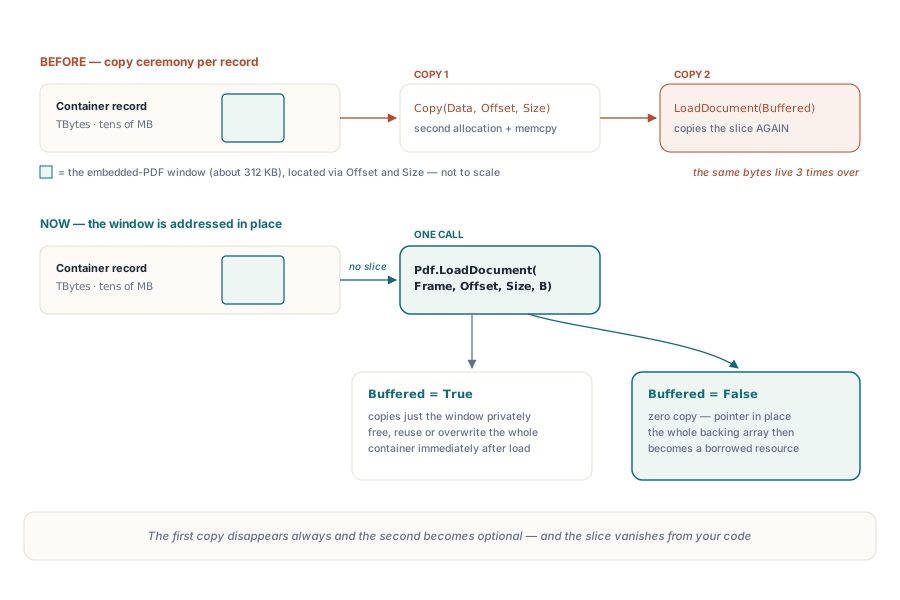
ก่อนที่ byte range overload จะมีอยู่ คำตอบที่เป็นสำนวนคือ Copy(Data, Index, Count) ซึ่ง allocate array ที่สองและ memcpy หน้าต่างเข้าไปในนั้น แล้วคุณส่ง slice นั้นให้ LoadDocument ด้วย Buffered = True ซึ่งคัดลอกมันอีกครั้งเข้าไปใน buffer ส่วนตัวของ component สำเนาของไบต์เดียวกันสองชุด ชุดหนึ่งเป็นแค่พิธีการ และในการสแกน mailbox ขนาดใหญ่ก็ทำซ้ำสำหรับทุกข้อความ byte range overload กำจัดการคัดลอกครั้งแรกออกไปเสมอ และครั้งที่สองแบบเลือกได้
Byte range overload ทำอะไรจริง ๆ
overload นี้บางโดยการออกแบบ มันตรวจสอบ คำนวณ pointer เดียว แล้วส่งต่อให้กับรูปแบบ pointer ของ LoadDocument ที่ทั้งตระกูลไหลผ่านอยู่แล้ว Index เริ่มที่ศูนย์ Count คือความยาวไบต์ และ Buffered มีค่าเริ่มต้นเป็น True เหมือนกับ overload อื่น ๆ ทุกประการ LoadDocument(const Data: TBytes; Buffered: Boolean) แบบอาร์กิวเมนต์เดียวเองก็เป็นแค่การเรียกตัวนี้ด้วย Index = 0 และ Count = Length(Data) ดังนั้นจึงมีเส้นทางตรวจสอบเดียวแทนที่จะเป็นสอง
การเรียกใช้งานมันดูเหมือนโค้ดที่คุณเขียนอยู่แล้ว ลบส่วน slice ออก
var
  Frame: TBytes;          // เรกคอร์ดคอนเทนเนอร์ทั้งหมด, หลายสิบเมกะไบต์
  Offset, Size: Integer;
begin
  Frame := LoadContainerRecord('mailbox.dat');
  LocateEmbeddedPdf(Frame, Offset, Size);   // พาร์เซอร์คอนเทนเนอร์ของคุณ

  // ตรงนี้ไม่ใช่ Copy(Frame, Offset, Size) - หน้าต่างถูกอ้างอิงในตำแหน่งเดิม
  Pdf.LoadDocument(Frame, Offset, Size, True);
  try
    RenderPreview(Pdf);
  finally
    Pdf.UnloadDocument;
  end;
end;
ทำไม Index บวก Count ถึงทำให้การตรวจสอบขอบเขต overflow
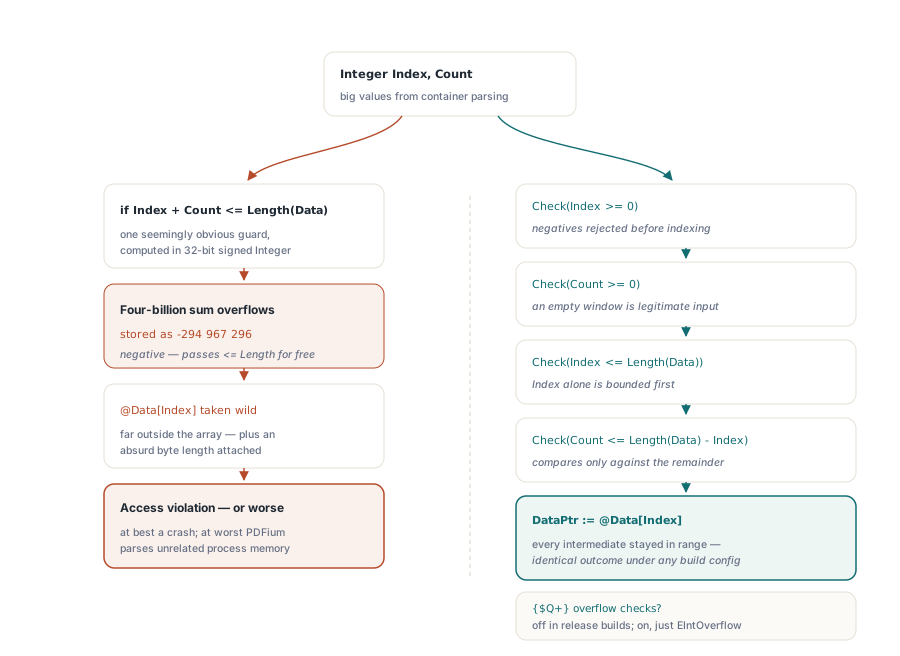
เพราะ Index และ Count ทั้งคู่เป็น Integer และผลรวมของค่า Integer บวกขนาดใหญ่สองค่าไม่จำเป็นต้องเป็น Integer บวกขนาดใหญ่เสมอไป นี่คือแก่นทางเทคนิคของ overload นี้ และเป็นจุดเดียวที่การตรวจสอบที่ดูเป็นธรรมชาติกลายเป็นช่องโหว่ด้านความปลอดภัยหน่วยความจำ รูปแบบที่ดูตรงไปตรงมาที่สุดกลับผิด
// ผิด: Index + Count ถูกคำนวณใน Integer และอาจวนเป็นค่าลบ
if Index + Count <= Length(Data) then
  DataPtr := @Data[Index];

// ถูกต้อง: ปฏิเสธเครื่องหมายก่อน, จากนั้นจำกัดแต่ละเทอมแยกกัน,
// โดยเลขคณิตเดียวที่ทำคือการลบที่ไม่สามารถวนได้
Check(Index >= 0,  'PDF byte range index cannot be negative');
Check(Count >= 0,  'PDF byte range count cannot be negative');
Check(Index <= Length(Data), 'PDF byte range index exceeds data length');
Check(Count <= Length(Data) - Index, 'PDF byte range exceeds data length');
ไล่กรณีที่ล้มเหลวดู ลองเอา Index = 2000000000 และ Count = 2000000000 ผลรวมจริงของมันคือสี่พันล้าน แต่ในเลขคณิต 32-bit แบบมีเครื่องหมาย ผลลัพธ์จะวนกลับเป็นลบ 294,967,296 พอดี ค่านั้นน้อยกว่า Length(Data) อย่างสบาย ๆ ดังนั้นการตรวจสอบที่ผิดจึงผ่าน @Data[Index] ถูกนำมาไกลนอก array มาก และ PDFium ได้รับ pointer เพี้ยนพร้อมความยาวสองกิกะไบต์ สิ่งที่ตามมาคือ access violation ในวันที่ดี และการ parse หน่วยความจำ process ที่ไม่เกี่ยวข้องอย่างเงียบ ๆ ในวันที่แย่
ลำดับที่ถูกต้องแก้ปัญหานี้ด้วยการไม่มีการบวกเลย ค่าลบจะถูกปฏิเสธก่อนที่จะมีการทำดัชนีใด ๆ ดังนั้น @Data[Index] จึงไม่มีวันถูกนำมาต่ำกว่า array เลย จากนั้น Index จะถูกจำกัดของมันเองเทียบกับ Length(Data) ซึ่งรับประกันว่า Length(Data) - Index เป็น Integer ที่ไม่ติดลบ จากนั้น Count จะถูกเปรียบเทียบกับส่วนที่เหลือนั้นเท่านั้น ทุกค่าระหว่างกลางยังคงอยู่ในช่วงที่แสดงผลได้ ดังนั้นไม่มี build configuration ใดที่จะเปลี่ยนผลลัพธ์ได้ อย่าถูกล่อใจให้พึ่งพา {$Q+} overflow checking เป็นตาข่ายนิรภัยเช่นกัน release build มักจะปิดมันไว้เป็นประจำ และแม้ตอนเปิดอยู่ คุณก็แค่เปลี่ยนบั๊กด้านความปลอดภัยหน่วยความจำให้เป็น EIntOverflow ที่หลุดออกมาจากกลางฟังก์ชันตรวจสอบ PDFium Component ปฏิบัติต่อเลขคณิตความยาวที่ไม่น่าเชื่อถือเหมือนกับส่วนที่เหลือของขอบเขตของมัน วินัยนี้ครอบคลุมกว้างขึ้นใน การเสริมความแข็งแกร่งให้ PDFium VCL ABI และความปลอดภัยหน่วยความจำใน Delphi
ทำไมหน้าต่างความยาวศูนย์ต้องส่ง nil
เพราะ @Data[Index] ไม่ใช่ expression ที่ถูกต้องสำหรับทุก Index ที่การตรวจสอบยอมรับ Index = Length(Data) กับ Count = 0 เป็นหน้าต่างว่างที่ถูกต้องสมบูรณ์ที่ท้าย buffer และ TBytes ที่ว่างเปล่าให้ Index = 0 บน array ที่ไม่มี element ที่ศูนย์เลย การนำ address ในกรณีใดกรณีหนึ่งจะทำดัชนีเลยจุดจบ หรือ dereference dynamic array ที่เป็น nil ดังนั้น overload จึงแตกสาขา Count = 0 ให้ nil pointer อย่างอื่นให้ @Data[Index] nil นั้นจะไหลเข้าไปใน pointer overload ซึ่ง guard ของมันเองยอมรับ nil pointer เมื่อขนาดเป็นศูนย์ และการโหลดจะจบลงด้วย error "Cannot load PDF document" ทั่วไปแทนที่จะเป็น access violation caller ที่คำนวณหน้าต่างศูนย์ไบต์จาก container ที่ผิดรูปแบบจะได้ EPdfError ที่สะอาดและดักได้เหมือนข้อมูลนำเข้าที่ผิดปกติอื่น ๆ
ยืมหรือคัดลอก: Buffered ตัดสินอะไร
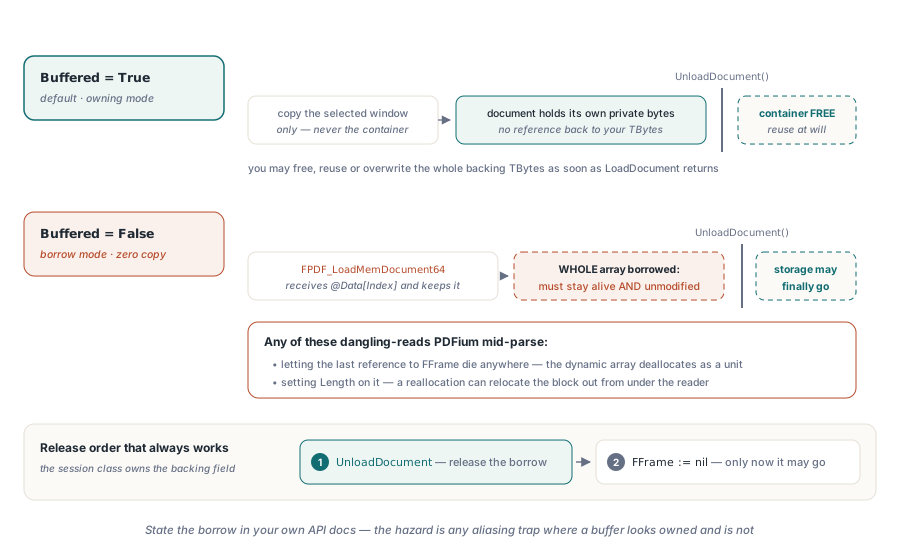
Buffered เลือกสัญญาความเป็นเจ้าของ และมันเป็นพารามิเตอร์เดียวตรงนี้ที่มีผลกระทบเกินกว่าการเรียก เมื่อ Buffered = True PDFium Component คัดลอกหน้าต่างที่เลือกไว้ และแค่หน้าต่างเดียว เข้าไปใน buffer ภายในของมันก่อนโหลด container ขนาด 40 MB จะไม่ถูกคัดลอก PDF ขนาด 312 KB ถูกคัดลอก เมื่อ LoadDocument คืนค่าแล้ว คุณสามารถปล่อย ใช้ซ้ำ หรือเขียนทับ container ได้ทันที เพราะ component ไม่อ้างอิงมันอีกแล้ว นี่คือค่าเริ่มต้นและเป็นตัวเลือกที่ถูกต้องสำหรับโค้ดเกือบทั้งหมด
Buffered = False ส่ง @Data[Index] ตรงเข้าไปยัง FPDF_LoadMemDocument64 และ PDFium จะเก็บ pointer นั้นไว้ตลอดอายุของเอกสารแทนที่จะคัดลอกไบต์ นั่นทำให้การโหลดปราศจาก allocation และทำให้ TBytes ที่รองรับข้อมูลทั้งตัวเป็น resource ที่ถูกยืม มันต้องคงอยู่และไม่ถูกแก้ไขจนกว่า UnloadDocument จะรันหรือ Active เป็น False ไม่ใช่แค่หน้าต่าง แต่ทั้ง array dynamic array นับ reference count เป็นหน่วยเดียว และการปล่อย reference สุดท้ายไม่ว่าที่ไหนในโค้ดของคุณจะปลดปล่อยหน่วยความจำที่ PDFium ยังคงอ่านอยู่ การตั้ง Length บนมันก็อันตรายพอ ๆ กัน เพราะการ reallocate อาจทำให้ block ย้ายที่ ควรระบุเรื่องนี้ในเอกสาร API ของคุณเองทุกที่ที่คุณเปิดให้โหลดแบบนี้ ในจิตวิญญาณเดียวกับขอบเขตยืม-กับ-เป็นเจ้าของอื่นใดใน Pascal code รูปแบบความล้มเหลวเหมือนกับ aliasing hazard ที่อธิบายไว้ใน FillChar และ result string leak ใน Delphi ที่ buffer ดูเหมือนเป็นเจ้าของแต่ไม่ใช่
type
  TFrameSession = class
  private
    FFrame: TBytes;   // เป็นเจ้าของหน่วยความจำรองตราบเท่าที่ FPdf ยังโหลดอยู่
    FPdf: TPdf;
  public
    procedure OpenEmbedded(Offset, Size: Integer);
    destructor Destroy; override;
  end;

procedure TFrameSession.OpenEmbedded(Offset, Size: Integer);
begin
  // Buffered = False: FFrame ต้องอยู่ได้นานกว่าเอกสารที่โหลด
  FPdf.LoadDocument(FFrame, Offset, Size, False);
end;

destructor TFrameSession.Destroy;
begin
  FPdf.UnloadDocument;   // ปล่อยการยืมก่อน
  FFrame := nil;         // ถึงตอนนี้หน่วยความจำจึงจะไปได้
  inherited;
end;
เมื่อ byte range window เป็นเครื่องมือที่ผิด
ควรตรงไปตรงมาเกี่ยวกับขอบเขต byte range overload สันนิษฐานว่า container อยู่ในหน่วยความจำทั้งหมดอยู่แล้ว และ Count เป็น Integer ดังนั้นหน้าต่างเดียวจึงเกินสองกิกะไบต์ไม่ได้ ถ้า container เป็น archive ขนาด 6 GB บนดิสก์ หรือมาจาก socket ที่คุณ rewind ไม่ได้ overload นี้ช่วยคุณไม่ได้ และการอ่านทั้งหมดเข้าไปใน TBytes แค่เพื่อระบุตำแหน่งหน้าต่างภายในมันก็เอาชนะจุดประสงค์ไปเลย ตรงนั้นแหละที่ path FPDF_FILEACCESS เป็นของมัน และ บทความ streaming แบบ on-demand แสดงวิธีเปิดเผยมุมมองแบบเลื่อน offset ของไฟล์เป็น document source แบบกำหนดเอง เช่นเดียวกัน ถ้าไบต์ที่ฝังอยู่ต้องผ่านการแปลงก่อนที่ PDFium จะเห็น เช่น การคลายบีบอัด การถอดรหัส ขั้นตอนการแกะ ก็จำเป็นต้องมีการคัดลอกจริงและ Buffered = True บน array ที่แปลงแล้วเป็นคำตอบที่ตรงไปตรงมา byte range window ให้ผลตอบแทนในรูปแบบเดียวเท่านั้น คือไบต์ PDF ที่ต่อเนื่องกัน ไม่ถูกแก้ไข อยู่ในหน่วยความจำแล้ว ที่ offset ที่รู้ค่า
ถ้าคุณกำลังประเมินสิ่งนี้สำหรับ viewer, preview pane หรือ batch intake pipeline byte range overload และ streaming loader คือสองในกลยุทธ์การโหลดที่ PDFium Component มีมาพร้อมกับการโหลดแบบไฟล์, stream และ raw pointer API surface ฉบับเต็ม การอนุญาตใช้งาน และการรองรับเวอร์ชัน Delphi กับ C++Builder มีเอกสารอยู่ที่ หน้าผลิตภัณฑ์ PDFium Component