HotPDF สามารถเรนเดอร์หน้าเอกสาร PDF ที่โหลดขึ้นมาให้กลายเป็น Delphi TBitmap ได้ผ่านการเรียกใช้ฟังก์ชันเพียงครั้งเดียว: RenderLoadedPageToBitmap(PageIndex, DPI) ฟังก์ชันนี้จะตีความสตรีมเนื้อหาของหน้าเอกสารและส่งกลับบิตแมป RGB ขนาด 24 บิตที่ผู้เรียกใช้เป็นเจ้าของตามความละเอียดที่คุณเลือก ซึ่งเป็นสิ่งที่แถบภาพขนาดย่อ (thumbnail strip) ภาพตัวอย่างการพิมพ์ หรือไพป์ไลน์การส่งออก PDF เป็นรูปภาพต้องการอย่างแท้จริง บทความนี้จะนำคุณไปศึกษาการใช้งาน API นี้ จากนั้นจะพาไปดูส่วนที่แยกความแตกต่างระหว่างตัวเรนเดอร์ที่ใช้งานได้จริงกับโปรแกรมระดับของเล่น: นั่นคือการวาดข้อความจากโปรแกรมฟอนต์ที่ฝังอยู่จริง แทนที่จะเป็นฟอนต์ระบบที่มีลักษณะคล้ายกัน
ทำไมการเรนเดอร์หน้า PDF จึงยากกว่าการวาดรูปภาพทั่วไป?
หน้ากระดาษ PDF ไม่ใช่รูปภาพทั่วไป แต่มันคือโปรแกรมคอมพิวเตอร์: สตรีมของตัวดำเนินการที่สร้างเส้นทางเลือกฟอนต์ กำหนดสี และจัดวาง glyph ซึ่งจะถูกประมวลผลเทียบกับโมเดลกราฟิกที่กำหนดไว้ในมาตรฐาน ISO 32000-1 §8 ไม่มีข้อมูลส่วนใดในไฟล์ที่บอกตรงๆ ว่าแต่ละพิกเซลมีลักษณะอย่างไร การสร้างบิตแมปขึ้นมาคุณจึงต้องรันโปรแกรมดังกล่าว — โดยดูแลรักษาเมทริกซ์การแปลงค่าปัจจุบัน สแต็กสถานะกราฟิกสำหรับคำสั่ง q/Q เส้นทางการตัดข้อมูล (clipping path) พื้นที่สีพื้นหลังและสีเส้นขอบ — และแปลงผลลัพธ์เป็นภาพราสเตอร์ นั่นจึงเป็นเหตุผลว่าทำไมคำขอ "แค่แสดงหน้า 3 เป็นรูปภาพ" จึงต้องใช้ตัวตีความสตรีมเนื้อหา ไม่ใช่เรื่องของการแปลงรูปแบบไฟล์ธรรมดา
ตัวเรนเดอร์ของ HotPDF ซึ่งเปิดตัวในเวอร์ชัน v2.253.0 ได้รับการสร้างขึ้นโดยแยกหน่วยทำงานหกส่วนที่เลียนแบบโมเดลดังกล่าว: คอร์เมทริกซ์การแปลงค่าเรขาคณิต (affine matrix) สำหรับพีชคณิตการแปลง PDF [a b c d e f], สแต็กสถานะกราฟิก, ตัววิเคราะห์พื้นที่สี (DeviceRGB, DeviceGray, DeviceCMYK, Indexed), ตัวสร้างเส้นทางที่เชื่อมโยงตัวดำเนินการเส้นทาง PDF เข้ากับ GDI, เลเยอร์เมทริกซ์ฟอนต์ที่อ่านอาร์เรย์ /Widths เพื่อให้ขยับตำแหน่งได้ถูกต้อง และตัวแปลภาษาที่ทำหน้าที่กระจายตัวดำเนินการและขับเคลื่อนส่วนอื่นๆ ทั้งห้าส่วน วัตถุรูปภาพ XObjects จะผ่านสแต็กการถอดรหัสเดียวกับที่ไลบรารีใช้สำหรับการแยกข้อมูล ดังนั้นตัวกรองรูปภาพทุกตัวที่ HotPDF สามารถถอดรหัสเพื่อแยกข้อมูลได้ — รวมถึงรูปภาพ JPEG 2000 ที่บีบอัดด้วย JPXDecode — จะปรากฏในภาพผลลัพธ์ที่เรนเดอร์ออกมาเช่นกัน
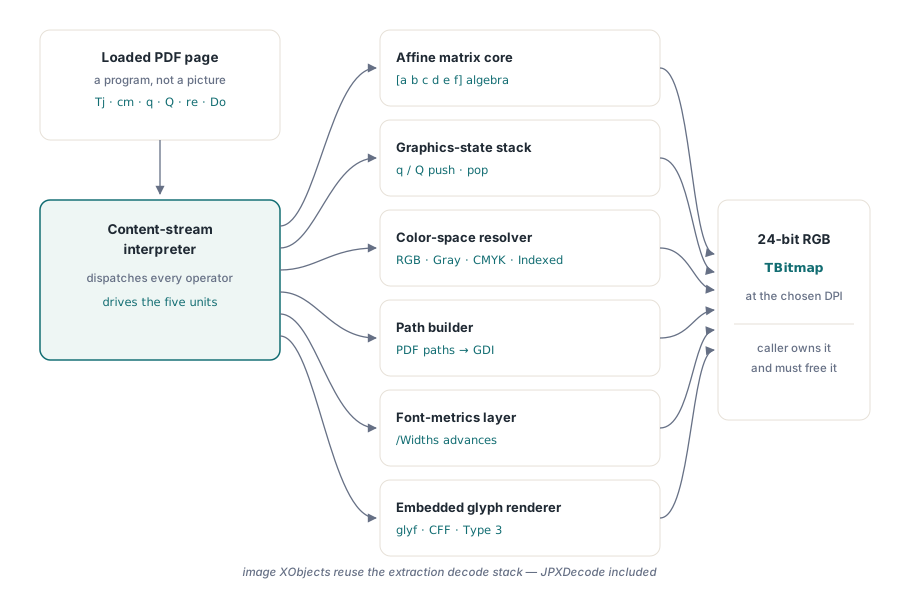
การเรนเดอร์หน้าเอกสารที่โหลดขึ้นมาเป็น TBitmap
ฟังก์ชัน RenderLoadedPageToBitmap จะรับค่าดัชนีหน้ากระดาษที่เริ่มจากศูนย์และค่า DPI โดยที่ความละเอียด 72 DPI จะจับคู่หนึ่งหน่วยพื้นที่ผู้ใช้ PDF เข้ากับหนึ่งพิกเซล ฟังก์ชันจะส่งกลับค่า nil เมื่อเกิดความล้มเหลว (เช่น ดัชนีอยู่นอกช่วง หรือขาดแคลนทรัพยากร) แทนการแจ้งข้อผิดพลาด เพื่อให้โปรแกรมดูสามารถข้ามหน้าที่มีปัญหาและทำงานต่อไปได้ ผู้เรียกใช้จะเป็นเจ้าของบิตแมปที่ส่งกลับมาและต้องมีหน้าที่ทำลาย (free) มันเมื่อใช้เสร็จ
var
  Pdf: THotPDF;
  Bmp: TBitmap;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('report.pdf') > 0 then
    begin
      Bmp := Pdf.RenderLoadedPageToBitmap(0, 144);  // หน้า 1 ที่ความละเอียด 144 DPI
      if Bmp <> nil then
      try
        Image1.Picture.Assign(Bmp);
      finally
        Bmp.Free;  // ผู้เรียกใช้เป็นเจ้าของบิตแมป
      end;
    end;
  finally
    Pdf.Free;
  end;
end;
อาร์กิวเมนต์ DPI ทำหน้าที่ปรับขนาดสำหรับการใช้งานทั่วไปทุกสถานการณ์ แถบภาพขนาดย่อจะเรนเดอร์ที่ 36 หรือ 48 DPI และได้บิตแมปขนาดเล็กที่สร้างได้อย่างรวดเร็ว ภาพตัวอย่างบนหน้าจอที่ 96 หรือ 144 DPI จะตรงกับความหนาแน่นของจอแสดงผลทั่วไป ส่วนการส่งออกภาพที่ 300 DPI จะได้รูปภาพที่มีคุณภาพเหมาะสมกับการสั่งพิมพ์ การหมุนหน้ากระดาษที่ระบุจาก /Rotate และการสลับจุดเริ่มต้นแกนของ /MediaBox (PDF กำหนดจุดเริ่มต้นไว้ที่มุมซ้ายล่าง ส่วน GDI อยู่ที่มุมซ้ายบน) จะได้รับการจัดการภายในเมทริกซ์การแปลงจากหน้ากระดาษไปยังอุปกรณ์ ดังนั้นหน้ากระดาษขนาด US Letter ที่ 72 DPI จะส่งกลับมาเป็นภาพขนาด 612×792 พิกเซลในทิศทางที่ถูกต้องอย่างพอดิบพอดี
ทำไมภาพขนาดย่อ PDF ที่เรนเดอร์จึงแสดง glyph ผิดเพี้ยน?
รูปทรง glyph ที่ผิดหรือเป็นเพียงการประมาณในผลลัพธ์ PDF ที่เรนเดอร์ออกมานั้น เกือบทั้งหมดเกิดจากการที่ตัวเรนเดอร์นำฟอนต์ระบบมาใช้แทนที่การดึงฟอนต์ที่ฝังอยู่ในไฟล์มาใช้งาน ตัวเรนเดอร์ของ HotPDF เวอร์ชันแรกก็ทำพฤติกรรมดังกล่าว: โดยจะตัดคำนำหน้า subset ออกจาก /BaseFont (เปลี่ยนจาก ABCDEF+Arial เป็น Arial) จากนั้นขอให้ GDI เรียกฟอนต์ระบบตามชื่อนั้น และนำมาใช้วาดข้อความ สำหรับเอกสารที่ใช้ Arial หรือ Times New Roman ร่วมกับการเข้ารหัสมาตรฐาน ผลลัพธ์อาจจะดูใกล้เคียงกัน แต่นั่นเป็นเพียงการประมาณ และจะแสดงจุดบกพร่องออกมาอย่างเห็นได้ชัดในบางกรณี
ฟอนต์ที่ฝังตัวแบบ subset คือกรณีที่แย่ที่สุด ฟอนต์ชุดย่อยอาจเก็บเฉพาะ glyph เพียงสี่สิบตัวที่เอกสารใช้งานจริง โดยกำหนดรหัสอักขระเรียงตามลำดับเฉพาะตัวสำหรับไฟล์นั้น — รหัส 1 อาจเป็น "T" รหัส 2 อาจเป็น "h" ไปเรื่อยๆ ฟอนต์ระบบไม่มีทางรู้เกี่ยวกับการกำหนดค่าเฉพาะนั้นเลย ดังนั้นข้อความจึงอาจจะหายไปหรือแสดงผลออกมาเป็นตัวอักษรอื่นที่ผิดพลาดโดยสิ้นเชิง การเข้ารหัสแบบกำหนดเอง ฟอนต์สัญลักษณ์ ฟอนต์บาร์โค้ด หรือฟอนต์ใดๆ ที่ไม่ได้ติดตั้งบนเครื่องที่กำลังเรนเดอร์จะล้มเหลวในลักษณะเดียวกัน ตัวเรนเดอร์ที่หยุดอยู่แค่การทดแทนฟอนต์ระบบจะสร้างภาพขนาดย่อที่พอมองออกว่าเป็นรูปของหน้ากระดาษ — จนกระทั่งหน้านั้นเริ่มหันไปใช้งานฟอนต์ที่เป็นเหตุผลสำคัญที่ทำให้จำเป็นต้องฝังฟอนต์ตั้งแต่แรก
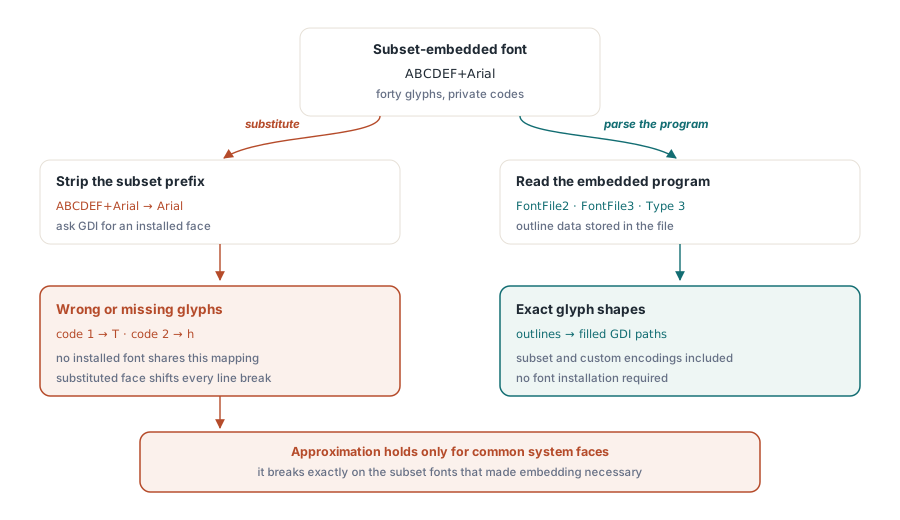
การเรนเดอร์ glyph แบบฝังตัว: การวาดจากโปรแกรมฟอนต์โดยตรง
HotPDF ได้แก้ไขปัญหานี้ในช่วงการอัปเดตห้าเวอร์ชัน (v2.268.0 ถึง v2.272.0) โดยการวิเคราะห์โปรแกรมฟอนต์ที่ฝังมาและนำโครงร่าง glyph มาวาดเป็นเส้นทางเวกเตอร์ GDI แบบถมสี ข้อความในหน้าที่เรนเดอร์ออกมาในขณะนี้จึงมาจากข้อมูลโครงร่างชุดเดียวกับที่โปรแกรมอ่านเอกสารมาตรฐานใช้ ซึ่งหมายความว่าฟอนต์ชุดย่อย การเข้ารหัสแบบกำหนดเอง และฟอนต์ที่ไม่ได้ติดตั้งจะสามารถเรนเดอร์ได้ตรงตามรูปทรงที่แท้จริง โดยระบบจะครอบคลุมตามประเภทของฟอนต์ดังนี้:
สำหรับฟอนต์ Type0/CIDFontType2 ที่มีโปรแกรม TrueType ฝังมา (FontFile2) ตัวเรนเดอร์จะวิเคราะห์ตาราง glyf และ loca โดยตรง: เส้นโค้งกำลังสอง (quadratic contour) จะถูกแปลงเป็นเส้นโค้งเบซิเยร์กำลังสาม (cubic Bézier) ที่ GDI เข้าใจ มีการสร้างจุดบนเส้นโค้งเสมือนขึ้นมาระหว่างจุดนอกเส้นโค้งที่อยู่ติดกัน และ glyph คอมโพสิตจะถูกนำกลับมาวาดใหม่แบบเรียกซ้ำ ระบบรองรับทั้งเค้าโครง Identity และสตรีม CIDToGIDMap แบบชัดแจ้ง และการเลื่อนตำแหน่งของ CID จะอิงตามความกว้าง /W และ /DW เพื่อให้ข้อความแบบ Identity-H ขนาดสองไบต์สามารถขยับตำแหน่งได้อย่างถูกต้อง
โปรแกรม CFF (FontFile3 ไม่ว่าจะเป็น CIDFontType0C, Type1C หรือ OpenType wrapper) จะได้รับตัวแปลสตริงอักขระ Type 2 แบบเต็มรูปแบบ: ทั้งเส้นตรง เส้นโค้ง flex family, hint mask และการเรียกใช้รูทีนย่อยภายในและส่วนกลางพร้อมค่าเบี่ยงเบนรูทีนย่อยที่ถูกต้อง โปรแกรม CFF แบบ CID-keyed จะจับคู่รหัสอักขระผ่านชุดอักขระของฟอนต์ ซึ่งมีประโยชน์สำหรับฟอนต์ชุดย่อยที่ลำดับของ glyph แตกต่างจากลำดับ CID และมีการปฏิบัติตามคำสั่งเลือก font-DICT ราย glyph ผ่าน FDArray/FDSelect ส่วนฟอนต์ TrueType แบบธรรมดา (ไม่ใช่ CID) จะแปลรหัสขนาดหนึ่งไบต์ผ่านตาราง cmap ของฟอนต์ที่ฝังมาด้วยห่วงโซ่ตารางย่อยที่มีประสิทธิภาพ — เริ่มจากรูปแบบ Unicode 4 และ 12 เป็นอันดับแรก ตามด้วยตารางย่อยสัญลักษณ์ที่มีการใช้ช่วงพื้นที่ส่วนตัว F000 และรูปแบบ Macintosh ดั้งเดิม ในขณะที่ฟอนต์ Type1 แบบธรรมดาจะแปลรหัสผ่านการเข้ารหัสในตัวของโปรแกรม CFF
การปรับแต่งสองส่วนนี้ช่วยให้ภาพรวมมีความสมบูรณ์ ประการแรก พจนานุกรม /Encoding ของฟอนต์แบบธรรมดาจะได้รับการแปลความหมายตามลำดับความสำคัญที่มาตรฐาน ISO 32000-1 §9.6.6 กำหนดไว้: อาร์เรย์ /Differences จะแทนที่การเข้ารหัสปฏิบัติการพื้นฐาน ซึ่งจะแทนที่แผนผังของโปรแกรมฟอนต์เองอีกทอดหนึ่ง — ซึ่งเป็นเส้นทางที่เครื่องมือที่พัฒนาต่อยอดจาก TeX และ PostScript พึ่งพาการใช้งาน โดยชื่อ glyph จะได้รับการแปลความหมายผ่าน Adobe Glyph List, ชุดอักขระ CFF หรือ cmap ของ TrueType ประการที่สอง ฟอนต์ Type3 ซึ่ง glyph ในตัวของมันเป็นสตรีมเนื้อหาขนาดเล็ก จะถูกนำกลับมาวาดใหม่ผ่านตัวเรนเดอร์ด้วยการประกอบเมทริกซ์ฟอนต์ ขนาดฟอนต์ และเมทริกซ์ข้อความเข้าด้วยกัน ค่าความกว้าง /Widths ของพื้นที่ glyph จะถูกตีความผ่าน /FontMatrix ตามที่ ISO 32000-1 §9.6.5 กำหนด และกระบวนการของ glyph ที่ระบุขอบเขต d1 จะถูกตัดสิทธิ์ให้อยู่ภายในขอบเขตนั้น เพื่อไม่ให้ glyph บาร์โค้ดที่ผิดรูปแบบสามารถวาดออกนอกพื้นที่เซลล์ของมันได้ เมื่อไม่สามารถจับคู่รหัสได้ — เช่น โปรแกรมชำรุด หรืออักขระที่ไม่มีการจับคู่ — ตัวเรนเดอร์จะย้อนกลับไปใช้วิธีการวาดด้วยฟอนต์ระบบสำหรับ glyph นั้น ดีกว่าการละทิ้งข้อความทั้งหมดไป
จะทำให้การเรนเดอร์ซ้ำๆ ทำงานได้เร็วได้อย่างไร?
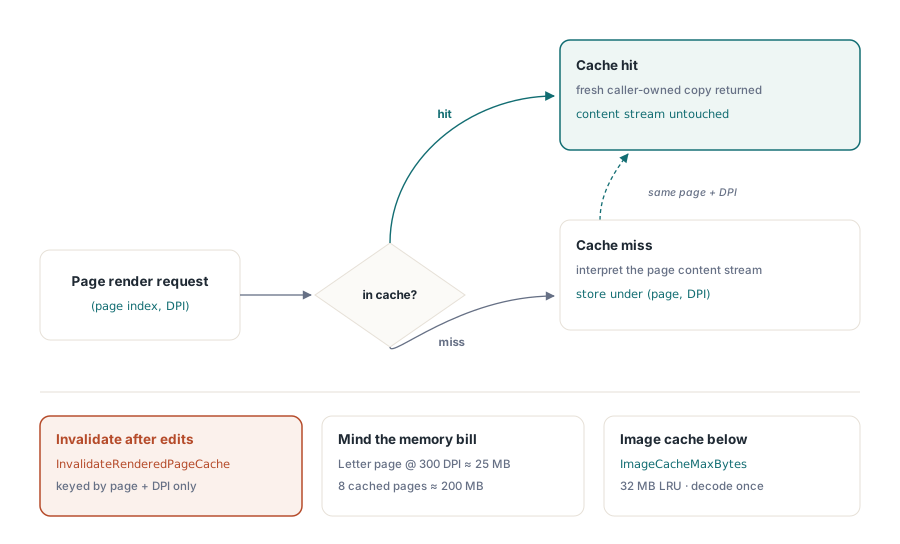
คำตอบที่มาพร้อมกับ HotPDF คือระบบแคชหน้ากระดาษที่เพิ่งใช้งานล่าสุด: RenderLoadedPageToBitmapCached จะเก็บหน้าเอกสารที่เรนเดอร์แล้วสูงสุดตามจำนวน RenderCacheCapacity (ค่าเริ่มต้นคือ 8 หน้า) โดยใช้ดัชนีหน้าและค่า DPI เป็นคีย์ และเมื่อการเรียกใช้งานตรงกับข้อมูลในแคช ระบบจะส่งกลับสำเนาใหม่ที่ผู้เรียกใช้เป็นเจ้าของโดยไม่ต้องไปยุ่งเกี่ยวกับสตรีมเนื้อหา — ซึ่งโดยปกติจะเร็วกว่าการแปลความหมายหน้ากระดาษใหม่ถึงหลายพันเท่า รูปแบบนี้จึงเหมาะอย่างยิ่งสำหรับโปรแกรมดูเอกสาร: ผู้ใช้ที่สลับหน้าไปมาระหว่างสองหน้า หรือเหตุการณ์การปรับขนาดหน้าต่างที่ต้องขอหน้าเดิมที่ความละเอียด DPI เดิมซ้ำอีกครั้ง จะสามารถดึงข้อมูลจากแคชมาใช้ได้ในทันที
// แถบภาพขนาดย่อ: การรันครั้งแรกจะเรนเดอร์ การเลื่อนกลับมาจะดึงข้อมูลจากแคช
for I := 0 to ThumbCount - 1 do
begin
  Bmp := Pdf.RenderLoadedPageToBitmapCached(I, 48);
  if Bmp <> nil then
  try
    ThumbList.AddThumbnail(I, Bmp);
  finally
    Bmp.Free;
  end;
end;

// หลังจากแก้ไขหน้าเอกสารที่โหลดขึ้นมาในตำแหน่งเดิม:
Pdf.InvalidateRenderedPageCache;  // การเรนเดอร์ครั้งถัดไปจะสะท้อนการเปลี่ยนแปลง
โปรดคำนึงถึงภาระของหน่วยความจำก่อนที่จะปรับเพิ่มขนาดความจุของแคช หน้ากระดาษขนาด US Letter ที่ความละเอียด 300 DPI จะมีขนาด 2550×3300 พิกเซล ซึ่งคิดเป็นขนาดข้อมูลประมาณ 25 MB สำหรับบิตแมปขนาด 24 บิต ดังนั้นแคชจำนวนแปดหน้าที่ความละเอียดสำหรับการส่งออกจะใช้พื้นที่ประมาณ 200 MB ในทางกลับกัน ที่ความละเอียดระดับภาพขนาดย่อ แคชจำนวนแปดรายการเดียวกันนี้จะใช้พื้นที่ไม่ถึงเมกะไบต์ ให้กำหนดขนาด RenderCacheCapacity ให้สอดคล้องกับ DPI ที่คุณใช้แคชจริง และเรียกใช้ InvalidateRenderedPageCache หลังจากการแก้ไขไฟล์ในตำแหน่งเดิม — เนื่องจากแคชจะอ้างอิงตามดัชนีหน้าเอกสารและค่า DPI เท่านั้น และไม่สามารถรับรู้ได้ว่าเนื้อหาเบื้องหลังถูกแก้ไขไป การโหลดเอกสารใหม่จะล้างแคชนี้โดยอัตโนมัติ
แคชตัวที่สองจะทำงานอยู่ใต้แคชหน้าเอกสาร: วัตถุรูปภาพที่ถอดรหัสแล้ว (image XObjects) จะถูกเก็บไว้ในพื้นที่จัดเก็บที่จำกัดงบประมาณไบต์โดย ImageCacheMaxBytes (ค่าเริ่มต้นคือ 32 MB) พร้อมระบบขจัดข้อมูลที่เก่าที่สุด (least-recently-used eviction) ภาพโลโก้หรือหัวจดหมายที่ซ้ำกันในทุกๆ หน้าจะถูกถอดรหัสเพียงครั้งเดียวต่อการโหลดเอกสาร แทนที่จะถอดรหัสทุกครั้งที่พบคำสั่ง Do ซึ่งช่วยลดเวลาการเรนเดอร์สำหรับหน้าที่มีรูปภาพร่วมกันลงประมาณครึ่งหนึ่ง และเพิ่มความเร็วในการส่งออกภาพ TIFF หลายหน้าในระดับเดียวกัน การเรียกใช้ InvalidateRenderedPageCache จะล้างแคชนี้ด้วยเช่นกัน
สิ่งที่ยังคงเรนเดอร์เป็นแบบประมาณ
ตัวเรนเดอร์นี้มุ่งเป้าไปที่ชุดย่อยของเอกสาร PDF ทั่วไป และคุ้มค่าที่จะเรียนรู้ว่าขอบเขตของมันอยู่จุดใด พื้นที่สีแบบ CalRGB, Lab และแบบอิงตามโปรไฟล์ ICC จะถูกประมวลผลเป็นแบบประมาณแทนการจัดการสีอย่างเป็นระบบ — ส่วนพื้นที่สีของอุปกรณ์ จานสี Indexed และการค้นหาค่าสีของฟังก์ชัน Type 0 ที่สุ่มตัวอย่างไว้ จะได้รับการจัดการตามปกติ แต่ไฟล์สำหรับขั้นตอนการจัดพิมพ์ที่ต้องพึ่งพาเป้าหมายการเรนเดอร์ของ ICC อาจไม่ได้ค่าสีที่ถูกต้องตรงตามหลักการวัดสี รูปแบบการไล่โทนสี (sh) และโหมดการผสมสี (blend mode) ที่ซับซ้อนกว่าค่าอัลฟ่าธรรมดายังอยู่นอกเหนือขอบเขตการทำงาน และการเรียกซ้ำ of Form XObject จะถูกจำกัดระดับความลึกเพื่อป้องกันการเกิดลูป สำหรับใบแจ้งหนี้ รายงาน สัญญา และแบบฟอร์ม — หน้าเอกสารที่ประกอบด้วยข้อความ เส้นทาง และรูปภาพ — ผลลัพธ์ที่ได้จะมีความถูกต้องครบถ้วน แต่สำหรับแบบร่างการออกแบบที่เต็มไปด้วยการไล่ระดับสีและกลุ่มโปร่งใส ให้ถือว่าบิตแมปเป็นเพียงภาพตัวอย่างเท่านั้น ไม่ใช่ภาพพิมพ์จริง
การสรุปการใช้งานจริง: หากไพป์ไลน์ของคุณสร้างเอกสารด้วย HotPDF หรือประมวลผล PDF ทางธุรกิจทั่วไป ฟังก์ชัน RenderLoadedPageToBitmap จะส่งมอบผลลัพธ์ที่มีรูปทรง glyph แบบเดียวกับที่ฝังตัวมา มีการขยับตำแหน่ง CID ที่ถูกต้อง และขนาดหน้าเอกสารที่สมบูรณ์ การแปลงแบบประมาณจะเกิดขึ้นเฉพาะในมุมของโมเดลกราฟิกที่เอกสารทางธุรกิจทั่วไปไม่ค่อยได้ใช้งาน
ฟังก์ชัน RenderLoadedPageToBitmap ฟังก์ชันย่อยแบบดึงข้อมูลจากแคช และไพป์ไลน์การเรนเดอร์โครงร่าง glyph แบบฝังตัวที่อธิบายไว้ในบทความนี้ ทั้งหมดจัดส่งมาในชุดของ HotPDF Delphi Component สำหรับ Delphi และ C++Builder — ซึ่งเป็นไลบรารี VCL แบบเนทีฟที่ไม่จำเป็นต้องพึ่งพา DLLs ภายนอก โดยครอบคลุมกระบวนการสร้าง การแก้ไข การแยกข้อความ และการเรนเดอร์หน้ากระดาษ PDF ไว้ในแพ็กเกจเดียว