HotPDF Delphi Component ลบหน้าออกจาก PDF ที่โหลดมาผ่าน THotPDF.DeletePage และตั้งแต่เวอร์ชัน 2.751.0 call นี้ยังตัด reference ระดับเอกสารทุกตัวที่ยังชี้มาที่หน้าออกด้วย: named destination ในต้นไม้ /Names /Dests, dictionary /Dests แบบเก่าใน catalog, action /GoTo ของ bookmark, structure element ใต้ /StructTreeRoot, ParentTree, entry OBJR ของ annotation และ link annotation บนหน้าที่เหลือ page tree ถูกสร้างใหม่เป็นขั้นสุดท้าย หลังจากไม่มีอะไรอื่นเอื้อมถึง object ที่ถูกลบได้แล้ว
ความล้มเหลวที่มันกันไว้ reproduce ง่ายและวินิจฉัยยาก ลบหน้าปกของรายงานที่มี tag เซฟ แล้วเปิดผลลัพธ์: Acrobat แสดงจำนวนหน้าถูกต้อง แต่ bookmark สารบัญลงไปไม่ถึงไหนแล้ว ตัวตรวจ accessibility รายงาน structure element ที่ไม่มีหน้า และ validator แบบเข้มลิสต์การอ้างถึง object ที่ถูก free ไม่มีอะไรผิดใน page tree ปัญหาคือหน้า PDF ไม่ได้เป็นแค่ใบของ /Pages มันเป็นเป้าหมายที่ครึ่งหนึ่งของ catalog ชี้มาที่ และการเอาใบออกก็ทิ้ง pointer เหล่านั้นให้ค้างทั้งหมด
ทำไมแค่เอาหน้าออกจาก /Kids ถึงไม่พอ
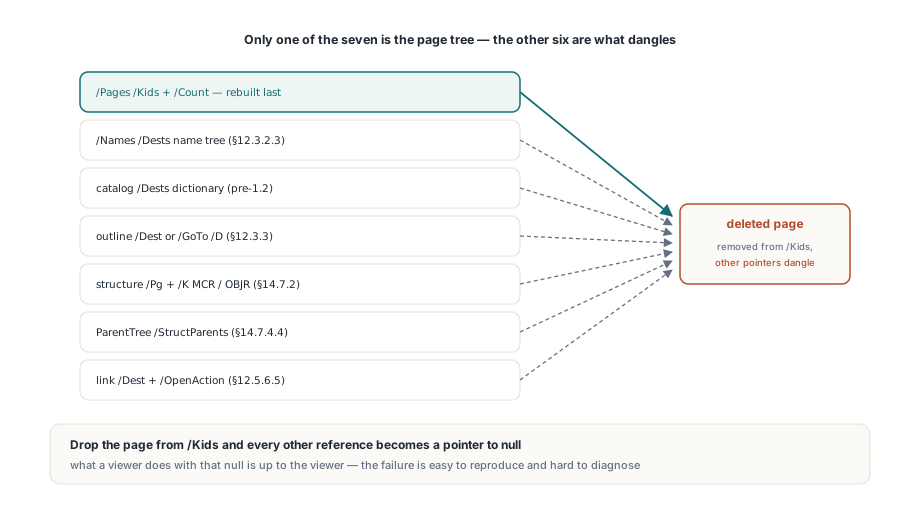
เพราะ ISO 32000-1 ยอมให้อย่างน้อยเจ็ดโครงสร้างอิสระถือ reference ไปที่ object ของหน้า และมีแค่หนึ่งในนั้นที่เป็น page tree การเอา page ออกจาก /Kids แล้วลด /Count ลงหนึ่งทำให้ §7.7.3 พอใจ และ reference อื่นทุกตัวกลายเป็น pointer ไปยัง object ที่ถูก free ใน xref หรือไม่มีอยู่ในไฟล์ที่เขียนใหม่เลย viewer ที่เดินตาม pointer ตัวใดตัวหนึ่งจะได้ null และจะทำอะไรกับ null นั้นก็ขึ้นกับ viewer
- ต้นไม้ชื่อใต้
/Names/Dests(§7.7.4, §12.3.2.3) map ชื่อไปเป็น array ของ destination ที่สมาชิกตัวแรกคือหน้า - dictionary
/Destsแบบก่อน 1.2 ที่อยู่ใน catalog โดยตรงถือ array ชนิดเดียวกันโดยใช้ชื่อเป็นคีย์ - outline item (§12.3.3) ไปถึงหน้าได้ทั้งผ่าน
/Destที่ฝังมา หรือผ่าน action/Aที่มี/S /GoToกับ array/D - structure element (§14.7.2) พาคีย์
/Pgที่ระบุหน้าที่ marked content ของมันอยู่ และ kid/Kของมันอาจเป็น marked-content reference กับ object reference (§14.7.4.3) ที่ผูกกับหน้านั้น ParentTree(§14.7.4.4) map หมายเลข/StructParentsของหน้าและ annotation กลับไปเป็น structure element และ element หนึ่งอาจอยู่ที่นั่นโดยไม่โผล่บนห่วงโซ่/Kจาก root เลย- link annotation บนหน้าอื่น (§12.5.6.5) พา
/Destหรือ action/GoToที่เล็งมาที่หน้านั้น และ/OpenActionของ catalog ก็อาจทำแบบเดียวกัน
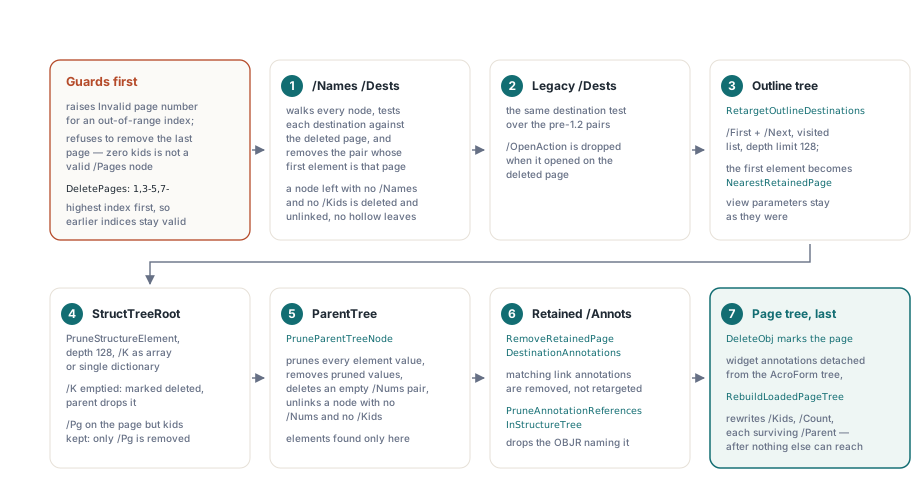
THotPDF.DeletePage ทำความสะอาดอะไรบ้างก่อนแตะ page tree
THotPDF.DeletePage(PageIndex) บนเอกสารที่โหลดมาเดินสำรวจ reference ทั้งหมดก่อน จากนั้นทำเครื่องหมายว่า object ของหน้าถูกลบด้วย DeleteObj ถอด widget annotation ออกจากต้นไม้ฟิลด์ของ AcroForm เลื่อน array ของหน้าในหน่วยความจำ แล้วสุดท้ายเรียก RebuildLoadedPageTree เพื่อเขียน /Kids, /Count และ /Parent ของทุกหน้าที่เหลือใหม่ การสำรวจไล่ catalog ตามลำดับตายตัว: ต้นไม้ชื่อ /Names /Dests, dictionary /Dests แบบเก่า, /OpenAction, ต้นไม้ outline, /StructTreeRoot พร้อม ParentTree ของมัน และสุดท้าย array /Annots ของทุกหน้าที่อยู่ แต่ละขั้นตัดสินว่า reference ควรถูกลบ เปลี่ยนเป้าหมาย หรือปล่อยไว้ ตามที่สเปกยอมให้โครงสร้างนั้นทำได้โดยไม่มีหน้านั้น มี guard สองข้อใช้ก่อนทั้งหมดจะรัน: DeletePage raise Invalid page number สำหรับ index ที่เกินช่วง และปฏิเสธการลบหน้าสุดท้าย เพราะ node /Pages ที่ไม่มี kid เลยไม่ใช่ PDF ที่ถูกต้อง ส่วน DeletePages รับสัญกรณ์ช่วงแบบ "1,3-5,7-" แบบหนึ่งเริ่มเหมือน operation อื่น ๆ บนเอกสารที่โหลดมา และวนจาก index ที่เลือกไว้สูงสุดลงมาเพื่อให้ index ที่คุณเขียนยังใช้ได้ระหว่างที่มันทำงาน
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('tagged-report.pdf', '') > 0 then
    begin
      // เริ่มที่ศูนย์: ลบหน้าปก named destination, bookmark,
      // structure tree, ParentTree และ link annotation
      // ที่ชี้มาที่มันจะถูกตัดออกก่อนที่ page tree /Pages
      // จะถูกสร้างใหม่
      Pdf.DeletePage(0);
      // สัญกรณ์ช่วงแบบหนึ่งเริ่มสำหรับการลบหลายหน้า โดยภายใน
      // ไล่ index สูงสุดก่อนเพื่อให้ index ที่เขียนไว้ยังใช้ได้
      Pdf.DeletePages('3-4,9');
      Pdf.SaveLoadedDocument('tagged-report-trimmed.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
named destination กับ bookmark ถูกจัดการต่างกันอย่างไร
named destination ถูกลบ ส่วน bookmark ถูกเปลี่ยนเป้าหมาย เพราะชื่อที่ไม่มีอยู่แล้วเป็นผลลัพธ์ที่ยอมรับได้ ขณะที่ bookmark ที่ไม่มีปลายทางเป็นข้อบกพร่องที่มองเห็นได้ ในต้นไม้ /Names /Dests HotPDF เดินทุก node ทดสอบ destination แต่ละตัว ทั้งในรูป array เปล่า ๆ และรูป dictionary ที่มีคีย์ /D เทียบกับหน้าที่ถูกลบ และลบคู่ name/value เมื่อสมาชิกตัวแรกของ array คือหน้านั้น node ที่ทั้ง /Names และ /Kids ว่างเปล่าจะถูกทำเครื่องหมายว่าลบและถอดออกจาก parent ต้นไม้จึงไม่เหลือใบกลวง การทดสอบเดียวกันรันบน dictionary /Dests แบบเก่าใน catalog และ /OpenAction ของ catalog ก็ถูกลบทิ้งเลยถ้ามันเปิดไปที่หน้าที่ถูกลบ มีขอบเขตหนึ่งตรงนี้: เมื่อ node ของต้นไม้ชื่อเสีย entry ไป HotPDF จะลบคู่ /Limits ของ node นั้นแทนที่จะคำนวณคีย์ต่ำสุดกับสูงสุดใหม่ และแม้ viewer จะ resolve ชื่อได้ดีอยู่โดยไม่มีมัน ตัวตรวจ conformance แบบเข้มที่อ่าน ISO 32000-1 §7.9.6 อาจ flag node ที่ไม่ใช่ root ซึ่งขาด /Limits
outline item ไปทางตรงกันข้าม RetargetOutlineDestinations เดินตาม /First กับ /Next จาก outline root พร้อมรายการที่เยี่ยมแล้วและเพดานความลึก 128 เพื่อไม่ให้ต้นไม้ที่วนซ้ำและเสียหายทำให้ call ค้าง และสำหรับทุก array /Dest หรือ array /D ของ action /GoTo ที่เล็งมาที่หน้านั้น มันแทนสมาชิกตัวแรกด้วย NearestRetainedPage: หน้าที่ตามหลังหน้าที่ถูกลบ หรือหน้าที่อยู่ก่อนมันถ้าหน้าที่ถูกลบเป็นหน้าสุดท้าย พารามิเตอร์มุมมองหลังจาก reference ของหน้าถูกปล่อยไว้อย่างเดิม bookmark ที่ชี้ไปที่หน้าปกของบทที่ถูกลบจึงลงที่หน้าแรกของสิ่งที่เหลืออยู่แทนที่จะหายไปจากแถบข้าง ซึ่งเป็นพฤติกรรมที่คนตรวจเอกสารคาดหวังจากเอกสารที่ถูกตัด อย่างไรก็ตาม การทดสอบ destination จับคู่เฉพาะ array ที่ระบุชัด: outline item ที่ /Dest เป็นชื่อสตริงซึ่งเคย resolve ไปที่หน้าที่ถูกลบจะไม่ถูกเปลี่ยนเป้าหมาย เพราะ entry ในต้นไม้ชื่อหายไปแล้วและ reference ตอนนี้ resolve ไปที่ความว่างเปล่าแทนที่จะเป็น object ที่ถูก free viewer จึงถือมันเป็น bookmark ที่ตายแล้ว กลไกของต้นไม้ outline เอง ทั้ง /First, /Next และความหมายของ /Count ที่ไม่ชัดตรง ๆ อยู่ในคู่มือการเพิ่ม bookmark และ named destination บน PDF ที่โหลดมา
// ตรวจสอบการสำรวจแทนที่จะเชื่อมัน
Pdf.DeletePage(0);
if Pdf.ResolveLoadedNamedDestination('cover') = -1 then
  ShowMessage('Named destination "cover" was pruned');
// bookmark ที่เล็งมาที่หน้าปกตอนนี้ resolve ไปที่
// หน้าที่ตามหลังมัน (index เริ่มที่ศูนย์เป็น 0 หลังการลบ)
if Pdf.GetLoadedBookmarkPageIndex('Contents') = 0 then
  ShowMessage('Bookmark retargeted to the nearest retained page');
เกิดอะไรขึ้นกับ structure tree และ ParentTree
structure element ที่มีอยู่เพราะหน้าที่ถูกลบเท่านั้นจะถูกลบ และ element ที่คร่อมหลายหน้าจะเสียคีย์ /Pg ไปแต่ยังเก็บ child ไว้ PruneStructureElement ไล่ลงตามห่วงโซ่ /K จาก /StructTreeRoot ถึงความลึก 128 รองรับทั้งรูป array และรูป dictionary เดี่ยวของ /K ที่ §14.7.2 ยอมให้ สำหรับแต่ละ element มันตัด kid ก่อน แล้วจึงประเมินตัว element เอง: ถ้าการตัดทำให้ /K ว่างเปล่า element นั้นถูกทำเครื่องหมายว่าลบและ parent ของมันถอดมันออก ถ้า /Pg ของ element ระบุหน้าที่ถูกลบและ element ยังมี kid กับ parent /P อยู่ จะลบแค่ /Pg เพราะ /Pg บน element เป็นหน้าดีฟอลต์ของ kid ที่เป็น marked content และ kid เหล่านั้นอาจอ้างหน้าอื่นอย่างชัดเจน มีแค่ element ที่ /Pg เป็นหน้าที่ถูกลบและไม่มีอะไรเหลือใต้มันเลยเท่านั้นที่ถูกลบทั้งตัว
ParentTree ได้การจัดการแบบเดียวกัน และเหตุผลคือเรื่องที่ทำเจ็บตอนพัฒนา: structure element ตัวหนึ่งอาจเข้าถึงได้จาก ParentTree และไม่มีจากที่อื่นเลย ต้นไม้ตัวเลข map จำนวนเต็ม /StructParents ไปเป็น element เดี่ยวหรือ array ของ element และ PruneParentTreeNode รัน PruneStructureElement บนทุกค่าที่มันเจอ ลบค่าที่ถูกตัดออกไป ลบคู่ /Nums เมื่อ array ของค่าว่างเปล่า และถอด node ที่ทั้ง /Nums และ /Kids หายไปออก การตัดเฉพาะ descendant ของ /K จะทิ้ง element ที่กำพร้าเหล่านั้นไว้ชี้ไปที่หน้าที่ถูก free ผ่าน /Pg และชี้ไปที่ marked-content reference ที่ถูก free ผ่าน kid /MCR ของมัน ถ้าคุณ extract ข้อความตามลำดับโครงสร้าง เรื่องนี้สำคัญตรง ๆ: การ extract ข้อความตามลำดับโครงสร้าง เดินตามต้นไม้เหล่านี้เป๊ะ ๆ และ element ที่มี /Pg เป็น null คือย่อหน้าที่หายไปจากลำดับการอ่านเงียบ ๆ
link annotation ตัวไหนบนหน้าที่เหลือถูกลบ
link annotation ใดก็ตามบนหน้าที่เหลือซึ่ง array /Dest หรือ action /GoTo ชี้ไปที่หน้าที่ถูกลบจะถูกลบพร้อมความเป็นเจ้าของใน structure tree ของมัน RemoveRetainedPageDestinationAnnotations เดิน array /Annots ของทุกหน้าที่ยกเว้นเป้าหมาย ใช้การทดสอบ destination ชุดเดียวกับที่ใช้กับ outline ทำเครื่องหมาย annotation ที่ตรงว่าลบ ถอดมันออกจาก array แล้วเรียก PruneAnnotationReferencesInStructureTree เพื่อให้ dictionary OBJR ที่ /Obj ระบุ annotation นั้นถูกลบออกจาก structure element ของมัน พร้อมกับตัว element เองที่ถูกลบถ้า OBJR เป็น kid ตัวเดียวของมัน การปล่อย OBJR ไว้จะละเมิด §14.7.4.3 ซึ่งกำหนดให้ /Obj ต้องอ้าง object ที่มีอยู่ และจะโผล่ในการตรวจ PDF/UA เป็น link ที่มี tag แต่ไม่มี annotation รองรับ สังเกตความไม่สมมาตรกับ bookmark: link ถูกลบ ไม่ถูกเปลี่ยนเป้าหมาย การอ้างอิงในเนื้อความที่บอกว่า ดูหน้า 3 นั้นผิดเมื่อหน้า 3 หายไป และการชี้มันไปที่หน้า 4 จะเป็นการโกหกในแบบที่ bookmark ที่ลงที่บทใกล้สุดไม่เป็น ถ้า workflow ของคุณต้องเก็บ link เหล่านั้นไว้ จงเปลี่ยนเป้าหมายเองก่อนเรียก DeletePage
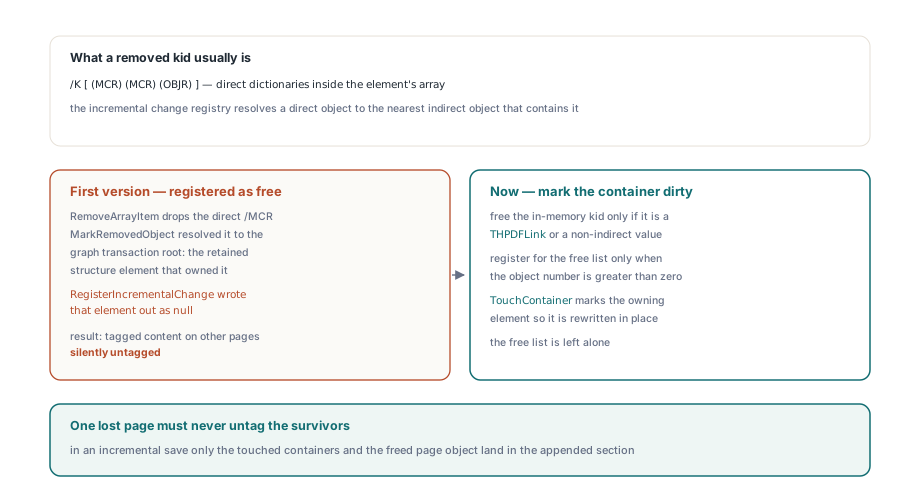
ทำไม /MCR หรือ /OBJR ที่ถูกลบถึงห้ามถูกลงทะเบียนเป็น free
เพราะ marked-content reference กับ object reference มักเป็น dictionary ตรง ๆ อยู่ใน array /K ของ element แม่ และ incremental change registry resolve object แบบ direct ไปที่ indirect object ที่ใกล้ที่สุดซึ่งบรรจุมัน เมื่อ RemoveArrayItem ถอด kid ออกจาก array /K มัน free object ในหน่วยความจำเฉพาะเมื่อมันเป็น THPDFLink หรือค่าที่ไม่ใช่ indirect และ MarkRemovedObject ลงทะเบียน object เข้า free list เฉพาะเมื่อหมายเลข object ของมันมากกว่าศูนย์ เวอร์ชันแรกของการสำรวจนี้ไม่แยกความต่างนั้น และผลในการเซฟแบบ incremental ก็เป็นสิ่งที่ registry ถูกออกแบบมาให้ทำพอดี: RegisterIncrementalChange เดินจาก /MCR แบบ direct ขึ้นไปที่ graph transaction root ซึ่งก็คือ structure element ที่เหลืออยู่และเป็นเจ้าของมัน แล้วเขียน element นั้นออกมาเป็น null เอกสารที่เสียไปหนึ่งหน้ากลับมาพร้อมเนื้อหาที่มี tag บนหน้าอื่นกลายเป็นไม่มี tag เงียบ ๆ ทางเดียวที่ถูกสำหรับ kid แบบ direct คือทำเครื่องหมาย container ของมันว่า dirty ผ่าน TouchContainer เพื่อให้ container ถูกเขียนใหม่ และปล่อย free list ไว้
// incremental update: มีแค่ container ที่ถูกแตะกับ
// object ของหน้าที่ถูก free ที่ลงในส่วนที่ต่อท้าย
Pdf := THotPDF.Create(nil);
try
  Pdf.BeginIncrementalUpdate('tagged-report.pdf');
  Pdf.DeletePage(0);
  // structure element ที่เหลืออยู่ซึ่ง /K เสีย /MCR แบบ direct ไป
  // ถูกเขียนใหม่ในที่เดิม ไม่เคยถูกเขียนเป็น null
  Pdf.SaveIncrementalUpdate('tagged-report-trimmed.pdf');
finally
  Pdf.Free;
end;
ความระวังเดียวกันนี้กำหนดว่าอะไรที่ DeletePage จงใจไม่ free บนเอกสารที่โหลดมา content stream, XObject และ annotation ที่ไม่ใช่ widget ของหน้าที่ถูกลบถูกทิ้งไว้เป็น object เพราะไฟล์ที่โหลดมาอาจแชร์อะไรก็ตามในนั้นกับหน้าที่อยู่ต่อ และไม่มีวิธีถูก ๆ ที่จะพิสูจน์ว่าตรงกันข้ามตอนลบ การเอา reference ใน page tree ออกก็เพียงพอสำหรับความถูกต้อง ส่วนไบต์ที่ object เหล่านั้นยังกินอยู่เป็นคำถามคนละข้อ และobject dependency graph กับการวิเคราะห์ retained byte คือเครื่องมือสำหรับวัดว่าเอกสารที่ถูกตัดยังพาอะไรอยู่
DeletePage กับ DeleteLoadedPage: ควรเรียกตัวไหน
เรียก DeletePage สำหรับการลบหน้าใด ๆ ที่ผู้ใช้เห็น และเก็บ DeleteLoadedPage ไว้สำหรับกรณีที่เอกสารทั้งฉบับกำลังถูกจัดหน้าใหม่และไม่มี reference ระดับเอกสารตัวใดที่คุ้มจะเก็บ THotPDF.DeleteLoadedPage(PageIndex) ที่เพิ่มในเวอร์ชัน 2.508.0 เป็นตัวเลือกแบบเบา: มันเลื่อน array ของหน้าในหน่วยความจำ เรียก RebuildLoadedKidsArray เพื่อเขียน /Kids กับ /Count ใหม่ ทำให้ cache ของหน้าที่ render ใช้ไม่ได้ และยิง OnLoadedDocumentModified มันไม่เดินต้นไม้ชื่อ, outline, structure tree หรือ annotation ของหน้าอื่น และไม่ทำเครื่องหมายว่า object ของหน้าถูกลบ นั่นคือเครื่องมือที่ถูกสำหรับ N-up imposition ที่ HotPDF ต่อแผ่นที่เพิ่งจัดเรียงเสร็จแล้วทิ้งหน้าต้นฉบับทุกหน้าด้วย DeleteLoadedPage(0): หน้าต้นทางถูกแทนที่ทั้งชุด และเนื้อหาของแผ่นอ้าง resource ของมัน ไม่ได้อ้าง object ของหน้า สำหรับงานทั่วไปอย่าง ลบหน้า 7 ออกจากสัญญาฉบับนี้ DeletePage เป็น call เดียวที่ทิ้งเอกสารที่มี tag, bookmark และ cross-link ให้สอดคล้องพอจะผ่าน validator ทั้งในการเขียนใหม่เต็มรูปแบบผ่าน SaveLoadedDocument และในการ incremental update ผ่าน SaveIncrementalUpdate ทั้งสองเมธอด ship อยู่ใน HotPDF Delphi Component สำหรับ Delphi และ C++Builder โดยไม่ต้องมี viewer runtime หรือ dependency ภายนอก