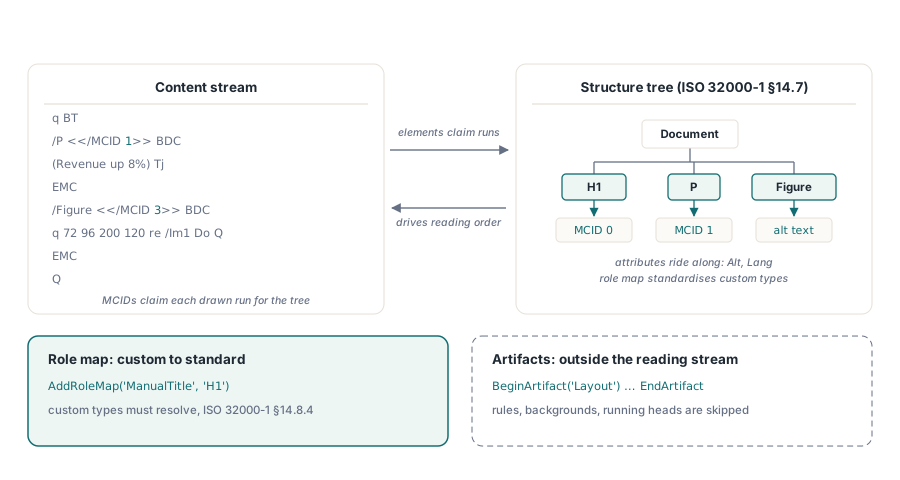
PDF ที่เข้าถึงได้ต้องอาศัยโครงสร้างหนึ่งซึ่งหน้าเอกสารที่มองเห็นไม่เคยแสดงให้ดู นั่นคือ structure tree ที่กำหนดไว้ใน ISO 32000-1 §14.7 มันคือลำดับชั้นเชิงตรรกะของหัวเรื่อง ย่อหน้า ตาราง และรูปภาพ ที่วางซ้อนอยู่เหนือเนื้อหาที่วาดไว้ และแม็ปเข้ากับ role มาตรฐานผ่าน role map screen reader จะอ่านจากโครงสร้างต้นไม้นั้น ไม่ใช่จากรอยที่ปรากฏบนหน้ากระดาษ หากไม่มีมัน ใบแจ้งหนี้ที่สร้างขึ้นมาแล้วดูสมบูรณ์แบบก็ยังว่างเปล่าในเชิงความหมาย เพราะ content stream บันทึกไว้เพียงลำดับการวาดเท่านั้นและไม่มีอะไรอื่นอีก ยอดรวมอาจถูกประกาศก่อนรายการสินค้า ส่วนท้ายกระดาษอาจตัดแทรกเข้ากลางย่อหน้า ตารางรายการอาจยุบรวมกลายเป็นกลุ่มคำที่แยกไม่ออกกลุ่มเดียว ต้นทุนในการป้องกันสิ่งเหล่านี้เอียงไปในทางที่เป็นประโยชน์ต่อคุณอย่างชัดเจน การปล่อย structure ออกมาระหว่างที่วาดนั้นใช้เวลาเพียงไม่กี่นาทีของโค้ด ในขณะที่การย้อนกลับไปเติมมันลงในเอกสารที่เสร็จแล้วคือโปรเจกต์ remediation เต็มรูปแบบ losLab PDF Library (PDF Library for Delphi) เปิดให้ Delphi และ C++Builder เข้าถึงโครงสร้างต้นไม้นี้ผ่านชุดคำสั่งขนาดเล็กที่ห่อหุ้มการดำเนินการวาดแต่ละครั้งไว้ใน role เชิงตรรกะของมัน
วิธีที่ marked content ผูกเข้ากับ structure tree
สองชั้นทำงานร่วมกัน ใน content stream การดำเนินการวาดจะถูกครอบด้วยวงเล็บเป็นลำดับ marked-content แต่ละลำดับมี MCID เป็นจำนวนเต็มกำกับ ใน document catalog structure tree จะแม็ป MCID เหล่านั้นเข้ากับลำดับชั้นของ element ที่มีชนิดกำกับ (H1, P, Table, Figure) พร้อมแอตทริบิวต์อย่างข้อความสำรอง (alternate text) และภาษา ชนิด element แบบกำหนดเองนั้นทำได้ตามกฎ แต่แต่ละชนิดต้องคลี่คลายไปสู่ role มาตรฐานผ่าน role map (ISO 32000-1 §14.8.4) เนื้อหาที่ไม่มีความหมายใด ๆ เลย เช่น เส้นบรรทัด พื้นหลัง และองค์ประกอบซ้ำ ๆ ของหน้ากระดาษ จะถูกทำเครื่องหมายเป็น artifact เพื่อให้ assistive technology ข้ามมันไปแทนที่จะอ่านมันแทรกกลางประโยค
PDF Library for Delphi ดูแลทั้งสองชั้นนี้ไว้เบื้องหลังวงเล็บคู่เดียว BeginTag จะเปิด structure element และเริ่มลำดับ marked-content คำสั่งวาดต่าง ๆ จะตกอยู่ภายในนั้น และ EndTag จะปิดทั้งสองส่วนพร้อมกัน งานบัญชีเบื้องหลังที่มักทำให้การ tagging แบบเขียนมือสะดุด ไม่ว่าจะเป็น MCID, parent tree และการอ้างอิงหน้ากระดาษ ล้วนเกิดขึ้นภายในที่คุณไม่มีทางทำผิดพลาดได้
สวิตช์ระดับเอกสารสองตัวกำหนดกรอบงานนี้ไว้ก่อนที่ tag ใด ๆ จะเปิดขึ้น SetMarkInfo เขียนแฟล็กใน catalog ที่ประกาศว่าเอกสารนี้ถูก tag แล้ว และ IsTaggedPDF อ่านค่านั้นกลับมา ซึ่งเป็นการตรวจสอบแรกที่ต้นทุนต่ำเมื่อต้องตัดสินใจว่าไฟล์ที่รับเข้ามามีโครงสร้างที่ควรค่าแก่การรักษาไว้หรือไม่ ภาษามีจุดเข้าสองจุด SetDocumentLanguage ตั้งค่าเริ่มต้นของเอกสารได้ด้วยตัวเอง ในขณะที่ SetPDFUAMode ตั้งค่านั้นให้เป็นส่วนหนึ่งของการเปิดใช้งาน PDF/UA เต็มรูปแบบ ไฟล์หนึ่งสามารถถูก tag อย่างมีประโยชน์ได้โดยไม่ต้องอ้างความสอดคล้องกับ PDF/UA และการทยอย rollout เป็นระยะมักเริ่มต้นตรงจุดนั้นเอง
Tagging ระหว่างวาด ไม่ใช่ทำทีหลัง
รูปแบบการสร้างเอกสารที่ได้ผลคือปฏิบัติต่อวงเล็บ tag ให้เป็นส่วนหนึ่งของ signature ของทุกคำสั่งวาด ไม่ใช่เป็นขั้นตอนที่ทำภายหลัง:
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;
  try
    Lib.SetOrigin(1);                          // จุดกำเนิดที่มุมซ้ายบน
    Lib.SetPDFUAMode('en-US');                 // เพิ่มเวอร์ชันที่บันทึกเป็น PDF 1.7 โดยอัตโนมัติ
    Lib.SetInformation(1, 'Service Manual');   // /Title จำเป็นสำหรับ PDF/UA
    Lib.AddRoleMap('ManualTitle', 'H1');       // ชนิดกำหนดเอง -> role มาตรฐาน
    Lib.AddStandardFont(4);
    Lib.SetTextSize(18);
    Lib.BeginTagEx2('ManualTitle', '', '', 'en-US', '', 'h1-cover', '');
    Lib.DrawText(72, 96, 'Service Manual');
    Lib.EndTag;
    Lib.BeginTag('Figure', 'Exploded view of the gearbox assembly', '');
    Lib.AddImageFromFile('gearbox.png', 0);
    Lib.EndTag;
    Lib.BeginArtifact('Layout');               // การตกแต่งหน้ากระดาษ: ไม่รวมอยู่ในลำดับการอ่าน
    // ... วาดเส้นบรรทัดและสีพื้นหลัง ...
    Lib.EndArtifact;
    Lib.SaveToFile('manual.pdf');
  finally
    Lib.Free;
  end;
end;
มีสามคำสั่งในลำดับนั้นที่แบกน้ำหนักด้าน compliance ไว้ SetPDFUAMode เปิดใช้งาน PDF/UA output และเพิ่มเวอร์ชันเอกสารเป็น PDF 1.7 โดยไม่แจ้งเตือน ซึ่งชนกับการล็อกเวอร์ชันไว้ เอกสารที่ถูกล็อกไว้ที่ PDF 1.4 ด้วย LockSaveVersion จะปฏิเสธการบันทึกและคืนรหัสข้อผิดพลาด 602 ทันทีที่ UA mode ทำงาน ซึ่งเป็นการปะทะกันที่มักปรากฏขึ้นเมื่อ archival profile กับข้อกำหนดด้านการเข้าถึงถูกตั้งค่าโดยทีมงานคนละทีม SetInformation(1, ...) เขียนชื่อเรื่องของเอกสาร ซึ่ง ISO 14289 คาดหวังให้โปรแกรมแสดงผลนำไปแสดงแทนชื่อไฟล์ การขาดหายไปของมันเป็นหนึ่งใน finding ของ PDF/UA ที่พบบ่อยที่สุดในโลกจริง AddRoleMap ลงทะเบียนชนิด ManualTitle แบบกำหนดเองให้เป็น H1 และการข้ามขั้นตอนนี้จะทำให้ diagnostics ที่อธิบายไว้ด้านล่างแจ้งเตือนว่ามี role ที่ไม่ได้ถูกแม็ปไว้
ระดับของ heading สมควรมีนโยบายที่ตั้งใจกำหนดไว้ ไม่ใช่การเลือกแบบเฉพาะกิจตามรูปลักษณ์ของหน้ากระดาษ ผู้ใช้ screen reader กระโดดข้ามระหว่างส่วนต่าง ๆ ด้วยทางลัด heading ดังนั้น template ที่กระโดดจาก H1 ไปยัง H3 เพราะระดับกลางดูใหญ่เกินไปในการออกแบบภาพ จะทำลายการนำทางนั้นอย่างเงียบ ๆ และไม่มีการรีวิวด้วยสายตาใดจะจับมันได้เลย นี่คือข้อบกพร่องที่ diagnostic HEADING-LEVEL-SKIP มีไว้เพื่อระบุชื่อโดยตรง ให้แม็ปสไตล์ภาพของแต่ละ template เข้ากับลำดับขั้น heading ที่ตายตัวเพียงครั้งเดียวในที่เดียว แล้วความคลาดเคลื่อนจะไม่มีวันเริ่มต้นขึ้น
ตารางที่ screen reader นำทางได้จริง
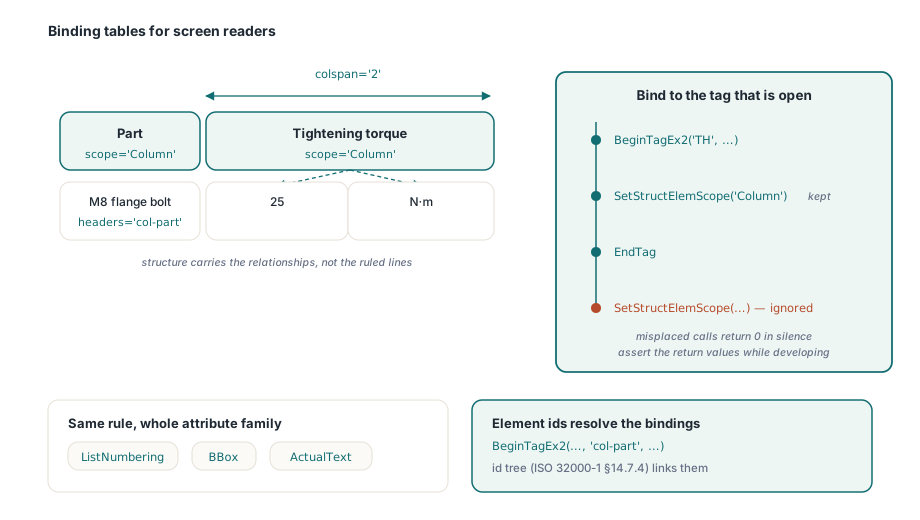
เส้นตารางที่วาดไว้ไม่มีความหมายใด ๆ นอกหน้าจอ สิ่งที่ screen reader นำทางคือความสัมพันธ์เชิงโครงสร้าง: เซลล์ไหนเป็น header, แต่ละ header ควบคุมอะไร และเซลล์ข้อมูลผูกกับ header อย่างไรใน layout ที่ไม่สม่ำเสมอ คำสั่งแอตทริบิวต์ระดับ structure-element จัดการทั้งสามเรื่องนี้:
Lib.BeginTag('Table', '', '');
Lib.BeginTag('TR', '', '');
Lib.BeginTagEx2('TH', '', '', '', '', 'col-part', '');
Lib.SetStructElemScope('Column');          // ใช้ได้เฉพาะระหว่างที่ TH นี้เปิดอยู่เท่านั้น
Lib.DrawText(72, 120, 'Part');
Lib.EndTag;
Lib.BeginTagEx2('TH', '', '', '', '', 'col-torque', '');
Lib.SetStructElemScope('Column');
Lib.SetStructElemColSpan(2);               // header ครอบคลุมทั้งคอลัมน์ค่าและคอลัมน์หน่วย
Lib.DrawText(200, 120, 'Tightening torque');
Lib.EndTag;
Lib.EndTag;
Lib.BeginTag('TR', '', '');
Lib.BeginTag('TD', '', '');
Lib.SetStructElemHeaders('col-part');      // การผูกแบบระบุชัดเจนสำหรับตารางที่ไม่สม่ำเสมอ
Lib.DrawText(72, 140, 'M8 flange bolt');
Lib.EndTag;
Lib.EndTag;
Lib.EndTag; // Table
กฎเรื่องลำดับนั้นเข้มงวดและถูกบังคับใช้อย่างเงียบ ๆ ทุกคำสั่ง SetStructElem* จะมีผลกับ tag ที่เปิดอยู่ ณ ขณะนั้น คือระหว่าง BeginTag กับ EndTag ของมัน และมันจะคืนค่า 0 โดยไม่แจ้งข้อผิดพลาดใด ๆ เมื่อไม่มี tag เปิดอยู่หรือแอตทริบิวต์นั้นใช้ไม่ได้กับ tag ปัจจุบัน คำสั่งที่วางผิดที่จะหายไปเฉย ๆ การห่อค่าที่คืนมาไว้ใน assertion ระหว่างการพัฒนาจะช่วยจับความคลาดเคลื่อนได้ในขณะที่คุณยังมองเห็นมันอยู่ หากปล่อยไว้เฉย ๆ scope ที่หายไปจะปรากฏให้เห็นก็ต่อเมื่อการตรวจสอบการเข้าถึงรัน screen reader จริงข้ามตารางนั้น element ID ที่ส่งผ่าน BeginTagEx2 จะป้อนเข้าสู่ ID tree (ISO 32000-1 §14.7.4) และนั่นคือสิ่งที่ทำให้การผูก SetStructElemHeaders คลี่คลายได้ตั้งแต่แรก
ตระกูลแอตทริบิวต์เดียวกันนี้ครอบคลุมส่วนที่เหลือที่ assistive technology พึ่งพา SetStructElemListNumbering ประกาศว่ารายการในลิสต์ถูกกำกับป้ายอย่างไร เพื่อให้ screen reader ประกาศตำแหน่งภายในลิสต์แทนที่จะท่อง glyph ของ bullet ออกมา SetStructElemBBox บันทึก bounding box ของรูปภาพและตาราง ซึ่งมุมมองแบบ reflow ใช้เพื่อวางเนื้อหา SetStructElemActualText ให้ข้อความทดแทนสำหรับข้อความที่ glyph ของมันไม่แม็ปกับตัวอักษรที่อ่านได้ เช่น drop cap ที่ประกอบขึ้นจากภาพ vector แต่ละคำสั่งเป็นไปตามกฎเดียวกัน: มันผูกกับ tag ที่เปิดอยู่ มิฉะนั้นก็หายไป
Artifact ภาษา และด่านตรวจ diagnostics ก่อนบันทึก
องค์ประกอบซ้ำ ๆ ของหน้ากระดาษ หมายถึง running header, รอยพับ, ลายน้ำ และสีพื้นหลัง ควรอยู่ภายในวงเล็บ BeginArtifact และ EndArtifact เพื่อไม่ให้มันเข้าสู่ลำดับการอ่านเลย ภาษาสามารถสืบทอดได้ ค่าเริ่มต้นของเอกสารมาจาก argument ของ SetPDFUAMode และข้อความในอีกภาษาหนึ่งสามารถ override มันได้เป็นราย element ผ่าน BeginTagEx หรือ SetStructElemLang นั่นคือสิ่งที่ทำให้คำพูดอ้างอิงภาษาฝรั่งเศสในคู่มือภาษาอังกฤษยังคงออกเสียงได้ถูกต้อง
ก่อนบันทึก GetPDFUADiagnostics จะรันการตรวจสอบโครงสร้างของไลบรารีทับเอกสารที่อยู่ใน memory และคืนค่า finding ออกมาเป็นข้อความ โดยสตริงว่างหมายความว่าไม่พบสิ่งใดเลย รหัสเหล่านี้ระบุชื่อข้อผิดพลาดคลาสสิกในการสร้างเอกสารโดยตรง: FIGURE-NO-ALT สำหรับรูปภาพที่ไม่มีข้อความสำรอง, HEADING-LEVEL-SKIP สำหรับ H3 ที่ตามหลัง H1 ทันที, ROLEMAP-UNMAPPED สำหรับชนิดกำหนดเองที่ไม่เคยถูกลงทะเบียนไว้ เชื่อมสิ่งนี้เข้ากับ build (สร้างชุดเอกสาร แล้วทำให้ขั้นตอนล้มเหลวเมื่อ diagnostics ไม่ว่างเปล่า) แล้วปัญหาการเข้าถึงที่ถดถอยจะกลายเป็นความล้มเหลวแบบ compile-time แทนที่จะเป็น finding จากการตรวจสอบในอีกหลายเดือนต่อมา คำตัดสินเรื่องความสอดคล้องแบบเต็มรูปแบบยังคงเป็นหน้าที่ของ preflight บนไฟล์ที่บันทึกแล้ว ซึ่งกล่าวถึงใน PDF/A และ PDF/UA preflight ใน Delphi เพราะการทำ normalization บางอย่างเกิดขึ้นเฉพาะระหว่างการ serialize เท่านั้น
การนำทางด้วย annotation มีปุ่มปรับของตัวเอง PDF/UA คาดหวังให้การไล่ลำดับด้วยแป้นพิมพ์ผ่าน form field และลิงก์เป็นไปตามลำดับของ structure และ SetTabOrderMode เขียน entry ของลำดับ tab ระดับหน้ากระดาษที่โปรแกรมแสดงผลเคารพตาม โดยมี GetTabOrderMode ให้ใช้สำหรับตรวจสอบไฟล์ที่รับเข้ามา นี่คือข้อกำหนดประเภทที่ไม่มีใครสังเกตเห็นจนกว่าผู้ใช้ที่พึ่งพาแป้นพิมพ์เพียงอย่างเดียวจะแจ้งบั๊กเข้ามา และมันใช้ต้นทุนเพียงคำสั่งเดียวต่อเอกสารเพื่อทำให้ถูกต้อง
Structure tree ไม่รอดจากการผสานทุกครั้ง
เอกสารที่ถูก tag จะยังคง tag อยู่ก็ต่อเมื่อทุกขั้นตอนการประมวลผลในภายหลังรักษาโครงสร้างต้นไม้นั้นไว้ และจุดที่คมที่สุดภายใน PDF Library for Delphi คือตระกูล merge-list MergeFileListFast แลกการรักษา structure tree เพื่อความเร็ว นั่นเป็นการแลกเปลี่ยนที่ถูกต้องสำหรับชุดภาพสแกน แต่ผิดสำหรับรายงานที่ถูก tag เพราะผลลัพธ์เปิดได้ปกติ แสดงผลเหมือนเดิมทุกประการ แต่สูญเสียชั้นการเข้าถึงไปอย่างเงียบ ๆ ใช้ MergeFileList แบบค่าเริ่มต้นหรือ variant แบบเข้มงวดทุกครั้งที่มีอินพุตใดถูก tag และทำให้ IsTaggedPDF เป็นส่วนหนึ่งของ assertion หลังการประกอบเอกสาร เพื่อไม่ให้ชุดเอกสารที่ถูกทำให้แบนราบหลุดออกไปโดยไม่มีใครสังเกตเห็น pipeline การประกอบเอกสารสำหรับชุดเอกสารขนาดใหญ่มี trade-off แบบนี้อีกมาก ซึ่งกล่าวถึงใน การผสาน การแบ่ง และการเข้าถึงโดยตรงของ PDF ขนาดใหญ่
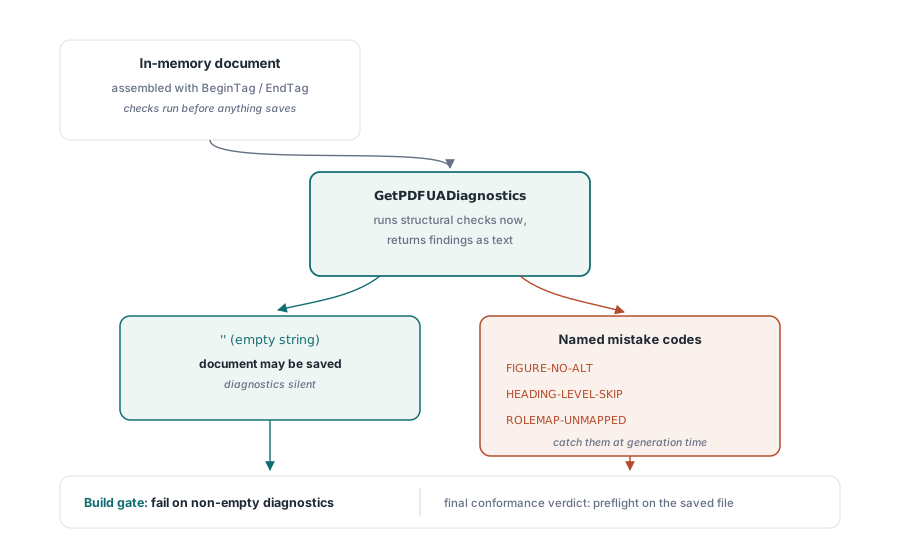
ลูปของการตรวจสอบจะปิดวงนอกไลบรารี: เปิดผลลัพธ์ใน Acrobat ตรวจดูแผง tags และอ่านเอกสารอย่างน้อยหนึ่งฉบับต่อหนึ่งตระกูล template ด้วย screen reader จริง diagnostics จับข้อผิดพลาดเชิงโครงสร้างได้ แต่มีเพียงหูของมนุษย์เท่านั้นที่จับลำดับการอ่านซึ่งถูกต้องในทางเทคนิคแต่งุนงงในทางปฏิบัติได้ ตัวติดตั้งสำหรับประเมินและเอกสารอ้างอิง API การ tagging แบบสมบูรณ์อยู่ที่หน้าผลิตภัณฑ์ losLab PDF Library สำหรับ Delphi