PDFlibPas ซึ่งเป็น losLab PDF Library for Delphi เดิน PDF name tree กับ number tree ด้วย explicit stack กับ visited set ตั้งแต่ v3.539.45 /Kids ที่วนเป็นวง ลูกที่ถูกแชร์ และ tree ที่ลึกเป็นพันชั้นจึงไม่ทำให้ call stack หมด หรือทำให้ entry ซ้ำอีกต่อไป ตั้งแต่ v3.539.51 คู่ /Limits ที่หายไป ผิดรูป หรือกลับด้าน ก็ไม่มีทางซ่อนกิ่งที่ถือ key อีกเช่นกัน named destination, page label, attachment และ JavaScript ระดับเอกสารล้วนอ่านผ่านเส้นทางโค้ดสองทางนี้ ซึ่งทำให้พวกมันเป็นส่วนหนึ่งของ attack surface ของ PDF ทุกฉบับที่คุณไม่ได้ผลิตเอง
ตัวกระตุ้นมักไม่ใช่ของแปลก ๆ fuzzer, ไฟล์อัปโหลดที่มีเจตนาร้าย หรือ incremental save ที่บั๊ก เขียน entry /Kids ที่ชี้กลับไปหาบรรพบุรุษ และตัวเดินแบบ recursive ก็ตายด้วย stack overflow บนไฟล์สองกิโลไบต์ ส่วนความพังที่เงียบกว่าคือ lookup ที่เชื่อ array /Limits ที่พัง แล้วรายงานว่า "ไม่พบ" สำหรับ destination ที่อยู่ตรงนั้นจะ ๆ
name tree กับ number tree อยู่ตรงไหนใน PDF
name tree กับ number tree อยู่ทุกที่ที่ PDF จับชุด key ใหญ่ ๆ ไปแมปกับ object และ PDFlibPas อ่านอย่างน้อยสี่ตัวผ่าน public API ISO 32000-1 §7.9.6 นิยาม name tree (key เป็น string, Table 36) และ §7.9.7 นิยาม number tree (key เป็นจำนวนเต็ม, Table 37) ทั้งคู่เป็น tree แบบค่อนข้างสมดุลที่ node รากกับ node ระดับกลางถือ /Kids leaf ถือคู่ key/value ที่เรียงแล้วใน /Names หรือ /Nums และ node ที่ไม่ใช่รากถือ array /Limits สองช่องบอก key เล็กสุดกับใหญ่สุดที่อยู่ใต้มัน
| Tree | อยู่ที่ไหน | สเปก | read API ของ PDFlibPas |
|---|---|---|---|
| named destination | /Dests ใน name dictionary | §12.3.2.3 | GetNamedDestination ตามด้วย GetDestPage / GetDestType |
| page label | /PageLabels ใน catalog (number tree) | §12.4.2 | GetPageLabel |
| attachment | /EmbeddedFiles ใน name dictionary | §7.7.4, §7.11.4 | EmbeddedFileCount, GetEmbeddedFileStrProperty |
| JavaScript ระดับเอกสาร | /JavaScript ใน name dictionary | §7.7.4 | GlobalJavaScriptCount, GlobalJavaScriptPackageName |
รายละเอียดสองจุดในตารางนี้พลาดง่าย named destination ยังมีรูปเก่าของ PDF 1.1 คือ dictionary /Dests ธรรมดาใน catalog ที่ใช้ name object เป็น key และ GetNamedDestination จะเช็ค dictionary นั้นก่อนแล้วค่อยลงไปเดิน name tree ของ PDF 1.2 ส่วน GetDocJavaScript ไม่ใช่ตัวอ่าน name tree เลย มันคืน script ที่แปะกับ document trigger ใน dictionary /AA ของ catalog (WS, DS, WP, DP, DC) ขณะที่ package ของ script ที่มีชื่อซึ่งรันเมื่อเอกสารเปิด อยู่ใน name tree ของ /JavaScript
ไบต์ทุกตัวของโครงสร้างพวกนี้มาจากไฟล์ สเปกบอกว่า writer ต้องผลิตอะไร แต่มันห้าม reader ไม่ได้ว่าจะได้รับอย่างอื่น ซึ่งเป็นบทเรียนเดียวกับเบื้องหลังการทำให้ Pascal PDF parser แข็งแรงขึ้นต้านไฟล์ประสงค์ร้าย แค่ยกมาใช้กับรูปทรงของ tree แทนขนาด buffer
ทำไม array /Kids ที่วนเป็นวงถึงทำ recursive tree walker ล้ม
array /Kids ที่วนเป็นวงทำ recursive walker ล้มเพราะไม่มีอะไรใน recursion สังเกตว่าตัวเองเคยเห็น node ตัวนี้แล้ว ลูกที่อ้างถึงบรรพบุรุษของตัวเองจึงเปลี่ยนไฟล์จำกัด ๆ ให้กลายเป็นการดิ่งไม่สิ้นสุด ก่อน v3.539.45 NameTreeLookup, NumTreeLookup, EnumNumTree และ TPDFNameTree.ProcessNode ภายใน ต่างเรียกตัวเองหนึ่งครั้งต่อลูก การอ้างตัวเองสักครั้งเดียวก็พอจะจบ process และ tree ที่ถูกต้องแต่ลึกมาก ๆ ก็ทำแบบเดียวกันได้โดยไม่ต้องมีวงเลย
เวอร์ชันอ่อนโยนกว่านั้นไม่ทำให้ล้ม แต่ทำให้ผลลัพธ์เสีย เมื่อ entry /Kids สองตัวอ้าง leaf ตัวเดียวกัน การนับแบบโง่ ๆ จะเยือนมันสองครั้ง และจำนวน attachment หรือรายชื่อ script package ก็จะรายงาน entry ที่ไม่มีอยู่จริง
การแก้เปลี่ยน recursion เป็น stack แบบ last-in, first-out ชัดเจนบน heap พร้อม visited set ที่ใช้ identity ของ dictionary เป็น key node จะถูก mark เมื่อมันถูก pop ไม่ใช่ตอนถูก push การอ้างวนเป็นวงจึงนั่งอยู่บน stack ได้แค่ครู่หนึ่ง แล้วถูกทิ้งทันทีที่มันลอยขึ้นมาใหม่ node ตัวเฉพาะแต่ละตัวขยายลูกของมันเพียงครั้งเดียว งานรวมจึงถูกผูกด้วยจำนวน dictionary ที่ต่างกันบวกความยาวรวมของ array /Kids ทั้งหมด ความลึกเลิกสำคัญ: ห่วงโซ่ 4,096 ชั้นก็แค่ 4,096 รอบของ loop กับ 4,096 entry ใน hash set
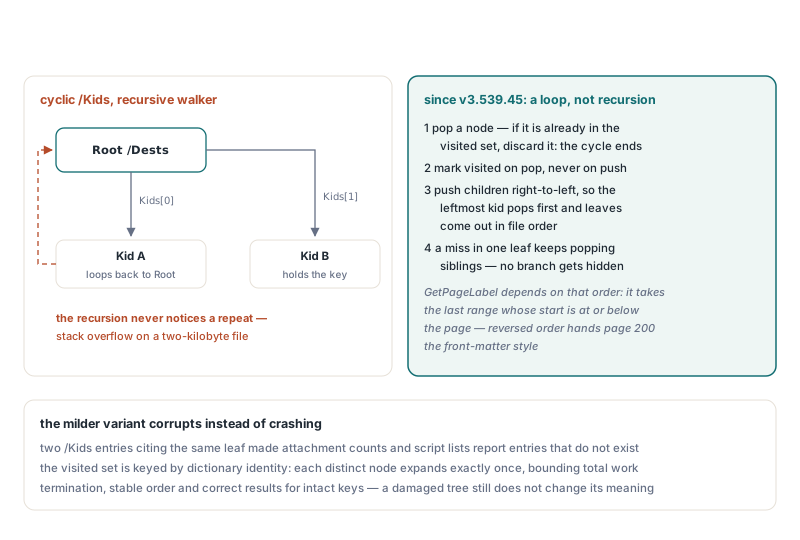
แต่ลำดับก็ยังสำคัญ และ stack ต้องถูกป้อนย้อนทางเพื่อคงมันไว้ ลูกถูก push จาก index สุดท้ายลงมาหาตัวแรก ลูกซ้ายสุดจึงถูก pop ก่อน และ leaf ออกมาตามลำดับซ้ายไปขวาเดียวกับที่ producer เขียนไว้ GetPageLabel พึ่งพาเรื่องนี้: มันเดิน range ที่นับได้ทุกช่วงแล้วใช้ช่วงสุดท้ายที่จุดเริ่มอยู่ที่หรือต่ำกว่าหน้านั้น ถ้าลำดับการนับกลับด้าน หน้า 200 จะได้ style ของส่วนหน้าเฉย ๆ ไปโดยไม่บอก skeleton ด้านล่างโชว์รูปแบบนี้บนชนิด node นามธรรม ไม่ผูกกับ object model ของ PDF ตัวไหน
uses
  System.Generics.Collections;

type
  TTreeNode = class
  public
    Kids: TArray<TTreeNode>;   // ว่างบน leaf
    Keys: TArray<string>;      // key ของ leaf เรียงโดย producer ที่ประพฤติดี
    Values: TArray<Integer>;   // ขนานกับ Keys
    HasLimits: Boolean;
    LoKey, HiKey: string;
  end;

// /Limits เป็นเพียงคำใบ้: คู่ที่สมบูรณ์และเรียงถูกทิศเท่านั้นที่ตัดกิ่งได้
function LimitsExclude(Node: TTreeNode; const Key: string): Boolean;
begin
  Result := Node.HasLimits and (Node.LoKey <= Node.HiKey) and
    ((Key < Node.LoKey) or (Key > Node.HiKey));
end;

function FindValue(Root: TTreeNode; const Key: string;
  out Value: Integer): Boolean;
var
  Pending: TList<TTreeNode>;
  Visited: TDictionary<TTreeNode, Byte>;
  Node: TTreeNode;
  I: Integer;
begin
  Result := False;
  Value := 0;
  if Root = nil then
    Exit;
  Pending := TList<TTreeNode>.Create;
  Visited := TDictionary<TTreeNode, Byte>.Create;
  try
    Pending.Add(Root);
    while Pending.Count > 0 do
    begin
      Node := Pending[Pending.Count - 1];
      Pending.Delete(Pending.Count - 1);
      if Visited.ContainsKey(Node) then
        Continue;                      // cycle หรือลูกที่ถูกแชร์: เคยเห็นแล้ว
      Visited.Add(Node, 0);
      if Length(Node.Kids) > 0 then
      begin
        // push จากขวาไปซ้ายเพื่อให้ลูกซ้ายสุดถูก pop ก่อน
        for I := High(Node.Kids) downto 0 do
          if (Node.Kids[I] <> nil) and not LimitsExclude(Node.Kids[I], Key) then
            Pending.Add(Node.Kids[I]);
      end
      else
        for I := 0 to High(Node.Keys) do
          if (Node.Keys[I] = Key) and (I <= High(Node.Values)) then
          begin
            Value := Node.Values[I];
            Exit(True);
          end;
      // ไม่เจอใน leaf นี้ยังไม่ใช่คำตัดสิน: ค่อย ๆ pop พี่น้องต่อไป
    end;
  finally
    Visited.Free;
    Pending.Free;
  end;
end;
ทำไม lookup หยุดที่กิ่งแรกที่ range ตรงไม่ได้
lookup หยุดที่กิ่งแรกที่ range ตรงไม่ได้ เพราะ range ของ /Limits ในไฟล์จริงซ้อนทับกันหรือโกหกได้ กิ่งที่อ้างว่าถือ key ไม่จำเป็นต้องเป็นกิ่งที่ถือมันจริง lookup ก่อน v3.539.45 เซ็ต flag Found ที่ลูกแรกที่ /Limits ครอบคลุม key ลงไปเดินต่อในกิ่งนั้น แล้วไม่เคยมองพี่น้องตัวอื่นอีก ถ้าลูกตัวนั้นกลายเป็นก้อนว่าง ค้างสเตล หรือวนกลับไปหาราก คำตอบก็คือ nil แม้พี่น้องตัวถัดไปจะถือ key อยู่ก็ตาม
FindTreeValue ที่เขียนใหม่ซึ่งตอนนี้รองรับทั้ง NameTreeLookup กับ NumTreeLookup push ลูกทุกตัวที่ range ไม่ตัด key ออก แล้วค่อย ๆ pop จนกว่าจะเจอ match หรือ stack ว่าง การไม่เจอใน leaf เดียวก็แค่ไม่เจอใน leaf เดียว บน tree ที่สมบูรณ์ค่าใช้จ่ายเพิ่มเป็นศูนย์ บน tree ที่พังก็แค่เยือน node เพิ่มอีกไม่กี่ตัวแล้วได้คำตอบที่ถูก
การค้นใน leaf ยึดปรัชญาเดียวกัน ISO 32000-1 บังคับว่า key ใน array /Names ต้องเรียงตามค่าไบต์ leaf จึงถูกค้นด้วย binary search ก่อน ถ้าไม่เจอ PDFlibPas จะ fallback ไปสแกนเชิงเส้นทีละคู่ เพราะ leaf ที่เรียงพลาดจะทำให้ key ที่อยู่จริงมองไม่เห็นไปเฉย ๆ การเรียงคือ fast path ไม่ใช่ตัวกรอง
lookup ยังปฏิเสธที่จะเดาในข้อขัดแย้งเชิงโครงสร้างหนึ่งเรื่อง Table 36 อนุญาตให้ node ถือ /Kids หรือ /Names อย่างใดอย่างหนึ่งเท่านั้น ห้ามทั้งคู่ เส้นทาง lookup จึงถือ node ที่ถือทั้งสองเป็นไฟล์ผิดรูปแล้วข้ามมันไป แทนที่จะเลือกตีความสักอย่าง เส้นทางนับอย่าง EnumNumTree หย่อนกว่าและไล่ตาม /Kids เมื่อทั้งคู่มีอยู่
reader เชื่อ /Limits เพื่ออะไรได้บ้าง
reader เชื่อ /Limits ได้แค่เพื่อตัดงานทิ้ง ห้ามใช้ตัดสินว่า key นั้นไม่มี และใช้ได้เฉพาะเมื่อคู่นั้นสมบูรณ์ Table 36 บอกว่า node ระดับกลางกับ leaf ต้องถือ /Limits เป็น array สองช่องของ key เล็กสุดกับใหญ่สุด แต่ในทางปฏิบัติ entry นี้หายหลังการแก้ไฟล์มือ ใส่ตัวเลขไว้ใน name tree หรือมาถึงพร้อมขอบเขตกลับด้าน PDFlibPas v3.539.45 กับ v3.539.51 จัดการทุกเคสแบบเดียวกัน: ถ้า range อ่านเป็นคู่เรียงลำดับของชนิดที่ถูกไม่ได้ ลูกก็ยังถูกค้นต่อ
/Limitsหาย: เช็ค range แบบเดิมคืน False และลูกถูกข้ามทิ้งเลย producer ที่ลืม entry เลยทำ subtree ทั้งก้อนไปไม่ถึง ตั้งแต่ v3.539.45 ลูกถูกค้น- ชนิดผิดหรือความยาวผิด อย่างตัวเลขใน name tree หรือ array ช่องเดียว: ถือเหมือน entry หายตั้งแต่ v3.539.45
- ขอบเขตกลับด้านอย่าง
[(Z) (A)]หรือ[9 0]: v3.539.45 ยังใช้พวกมันอยู่ และไม่มี key ใดพอใจLo <= Key <= Hiเมื่อLo > Hiกิ่งจึงถูกตัดทิ้งในทุก lookup ตั้งแต่ v3.539.51 range จะถูกใช้ตัดงานเมื่อขอบล่างไม่เกินขอบบนเท่านั้น - สมบูรณ์ เรียงถูกทิศ และถูกต้อง: ใช้ตัดกิ่งได้ ซึ่งก็คือจุดประสงค์ทั้งหมดของ entry นี้
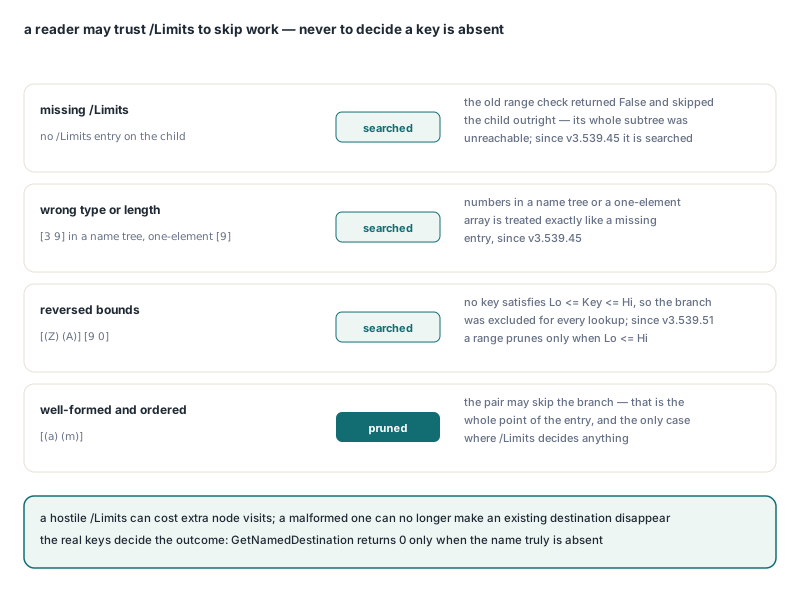
key จริงตัดสินผลในทุกเคส /Limits ที่มุ่งร้ายทำให้ PDFlibPas เยือน node เกินจำเป็นได้ แต่ตัวที่ผิดรูปไม่มีทางทำให้ destination ที่มีอยู่จริงหายไปได้อีก จากฝั่ง caller ไม่มีอะไรเปลี่ยน: GetNamedDestination คืน 0 เมื่อชื่อนั้นไม่มีจริง และคืน destination ID เมื่อมี ส่วนฟังก์ชันของ destination ดำเนินต่อจากตรงนั้น
uses
  PDFlibrary;

procedure LookUpDestination(const FileName, DestName: string);
var
  Lib: TPDFlib;
  DestID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
    begin
      WriteLn('Load failed, error ', Lib.LastErrorCode);
      Exit;
    end;
    // Catalog /Dests (PDF 1.1) ก่อน แล้วค่อย name tree ของ /Dests
    DestID := Lib.GetNamedDestination(DestName);
    if DestID = 0 then
      WriteLn('No destination named ', DestName)
    else if Lib.GetDestPage(DestID) = 0 then
      WriteLn(DestName, ' exists but does not resolve to a page')
    else
      WriteLn(DestName, ' -> page ', Lib.GetDestPage(DestID),
        ', view type ', Lib.GetDestType(DestID));  // 1 = XYZ, 2 = Fit ...
  finally
    Lib.Free;
  end;
end;
รันกับไฟล์ที่ปั้นเองที่ราก /Dests มีลูกหนึ่งตัววนกลับไปหารากภายใต้ range [(a) (z)] และลูกตัวที่สองถือ entry จริงอยู่ใต้ limits แบบกลับด้าน [(z) (a)] procedure นี้ resolve destination ได้หน้า 2 พร้อม view type 2 (Fit) ก่อน v3.539.45 lookup เดียวกันคืน 0 เพราะลูกที่วนเป็นวงอ้างสิทธิ์ key ก่อน และการค้นไม่เคยไปถึงพี่น้องของมัน v3.539.45 อย่างเดียวยังคืน 0 เพราะ range ที่กลับด้านตัด leaf จริงทิ้ง ถ้าคุณจะอ่าน outline ที่ชี้ไปหา destination พวกนี้ต่อ บทความคู่กันเรื่องการอ่าน action ของ bookmark และ annotation ใน PDF ด้วย Delphi เล่าฝั่ง action ให้ครบ
leaf ที่มี 32,769 ชื่อทำ TPDFNameTree พังอย่างไร
leaf ที่มีคู่ name/value จำนวน 32,769 ทำ TPDFNameTree พังเพราะ FindIndex ภายในของมันอัดตัวเลขสองตัวลง Integer 32 บิตตัวเดียว: ตำแหน่งของ leaf ใน array list ภายในอยู่ครึ่งสูง 16 บิต และ offset ของ entry ใน array /Names ของ leaf นั้นอยู่ครึ่งต่ำ 16 บิต แต่ละคู่กินสองช่องของ array คู่ที่ 32,769 คือ pair index 32,768 จึงเริ่มที่ offset 65,536 หรือ $10000 ค่านี้พาดพิงเข้าครึ่งสูง และ decoder อ่านมันกลับมาเป็น offset 0 ของ leaf ถัดไป
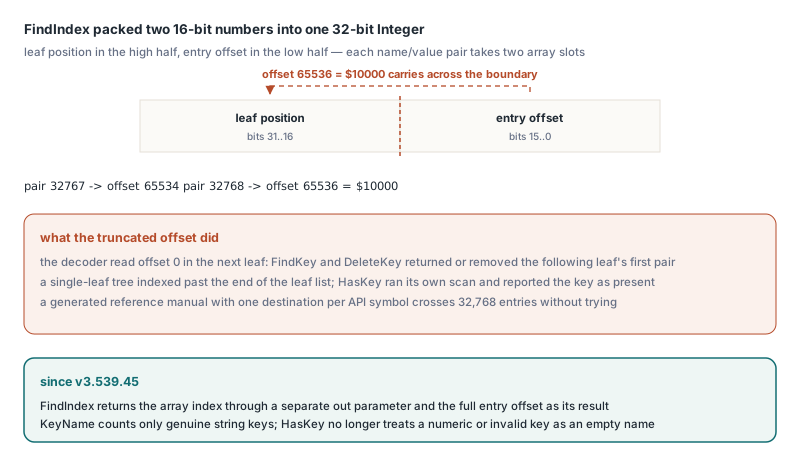
TPDFNameTree เป็นคลาสเบื้องหลัง attachment, global JavaScript package และการเขียน named destination ผลที่ตามมาจึงเป็นรูปธรรม บน tree ใบเดียวไม่มี leaf ถัดไปให้ไป FindKey กับ DeleteKey จึง index ล้ำเลยสุดของรายการ leaf บน tree หลายใบพวกมันคืนหรือลบคู่แรกของ leaf ถัดไปแทนที่จะเป็นคู่ที่ขอไป ระหว่างนั้น HasKey วิ่งสแกนของตัวเองแล้วรายงานว่า key อยู่ คลาสจึงพูดสวนตัวเอง reference manual ที่สร้างอัตโนมัติที่มี named destination หนึ่งตัวต่อ symbol ของ API ข้าม 32,768 entry ได้โดยไม่ต้องตั้งใจ และบาง producer เขียนมันทั้งหมดลง leaf แบนใบเดียว
ตั้งแต่ v3.539.45 FindIndex คืน index ของ array ผ่าน parameter out แยกต่างหาก และคืน offset เต็มของ entry เป็นผลลัพธ์ ค่าทั้งสองจึงไม่ถูกตัดทอน release เดียวกันยังถี่ถ้วนเพื่อนบ้านอีกสองตัว KeyName ตอนนี้นับและคืนแต่ key ที่เป็น string จริง ๆ และคืน string ว่างสำหรับ index 0 หรือต่ำกว่า แทนที่จะ cast object อะไรก็ได้ที่ตามหลัง key ที่ไม่ถูกต้อง HasKey ไม่ถือ key ที่เป็นตัวเลขหรือไม่ถูกต้องเป็นชื่อว่างอีก สำหรับ leaf อย่าง [(Valid) 42 123 456] HasKey('') ตอนนี้เป็น False และ KeyName(2) คืน string ว่าง
procedure AuditTrees(const FileName: string);
var
  Lib: TPDFlib;
  I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
      Exit;
    // number tree ของ /PageLabels; ไฟล์ที่ไม่มีจะคืนเลขหน้าธรรมดา
    for I := 1 to Lib.PageCount do
      WriteLn('Page ', I, ' label: ', Lib.GetPageLabel(I));
    // name tree ของ /EmbeddedFiles; index เริ่มที่ 1, key ที่ไม่ใช่ string ถูกข้าม
    for I := 1 to Lib.EmbeddedFileCount do
      WriteLn('Attachment ', I, ': ', Lib.GetEmbeddedFileStrProperty(I, 1),
        ' (', Lib.GetEmbeddedFileStrProperty(I, 2), ')');  // ชื่อ, MIME type
    // name tree ของ /JavaScript: แค่ลิสต์ชื่อ package ไม่ execute อะไร
    for I := 1 to Lib.GlobalJavaScriptCount do
      WriteLn('Script package: ', Lib.GlobalJavaScriptPackageName(I));
  finally
    Lib.Free;
  end;
end;
บนไฟล์ที่ปั้นเองไฟล์เดียวกัน ที่รากของ /PageLabels ลิสต์ leaf ตัวหนึ่งซ้ำสองครั้งและอ้างถึงตัวเอง การ audit นี้พิมพ์ i กับ A-1 ให้สองหน้า แต่ละ range ครั้งเดียว และ script package ตัวเดียวจาก tree /JavaScript ที่ก็ชี้กลับไปหารากของมันเช่นกัน ฝั่งเขียนของ page label มีประวัติกับรากแบบ /Kids ของตัวเอง เล่าไว้ในการแก้ page label ของ PDF ที่เก็บใน number tree แบบ /Kids AddPageLabels ทำให้รากแบบนั้นแบนก่อนแทรก และมันอาศัยการนับแบบ EnumNumTree ที่เล่าไว้ในบทความนี้
การแข็งแรงนี้ยังไม่การันตีอะไรบ้าง
การแข็งแรงนี้การันตีการจบลง ลำดับที่นิ่ง และผลที่ถูกต้องสำหรับ tree ที่ key จริงยังสมบูรณ์ มันไม่ได้ทำให้ tree ที่พังหมายถึงสิ่งที่ผู้เขียนตั้งใจ มีขีดจำกัดหลายข้อที่ควรรู้ก่อนจะสร้างต่อบนมัน
- visited set ทำงานด้วย identity ของ object dictionary สองตัวที่เนื้อหาเหมือนกันเป๊ะคือสอง node สำเนา leaf ที่ producer เอามาแปะแทนการอ้างอิงจึงยังให้ entry ซ้ำ
/Limitsที่สมบูรณ์ เรียงถูกทิศ แต่ผิดค่า ยังตัดกิ่งได้อยู่ดี reader ที่ใช้ range เป็น optimization ไม่อาจภูมิคุ้มกัน range ที่โกหกอย่างน่าเชื่อได้ทางเดียวทางเลือกคือละทิ้ง/Limitsทั้งหมดแล้วสแกนทุก leaf- การนับคงลำดับไฟล์แต่ไม่เรียงให้
GetPageLabelใช้ range สุดท้ายที่นับได้ซึ่งอยู่ที่หรือต่ำกว่าหน้า producer ที่เขียน range พล่านลำดับจึงได้ semantics ตามลำดับไฟล์ - หน่วยความจำโตตามจำนวน node กับ entry ที่ต่างกัน การเดินเพิ่มแค่ list กับ hash set เท่านั้น แต่ name tree ขนาด 100 MB ก็ยังเป็น name tree ขนาด 100 MB หลัง parse
- key ซ้ำข้างใน leaf เดียวไม่ถูกรายงาน binary search คืนคู่ที่มันชนก่อนเท่านั้น ส่วน linear fallback คง match สุดท้ายที่มันสแกนเจอ
สรุปด่วน: อ่าน tree ของ PDF จากไฟล์ที่ไม่น่าเชื่อถือ
- อัปเกรดเป็น v3.539.45 ขึ้นไปเพื่อการเดิน name tree กับ number tree ที่ทน cycle ทน stack และเป็น v3.539.51 ขึ้นไปเพื่อให้
/Limitsที่กลับด้านไม่ซ่อน key - ถือว่า
GetNamedDestinationคืน 0 หมายถึง "ไม่มี" และGetDestPageคืน 0 หมายถึง "มีแต่ใช้ไม่ได้" - ใช้
GlobalJavaScriptCountกับGlobalJavaScriptPackageNameกับ name tree ของ/JavaScriptส่วนGetDocJavaScriptอ่าน trigger ของ/AAใน catalog แทน - index attachment กับ script package จาก 1 ถึงจำนวนที่ library รายงาน key ที่ไม่ถูกต้องไม่ถูกนับ
- ในโค้ด tree ของคุณเอง mark node ว่าเห็นแล้วตอน pop push ลูกย้อนทาง และปล่อยให้
/Limitsตัดกิ่งเฉพาะเมื่อมันเป็นคู่ชนิดถูกและเรียงถูกทิศ
เครื่องมือ pre-flight, archiver และ viewer ต่างอ่าน tree พวกนี้ก่อนหน้าใดจะถูก render จึงต้องรอดจากทุกอย่างที่ไหลเข้าคิวอัปโหลด ตัวอ่าน tree ที่เล่าไว้ข้างบนมาพร้อมPDFlibPas, the PDF Library for Delphi ซึ่ง build ได้ทั้งกับ Delphi และ Free Pascal