Importerar du ett FDF i ett formulär kommer fältvärdena tillbaka subtilt fel: en bullet anländer som en dagger, en ellipsis som ett em dash. PDFium Component spårade hela den symptomfamiljen till en enda rad i sin PDFDocEncoding-tabell — specialteckenblocket i ISO 32000-1 Annex D.2 börjar vid $80, inte $7F
Varför returnerar en FDF-import grannkaraktären?
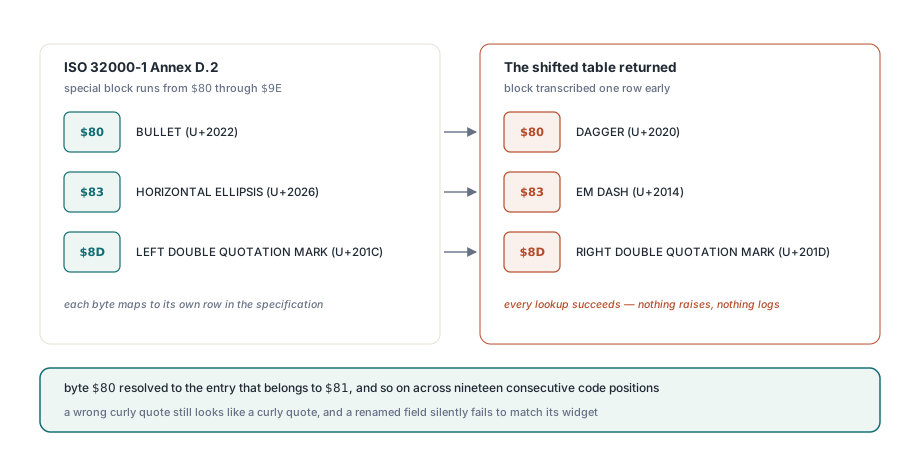
För att en kodningstabell som skjutits en position är fortfarande en fullt giltigt utseende tabell, och varje uppslagning i den lyckas. Blocket som Annex D.2 tilldelar $80 till och med $9E hade transkriberats en rad för tidigt, så byte $80 löste till posten som hör till $81, byte $81 till posten för $82, och så vidare över nitton på varandra följande kodpositioner. Inget höjdes, inget loggades, och inget fält avvisades någonsin — TPdf.ImportFDF rapporterade samma fältantal som alltid
Skadan var enhetlig och tyst. En byte som bär $80, som Annex D.2 definierar som BULLET (U+2022), kom tillbaka som DAGGER (U+2020). Byte $83, HORIZONTAL ELLIPSIS (U+2026), kom tillbaka som EM DASH (U+2014). Byte $8D, LEFT DOUBLE QUOTATION MARK (U+201C), kom tillbaka som RIGHT DOUBLE QUOTATION MARK (U+201D) — fallet ingen lägger märke till, för ett felaktigt krullat citattecken ser ändå ut som ett krullat citattecken i ett formulärfält. Fältnamn drabbades av samma öde som fältvärden, vilket är värre: ett namn som inte längre matchar widgeten i dokumentet misslyckas tyst med att tillämpas
PDF-textsträngar bär två olika kodningar
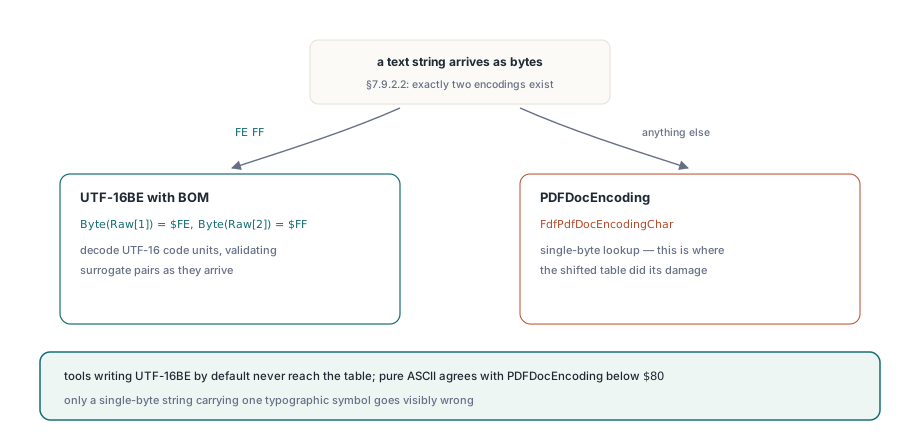
ISO 32000-1 §7.9.2.2 definierar textsträngtypen som en av exakt två kodningar, vald genom att inspektera de två första byten i stället för genom någon dictionary-post. En sträng som inleds med byte order mark FE FF är UTF-16BE; allt annat är PDFDocEncoding. Den enda grenen avgör vilken av två helt olika avkodare som körs, och PDFium Component tillämpar den inuti FDF-parsern innan den rör en enda karaktär
// FDF-textsträng: UTF-16 när BOM finns, annars PDFDocEncoding
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... avkoda UTF-16-kodenheter, validera surrogatpar
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;
Det här är varför buggen gömde sig så länge i vanlig testning. Ett FDF som produceras av ett verktyg som skriver UTF-16BE som standard når FdfPdfDocEncodingChar aldrig alls, så den förskjutna tabellen förblir vilande. Bara en-byte-strängar — vilket är vad många FDF-generatorer skickar ut för vanliga latinska fältnamn, för att de är kortare — går ner i grenen där tabellen spelar roll. Rena ASCII-fältnamn avkodas ändå korrekt, eftersom PDFDocEncoding och ASCII överensstämmer under $80. Du behöver en en-byte-sträng som innehåller ett typografiskt tecken innan något går synligt fel
Den fixade tabellen, och de två ankare som spikar fast den
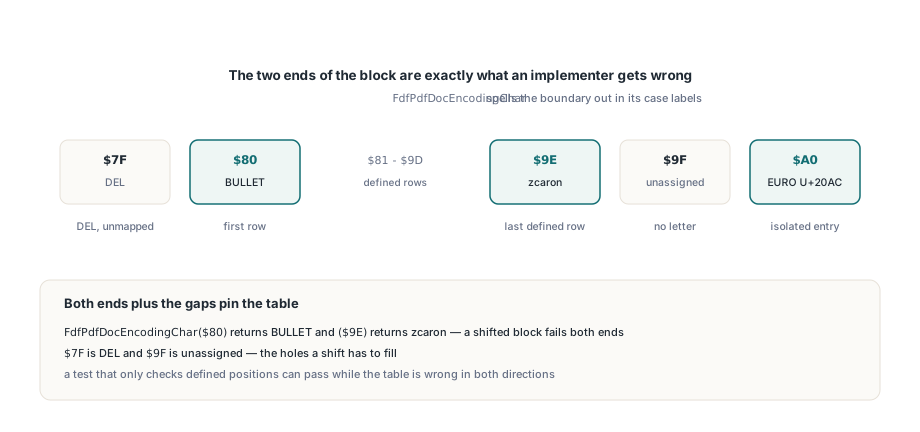
PDFium Component staver nu ut gränsen i FdfPdfDocEncodingChar själv, eftersom blockets två ändar är exakt vad en implementerare får fel. $7F är DEL och har ingen PDFDocEncoding-betydelse alls; blocket öppnar vid $80 med BULLET och löper till $9E med zcaron; $9F är otilldelat; och eurotecknet sitter ensamt vid $A0
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // ISO 32000-1 Annex D.2. Blocket löper från $80, inte $7F: $7F är DEL och
    // har ingen PDFDocEncoding-betydelse, och euron sitter vid $A0, som
    // default-grenen annars skulle lämna tillbaka som no-break space
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET, blockets första rad
    $81: Result := WideChar($2020);   // DAGGER
    // ... $82 till och med $9D
    $9E: Result := WideChar($017E);   // zcaron, sista definierade raden
    $9F: Result := WideChar($FFFD);   // otilldelad i Annex D.2
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;
Titta på vad förskjutningen gjorde med de två ändarna, för det är där en off-by-one slutar vara kosmetisk. zcaron satt vid $9E i specifikationen men vid $9D i den förskjutna tabellen, så en dokumentbyte på $9E föll förbi den sista rad någon transkriberat och föll rakt igenom till identity-fallbacken, och returnerade ett C1-kontrolltecken i stället för en bokstav. Och $A0, euron, skrevs aldrig in i tabellen från början — identity-grenen lämnade tillbaka den som U+00A0 NO-BREAK SPACE, en karaktär som överlever varje efterföljande validering, skriver ut som ingenting, och aldrig matchar det fältnamn du letar efter
Hur testar du en transkriberad kodningstabell?
Testa första raden, sista raden och luckorna — inte ett prov från mitten. Det här är den del av fixen som är värd att ta med till vilken annan tabell du än kopierar ur en specifikation, för en stickprovskontroll mitt i blocket är precis det test som en helblocksförskjutning överlever. Att verifiera att $8D ger ett vänster dubbelcitat bevisar ingenting när $8C också ger något plausibelt; att verifiera att $80 ger BULLET och $9E ger zcaron spikar båda ändarna, och ett förskjutet block kan inte tillfredsställa båda samtidigt
procedure CheckPdfDocEncodingAnchors;
begin
  // Båda ändarna av Annex D.2-specialblocket: en helblocksförskjutning bryter dessa
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // Kodpositioner som specifikationen lämnar odefinierade får inte avkoda till en bokstav
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // Den isolerade posten ovanför blocket, lätt att utelämna helt
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;
De odefinierade positionerna förtjänar egna assertions i stället för att hoppas över som ointressanta. En off-by-one måste stoppa in något någonstans, och där den stoppar in det är nästan alltid en kodposition som specifikationen lämnade tom — $7F framtill, $9F baktill. Ett test som bara kontrollerar definierade positioner kan passera medan tabellen är fel åt båda hållen; ett test som spikar hålen fångar förskjutningen vid första körningen
Vad det här kostar i ett rundtursformulärflöde
En FDF-import som tyst skriver om en karaktär per tecken är värre än en som misslyckas, eftersom felet dyker upp nedströms och ser ut som något annat. Fältnamn är den vassa kanten här. TPdf.ImportFDF matchar inkommande namn mot widgetarna i det öppna dokumentet, och ett namn som avkodats fel på en karaktär matchar helt enkelt inte — fältet förblir tomt, returvärdet räknar fortfarande fältet som parsat, och rapporten som kommer ut ur pipelinen saknar ett värde utan att loggen förklarar varför. Den som bygger en export-och-återimport-loop av det slag som beskrivs i att exportera och importera XFDF-formulärdata och anteckningar med PDFium Component bör rundköra ett fältnamn som innehåller ett typografiskt tecken, inte bara ren ASCII, innan de litar på loopen
Det är också värt att vara ärlig om fixens gränser. Tabellen matchar nu Annex D.2 för alla 256 byte-värden, vilket gör att en-byte-FDF-strängar avkodas korrekt, men PDFDocEncoding täcker i sig själv en latinsk repertoar och inget mer — allt utanför den måste anlända som UTF-16BE med en BOM, vilket är exakt vad §7.9.2.2 avser. Och en UTF-16-sträng har fortfarande sina egna separata faror på Delphi-sidan, eftersom en kodpunkt bortom U+FFFF behöver ett surrogatpar i stället för en WideChar, problemet som tas upp i varför emoji och CJK-tecken bryter WideChar i Delphi. Den bredare poängen generaliserar bortom kodningstabeller: en PDF-parser kan avvisa något den borde acceptera, vilket du hittar direkt, eller acceptera något och tyst få det fel, vilket du hittar i produktion. Namntoken-fällorna som beskrivs i att parsa PDF-dictionaries säkert sitter i den andra kategorin, och det gör också en tabell förskjuten en rad — kodvägen lyckas, returvärdet ser rimligt ut, och bara ett test skrivet mot specifikationen i stället för mot implementationen säger något annat
ImportFDF, ExportFDF och ImportXFDF på TPdf, tillsammans med FDF- och XFDF-parserna bakom dem, är en del av standard-PDFium Component för Delphi och C++Builder