Patchar du en leaf-array för att lägga till ett namn kan posten fortfarande läsas som saknad. PDFium Component svarar på det med TPdfTreeEditor, en generell editor för ISO 32000 name trees och number trees: den laddar trädet med strikt validering, redigerar poster i minnet, bygger om en balanserad noduppsättning med korrekta /Limits, och skriver en verifierad inkrementell revision
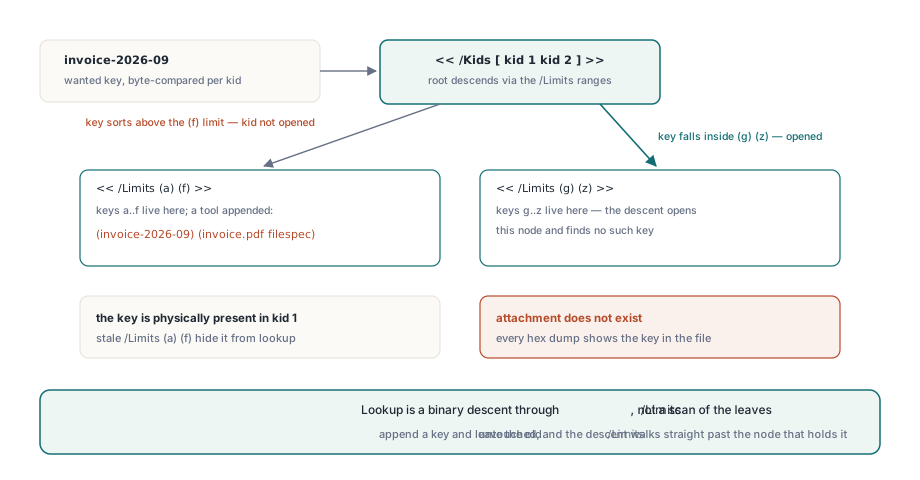
Felet som motiverade den här enheten är av det slag du bara diagnostiserar genom att läsa bytes. Ett verktyg lägger till en nyckel och ett värde i en leaf-/Names-array, skriver en ny revision, och varje hexdump bekräftar att nyckeln finns i filen. Acrobat säger ändå att bilagan inte finns. Inget är korrupt i naiv bemärkelse. Trädet är helt enkelt inte längre ett träd som uppslagsalgoritmen kan stiga ned i
Varför bryter en patchad leaf-array uppslagningen?
För att uppslagningen är en binär nedstigning genom /Limits, inte en skanning av leaves. ISO 32000-1 §7.9.6 definierar ett name tree som en rot vars /Kids leder ner till leaves som håller /Names, en array av alternerande nyckel och värde, med nycklar ordnade efter byte-jämförelse över hela trädet, och varje icke-rotnod som deklarerar /Limits som sina egna minsta och största nycklar. En konform läsare jämför den önskade nyckeln mot varje kid-intervall och öppnar exakt ett barn. Lägger du till en nyckel i en leaf och lämnar de gamla /Limits orörda går nedstigningen rakt förbi noden som faktiskt håller den
Number trees (§7.9.7) har samma form med /Nums och heltalsnycklar, och de bär på riktig trafik: /PageLabels i §12.4.2 är ett number tree, och katalogens /Names-kategorier i §7.7.4 ger dig /Dests, /EmbeddedFiles och /JavaScript som name trees. Så fyra invarianter måste hålla tillsammans, inte en i taget. Nycklar måste vara strikt ökande i trädordning, varje nivå måste publicera limits som matchar dess faktiska nyckelintervall, syskonintervall får inte överlappa, och rotens objektnummer och generation måste ligga exakt där de låg, eftersom katalogen och alla andra refererare pekar på den roten genom indirekt referens. Vår not om att arbeta med PDF-bilagor i Delphi visar konsumentsidan av samma struktur
Vad vägrar TPdfTreeEditor att ladda?
Mer än du kanske förväntar dig, och det är medvetet. TPdfTreeEditor.TryLoad går igenom nodgrafen genom TPdfSparseDictionaryReader, löser varje barn med ReadDictionary vid exakt den generation som referensen anger i stället för att acceptera vilken revision som råkar vara aktiv. Ett träd som inte kan bevisas välformat avvisas innan en enda redigering tillåts, vilket hindrar trasig indata från att bli trasig utdata som ser rimlig ut
- Cykler och upprepade referenser, båda rapporterade som
ptviCycle, så en/Kids-post som pekar tillbaka upp i kedjan avslutas i stället för att rekursera - Blandade nodformer: en dictionary som bär
/Kidstillsammans med/Nameseller/NumsärptviInvalidNodeShape, liksom en tom icke-rot-leaf - Osorterade eller duplicerade nycklar, rapporterade som
ptviUnsortedKeyochptviDuplicateKey, kontrollerade över hela traverseringen snarare än inuti en enda leaf - Limits som inte stämmer med de nycklar som faktiskt finns, rapporterade som
ptviInvalidLimits - Ett raw-värde som inte är exakt ett komplett PDF-objekt, rapporterat som
ptviInvalidValue - Budgetöverskridanden:
ptviDepthLimit,ptviNodeLimit,ptviEntryLimitochptviDeadlineExceeded, begränsade av bådeTPdfTreeEditOptionsoch den centrala parserbudgeten
TPdfTreeEditOptions.Default sätter de trädlokala gränserna till 1,000,000 poster, 100,000 noder, djup 64, 64 poster per leaf och 32 kids per nod. Siffrorna för leaf och kid är inte bara skydd; de är fan-outen som används senare när trädet byggs om, vilket är varför posten validerar att båda är minst två
uses
  FPdfCompress;

var
  Options: TPdfTreeEditOptions;
  RootRef: TPdfTreeObjectReference;
  Editor: TPdfTreeEditor;
  Report: TPdfTreeValidationReport;
begin
  Options := TPdfTreeEditOptions.Default;
  RootRef.ObjectNumber := EmbeddedFilesRootObject;   { katalog /Names /EmbeddedFiles }
  RootRef.Generation := EmbeddedFilesRootGeneration;
  if not TPdfTreeEditor.TryLoad(Source, ptkName, RootRef, Options,
    Editor, Report) then
  begin
    Writeln('tree rejected: ', Report.ErrorMessage);
    Exit;
  end;
  try
    { värdet är de råa byten för ett komplett PDF-objekt }
    Editor.UpsertName('invoice-2026-09',
      '<< /Type /Filespec /F (invoice.pdf) /EF << /F 42 0 R >> >>');
    Editor.RemoveName('draft-2025-11');
  finally
    { Editor.Free efter sparningen nedan }
  end;
end;
Postvärden förblir råa PDF-objektbytes
Ett postvärde lagras ordagrant, och det är det enda designbeslutet som gör editorn säker att peka på filer du inte producerat. TPdfTreeEntry håller NameKey, NumberKey och RawValue, och RawValue är den råa byte-serien av ett komplett PDF-objekt: en dictionary, en array, en sträng, en strömreferens eller en bar indirekt referens. Inget avkodas till en Delphi-variant, en TStrings eller en typad post. Vinsten är förlustfri rundtur av värden som enheten inte vet något om. En /Filespec med en vendor-extension, en destinationsarray med ett ovanligt fit-typ, en /JavaScript-actionsdictionary med privata nycklar, allt överlever en ombyggnad byte för byte, eftersom editorn aldrig hade någon åsikt om deras innehåll. Det krymper också modifierings-API:et till något bevisbart: UpsertName och UpsertNumber behöver bara verifiera att det levererade värdet parsar som exakt ett komplett objekt, och RemoveName, RemoveNumber och Clear rör bara postlistan
Hur byggs ett balanserat träd om utan att roten numreras om?
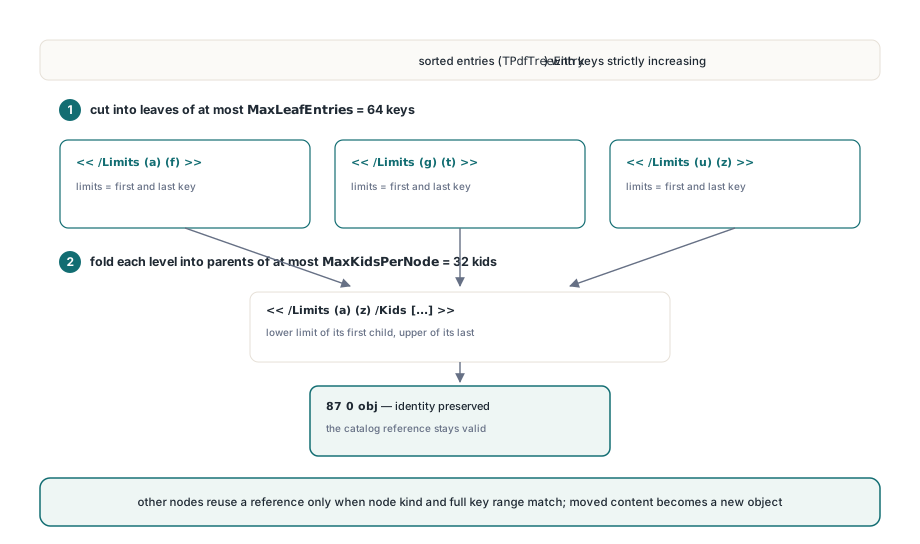
I två pass med en fixpunkt. BuildBalancedObjects skär först den sorterade postlistan i leaves på högst MaxLeafEntries, viker sedan varje nivå till föräldrar på högst MaxKidsPerNode och upprepar tills en enda nod återstår. Limits beräknas nedifrån och upp, en leaf tar sin första och sista nyckel, en intern nod tar den nedre limiten från sitt första barn och den övre från sitt sista, så överlappande syskonintervall kan inte uppstå per konstruktion
Fixpunkten är identitet. Den slutliga roten får alltid det objektnummer och den generation som trädet laddades med, så katalogreferensen förblir giltig och inget annat i dokumentet behöver skrivas om. Varje annan nod återanvänder referensen för en tidigare laddad nod bara när nodtypen matchar och hela nyckelintervallet matchar, och tar annars ett färskt nummer allokerat från det aktiva maximala objektnumret plus ett. Den kombinationen håller oförändrade underträd pekande på sina befintliga objekt samtidigt som den garanterar att varje nod vars innehåll flyttats skrivs som ett nytt objekt i stället för att tyst omtolkas. Samma referensåteranvändningsdisciplin driver outline-editorn och dess sidomappning i systerenheten
var
  Serialized: TPdfTreeSerializedObjects;
  I: Integer;
begin
  { FirstNewObjectNumber kommer från källrevisionen }
  if Editor.BuildBalancedObjects(MaximumObjectNumber + 1,
    Serialized, Report) then
  begin
    Writeln('nodes ', Report.NodeCount, ' depth ', Report.MaximumDepth);
    for I := 0 to High(Serialized) do
      Writeln(Serialized[I].Reference.ObjectNumber, ' ',
        Serialized[I].Reference.Generation, ' obj');
  end
  else
    for I := 0 to High(Report.Issues) do
      Writeln('issue ', Ord(Report.Issues[I].Kind), ' at obj ',
        Report.Issues[I].ObjectNumber, ': ', Report.Issues[I].Message);
end;
Skriv revisionen, läs sedan tillbaka resultatet
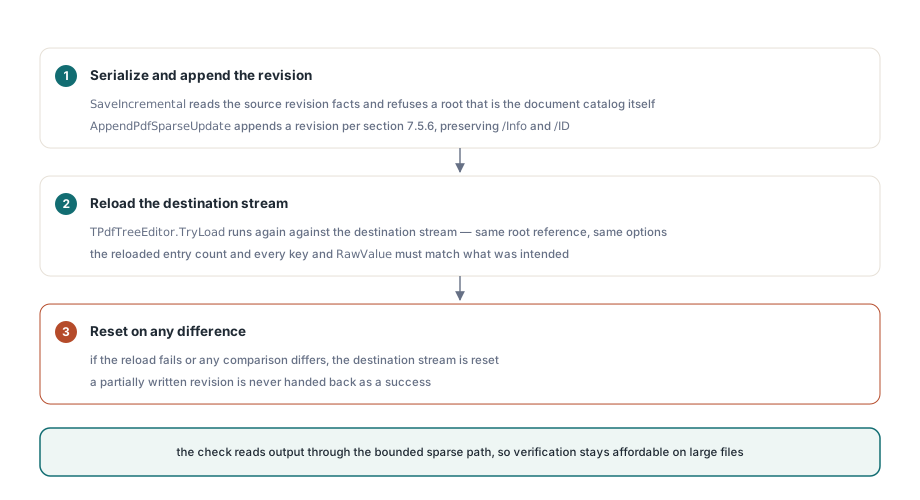
En sparning är bara klar när utdata har öppnats igen och jämförts. SaveIncremental läser källrevisionens fakta, vägrar en rot som är dokumentkatalogen själv, serialiserar den balanserade noduppsättningen plus katalogobjektet, och lämnar allt till AppendPdfSparseUpdate, som lägger till en ny revision enligt §7.5.6 samtidigt som den bevarar den befintliga /Info-referensen och dokumentets /ID-array
Sedan kommer delen som är värd att kopiera in i dina egna writers. Editorn anropar TPdfTreeEditor.TryLoad igen, den här gången mot destinationsströmmen, med samma rotreferens och samma options, och jämför det omladdade postantalet och varje nyckel och RawValue mot vad den tänkt skriva. Misslyckas omladdningen eller skiljer sig någon jämförelse återställs destinationsströmmen i stället för att returneras, så en delvis skriven revision lämnas aldrig tillbaka som en framgång. Verifieringen läser utdata genom samma begränsade sparse-sökväg som beskrivs i vår text om det sparse lazy PDF-objektindexet, vilket är det som håller kontrollen billig på stora filer
var
  Dest: TFileStream;
begin
  Dest := TFileStream.Create(OutputName, fmCreate);
  try
    if Editor.SaveIncremental(Source, Dest, Report) then
      Writeln('wrote ', Report.NodeCount, ' nodes, ',
        Report.EntryCount, ' entries')
    else
      { destinationen redan återställd, inget halvskrivet sparades }
      Writeln('save refused: ', Report.ErrorMessage);
  finally
    Dest.Free;
    Editor.Free;
  end;
end;
Krypterade källor avvisas, och det är ärligt
Den aktuella implementationen avvisar en krypterad källa rakt av. Anledningen är specifik snarare än defensiv: en trädombyggnad introducerar nya strängobjekt och kan introducera nya strömreferenser, och §7.6 kräver att de krypteras per objekt med dokumentnyckeln och det ägande objektnumret och generationen. Att kopiera /Encrypt-trailern framåt samtidigt som du lägger till klartextsträngar skulle producera en fil som öppnas och sedan läses som skräp precis där dina nya nycklar finns, vilket är värre än ett tydligt avvisande. Två ytterligare gränser är värda att säga rakt ut. Editorn arbetar på en ögonblicksbild av källströmmen, så källan får inte modifieras medan en editor lever över den, och den vägrar att behandla dokumentkatalogen som en trädrot, eftersom katalogen är en dictionary som råkar innehålla träd snarare än en trädnod i sig själv. Sköter du Delphi-, C++Builder- eller Lazarus-kod som skriver /EmbeddedFiles, /Dests, /JavaScript eller /PageLabels och du har patchat leaf-arrays för hand, så levereras trädeditorn och dess verifierade inkrementella sparning i PDFiumPas Delphi PDFium-komponenten