PDFium Component skriver text till en PDF-sida på glyfnivå med AddCidType2Text, och bäddar in TrueType-data du tillhandahåller som ett CID Type 2-typsnitt. Den tilldelar varje glyfinstans en sekventiell CID, genererar den explicita CID-till-GID-mappningen och ToUnicode-CMap:en, och slår ihop glyfer på samma baslinje till ett enda inbyggt textobjekt. Valfri delmängdsbildning håller filen liten, med en explicit policy för vad som händer när delmängdsbildningen misslyckas
Skrivning på glyfnivå är vad du behöver när texten redan har formats. Arabiska, devanagari och varje skriftsystem med kontextberoende former producerar en sekvens av glyfidentifierare som inte längre mappar en-till-en mot tecken, så ett API som tar en sträng och ett typsnittsnamn kan inte uttrycka resultatet. Att direkt lämna över glyfer och positioner är det enda sättet att få korrekt formad text i komplexa skriftsystem in i en PDF
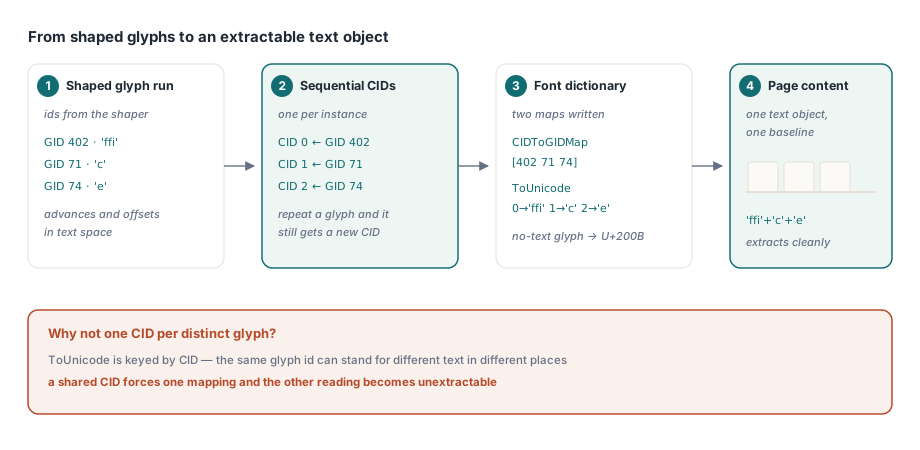
Varför varje glyfinstans får sin egen CID
Den lockande optimeringen är att avdublettera: en CID per unik glyfidentifierare, återanvänd varhelst den glyfen förekommer. Det ger ett mindre typsnitt och det bryter textextraktion, eftersom samma glyf legitimt kan motsvara olika Unicode-innehåll på olika ställen
En ligaturglyf är det tydliga fallet. Samma "ffi"-glyf kan stå för de tre tecknen i ett ord och, efter ett annat formningsbeslut, för något annat på ett annat ställe. ToUnicode-mappningen är nyckelbaserad på CID, så en delad CID kan bara bära en mappning, och vilken text som än förlorar den tävlingen blir oextraherbar
Så varje glyfinstans tar sin egen CID, och varje mappning är fri att vara flera UTF-16-kodenheter. En glyf utan meningsfull text — ett dekorativt element, en glyf enbart för positionering — mappas explicit till U+200B, ett nollbrett mellanslag, så att varje CID har ett observerbart extraktionsresultat snarare än ett hål
uses
  PDFium;

var
  Pdf: TPdf;
  Glyphs: TPdfCidGlyphs;
  Options: TPdfCidFontOptions;
  Report: TPdfCidFontReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'label.pdf';
    Pdf.LoadDocument;
    Pdf.PageNumber := 1;

    // En post per formad glyf: glyf-id:t, texten den representerar,
    // samt dess förskjutning och offset i textrymden
    SetLength(Glyphs, 3);
    Glyphs[0].GlyphID := 402;  Glyphs[0].UnicodeText := 'ffi';
    Glyphs[0].Advance := 18.4;
    Glyphs[1].GlyphID := 71;  Glyphs[1].UnicodeText := 'c';
    Glyphs[1].Advance := 9.8;
    Glyphs[2].GlyphID := 74;   Glyphs[2].UnicodeText := 'e';
    Glyphs[2].Advance := 9.2;

    Options := TPdfCidFontOptions.Default;   // subset preferred
    Options.VerifyExtraction := True;

    if Pdf.AddCidType2Text(LoadFileBytes('NotoSans.ttf'), Glyphs,
         11, 72, 700, Options, Report) then
      Writeln(Format('%d glyphs, %d unique, font %d -> %d bytes, match=%s',
        [Report.GlyphCount, Report.UniqueGlyphCount,
         Report.OriginalFontBytes, Report.EmbeddedFontBytes,
         BoolToStr(Report.ExtractionMatches, True)]));
  finally
    Pdf.Free;
  end;
end;
Delmängdsbildning, och de kontroller en returkod inte ger dig
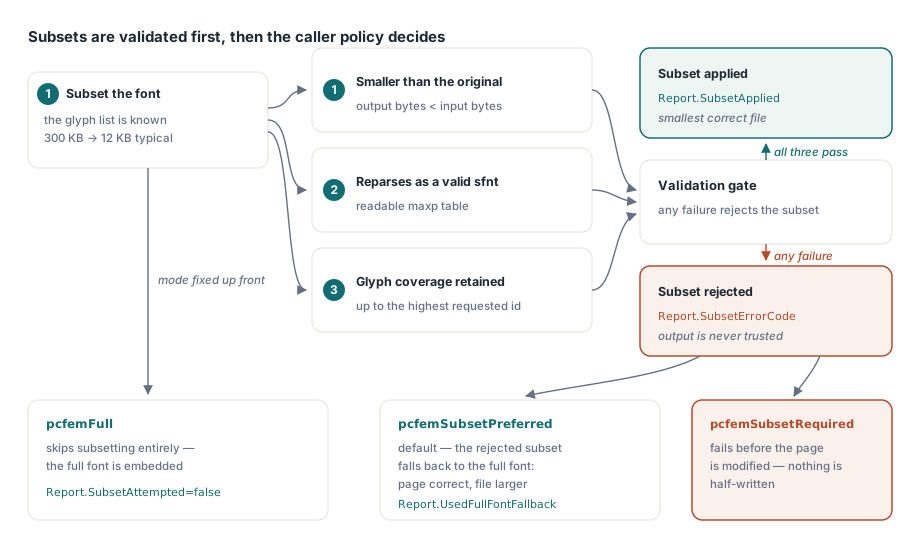
Att delmängdsbilda ett typsnitt till de glyfer som faktiskt används är skillnaden mellan att bädda in 300 KB och att bädda in 12 KB, och på ett dokument med flera typsnitt avgör det om filen går att e-posta. Plattformens delmängdsbildningsväg accepterar en glyflista direkt, vilket passar detta API perfekt eftersom anroparen redan känner till varje glyfidentifierare som används
Vad det inte ger dig är säkerhet. Ett delmängdsbildningsanrop kan rapportera framgång och returnera utdata som är oanvändbar, så komponenten validerar tre egenskaper innan resultatet accepteras: utdatan måste vara mindre än originalet, den måste tolkas om som en giltig sfnt med en läsbar maxp-tabell, och den måste behålla glyfer upp till den högsta ursprungliga identifieraren som begärts. Varje misslyckande betyder att delmängden avvisas
Vad som händer härnäst är anroparens policy. Under pcfemSubsetPreferred, standardvärdet, faller en avvisad delmängd tillbaka till att bädda in hela typsnittet, så sidan är korrekt och bara större. Under pcfemSubsetRequired misslyckas operationen innan sidan ändras, vilket är vad en storleksbegränsad pipeline vill ha. pcfemFull hoppar över delmängdsbildning helt. Rapporten talar om för dig vilken väg som togs via SubsetAttempted, SubsetApplied, UsedFullFontFallback och SubsetErrorCode
Verifiering som inte kan ge ett falskt positivt
Med VerifyExtraction aktiverat bekräftar komponenten att det den skrev kan läsas tillbaka. Det naiva sättet att göra det är att extrahera hela sidan och söka efter den förväntade strängen, och det är fel: en sida som redan innehöll den texten klarar kontrollen även när den nya texten skrevs felaktigt
Istället byggs textsidan om och de objekthandtag som infogats av detta anrop läses individuellt, i infogningsordning, och sammanfogas. Resultatet jämförs mot den förväntade texten, och rapporten exponerar båda strängarna tillsammans med det booleska värdet, så en avvikelse kan diagnostiseras snarare än bara upptäckas
Slå på det under utveckling och i varje pipeline där extraherbarhet är ett krav — sökbara arkiv, tillgänglighetsefterlevnad, nedströms textutvinning. Kostnaden är en omgjord textsida per anrop, vilket är varför det inte är påslaget som standard i täta loopar
Budgetar och atomärt misslyckande
Typsnittsbyte, glyfinstanser och Unicode-kodenheter begränsas var för sig innan allokering, och typsnittsformatet, TTC-indexet, glyfidentifierarintervallet och geometrivärdena valideras innan något skrivs. Geometrin måste vara ändlig, vilket låter uppenbart tills en formningsmotor ger dig en NaN-förskjutning från ett felformat typsnitt
Misslyckande är atomärt på sidnivå. Om typsnittsladdning, objektskrivning, innehållsgenerering eller extraktionsverifiering misslyckas tas varje objekt som infogats av det anropet bort i omvänd ordning och sidinnehållet återgenereras. Ett misslyckat anrop lämnar sidan som den var, inte med en halv textkörning på den
Var detta passar in i en textpipeline
Arbetsfördelningen är värd att ange rakt av. Formning — att omvandla tecken till positionerade glyfer — är inte detta API:s jobb; det hör till en formningsmotor, och komponentens egna stöd för bidirektionell text och komplexa skriftsystem täcks i hantering av emoji, CJK och surrogatpar. Det här API:et är vad du anropar efteråt, med den glyfkörning formningsmotorn producerade
För vanlig latinsk text utan kontextberoende formning är de enklare strängbaserade text-API:erna rätt verktyg och ger mindre kod. Ta till CID Type 2-skrivning när du har formad utdata, när du behöver exakt kontroll över glyfidentifierare, eller när typsnittet måste bäddas in från byte du redan har snarare än lösas upp via namn — typsnittsupplösningsalternativet är leverantörsmekanismen som beskrivs i att styra PDF-typsnittssubstitution
En driftsättningsanmärkning: att bädda in ett typsnitt är lika mycket en licensfråga som en teknisk fråga. Typsnitt varierar i om inbäddning är tillåten alls, tillåten enbart för visning, eller tillåten för redigering. Biblioteket bäddar in vilka byte du än ger det, och att kontrollera licensen är ditt ansvar, inte filformatets
Textskrivning på glyfnivå, typsnittsförsörjning och textextraktion delar samma sidmodell i Delphi, C++Builder och Lazarus; det fullständiga API:et beskrivs på sidan för PDFium Component för Delphi