PDF är inget dokumentformat på det sätt Word eller RTF är. De formaten lagrar en sekvens av innehåll som en renderare tolkar i visningsögonblicket, så utdatan beror på vilka typsnitt och vilken layoutmotor som råkar finnas. PDF lagrar resultatet av den processen: exakta renderingsinstruktioner, typsnittsprogram, komprimerade bildströmmar och en objektgraf som knyter ihop dem till en självförsörjande beskrivning av varje sida. Filen bär tillräckligt med information för att återge varje sida identiskt i varje regelrätt renderare, vilket både är dess främsta designmål och källan till det mesta av den komplexitet du möter när du försöker generera, tolka eller ändra en programmatiskt
Objektmodellen
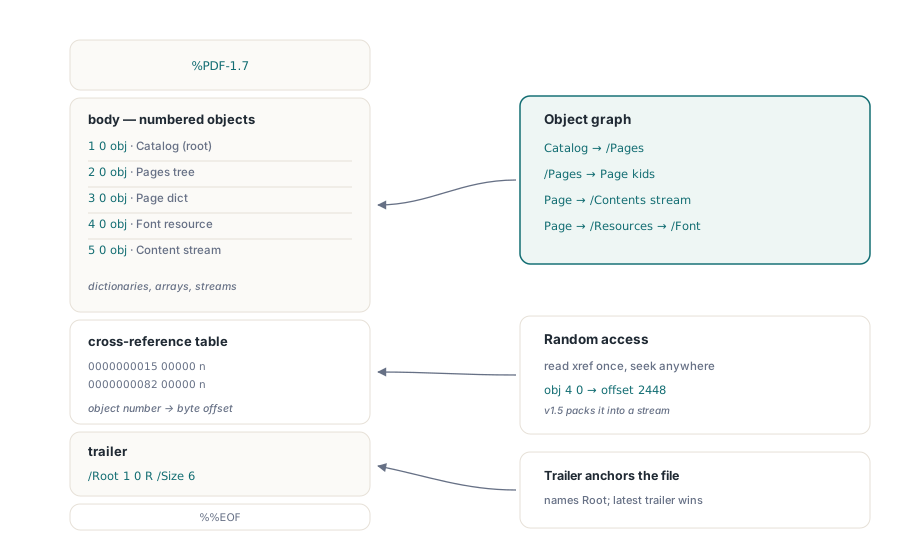
Varje PDF är en samling numrerade objekt. Ett objekt kan vara en boolean, ett heltal, ett reellt tal, ett namn, en sträng, en array, en ordbok, en ström eller null. Nästan allt intressant är en ordbok, vilket är en uppsättning nyckel-värde-par där nycklar är namn och värden är vilken annan objekttyp som helst, inklusive referenser till andra objekt via nummer och generationsantal. En ström är en ordbok följd av en bytesekvens, typiskt komprimerad
Katalogordboken är roten. Den pekar på sidträdet, som organiserar sidordböckerna i en balanserad trädstruktur snarare än en platt lista, så att navigera till sida 5 000 i ett dokument på 10 000 sidor kräver inte att varje föregående sidbeskrivning gås igenom. Varje sidordbok refererar till sina innehållsströmmar (en eller flera sekvenser av sidbeskrivningsoperatorer), sin resursordbok (som i sin tur refererar till typsnittsbeskrivare, färgrymder och bild-XObject), och sin mediaruta (den koordinatrymd sidan bor i). Koordinatorigo ligger i nedre vänstra hörnet, med positiv Y uppåt, i enheter om 1/72 tum
I slutet av filen sitter korsreferenstabellen, som mappar varje objektnummer till dess byteoffset i filen. Det är detta som möjliggör direktåtkomst: en visare läser korsreferenstabellen först, och söker sedan direkt till vilka objekt den än behöver. PDF 1.5 införde korsreferensströmmar, som komprimerar tabellen till ett strömobjekt och packar besläktade objekt i objektströmmar, vilket märkbart minskar filstorleken för dokument med många små objekt
Innehållsströmmar och grafikmodellen
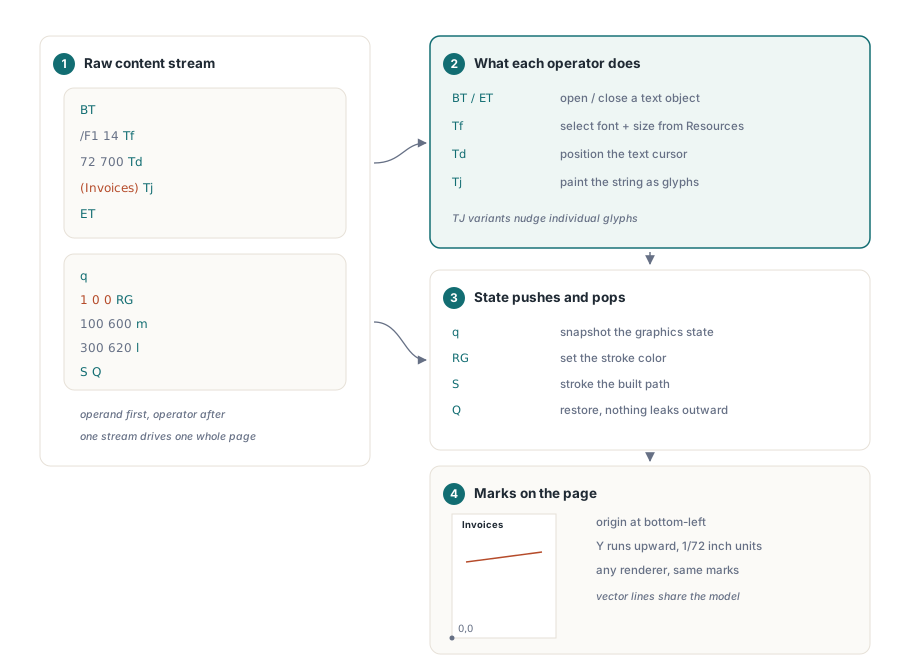
En sidas visuella innehåll bor i en eller flera innehållsströmmar. Varje ström är en sekvens av PDF-operatorer varvade med sina operander. Textoperatorn BT inleder ett textobjekt, Tf väljer typsnitt och storlek ur resursordboken, Td placerar textmarkören, Tj eller TJ målar en sträng, och ET stänger textobjektet. Vektorgrafik följer ett liknande mönster: m sätter en banas startpunkt, l lägger till ett linjesegment, c lägger till en Bézier-kurva, och f eller S fyller eller streckar banan
Grafiktillståndet styr allt som händer mellan operatorer: aktuell transformationsmatris, linjebredd, färgrymd, fyllfärg, streckfärg och klippbanan. Operatorer som q och Q lägger på och tar av grafiktillståndet på en stack, vilket är hur PDF implementerar lokala koordinattransformationer och tillfälliga tillståndsåsidosättanden utan att påverka sammanhanget runt dem. Form-XObject generaliserar detta: en självförsörjande innehållsström med sin egen resursordbok som kan målas på en sida vid godtyckliga positioner och skalor med en enda Do-operator
Inbäddning av typsnitt och textextraktion
PDF kan referera till typsnitt vid namn och förlita sig på att visaren byter ut något, men i praktiken måste varje dokument du tänker dela bädda in typsnittsdatan. Ett Type 1- eller TrueType/OpenType-typsnitt inbäddat i en PDF bär en typsnittsbeskrivarordbok som pekar på en typsnittsfilström. För TrueType-typsnitt innehåller den strömmen det binära typsnittsprogrammet; för Type 1 är det PFB-datan. Delmängdsuttag, som varje seriös PDF-generator gör, skalar bort glyfer som dokumentet inte refererar till, vilket håller filstorlekarna hanterbara även för stora Unicode-typsnitt
Textextraktion är där inbäddningen av typsnitt biter tillbaka. Ett teckens visuella representation bestäms av en glyf i det inbäddade typsnittsprogrammet. Teckenets Unicode-värde bestäms av en ToUnicode-CMap-ström fäst vid typsnittsordboken. När ToUnicode-CMap:en saknas eller är felaktig kan en PDF-visare rendera text läsbart men inte extrahera den som meningsfull Unicode, vilket är varför kopiering och inklistring från vissa PDF-filer ger skräp. Taggad PDF (ISO 32000 §14.8) lägger till ett andra lager: ett logiskt strukturträd som mappar sidinnehåll till dokumentsemantiska roller som stycken, rubriker och tabellceller. Skärmläsare och ombrytningsmotorer använder strukturträdet snarare än innehållsströmmens råa ordning, vilket förklarar varför en visuellt välsatt PDF ändå kan vara otillgänglig om taggningen saknas eller är fel
Inkrementella uppdateringar och digitala signaturer
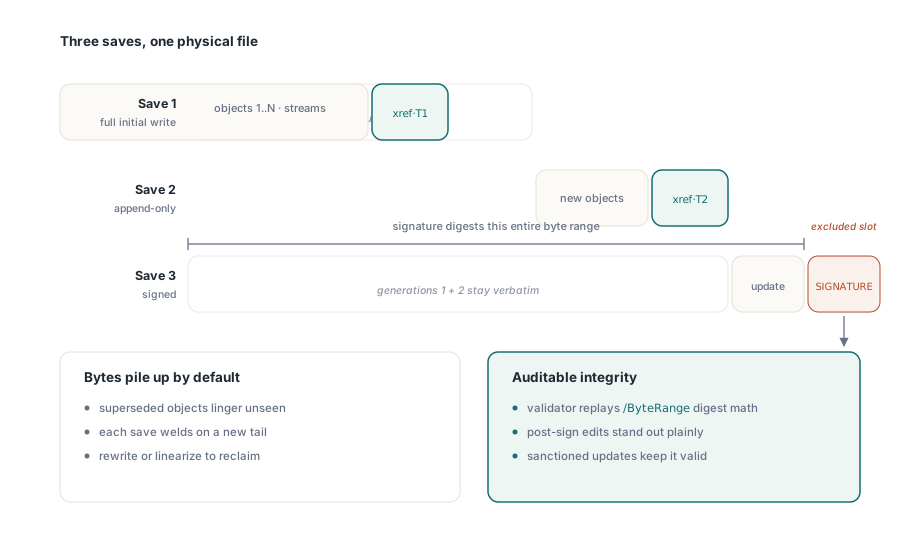
När du sparar ändringar i en befintlig PDF utan att skriva om den från grunden läggs de nya objekten till efter den ursprungliga filkroppen tillsammans med en ny korsreferenssektion och en ny trailerordbok. Den uppdaterade trailern pekar på den nya korsreferensdatan, och ersatta objekt blir kvar i filen men refereras helt enkelt inte av den nya korsreferenskedjan. Det här är inkrementell uppdatering, och den har två betydande följder
För det första växer filen med varje sparcykel. Ett dokument som redigerats och sparats upprepade gånger ackumulerar lager av föråldrade objekt. Verktyg som QPDF kan linjärisera eller komprimera-och-skriva-om en fil för att återta det utrymmet, men standarden är ackumulering. För det andra beror digitala signaturer på inkrementella uppdateringar för sin integritetsmodell. En signatur enligt ISO 32000 täcker ett byteintervall av filen, typiskt allt utom platshållaren för själva signaturvärdet. Alla ändringar efter signeringen som dyker upp som ytterligare inkrementella uppdateringar är synliga för en validerande läsare som ändringar gjorda efter signeringen, vilket är precis det spår du vill ha. Det betyder dock också att vissa ändringar, såsom att lägga till en godkännandesignatur eller fylla i formulärfält, uttryckligen tillåts av standarden utan att ogiltigförklara den ursprungliga signaturen, förutsatt att ändringarna följer dokumentets behörighetsinställningar (ISO 32000-2 §12.7.6). En ändring som faller utanför de behörigheterna flaggas som obehörig. Att få den skillnaden rätt spelar roll när du genererar dokument som ska motsigneras nedströms
Konformitetsnivåer och ISO 32000-släktskapet
PDF började som ett proprietärt Adobe-format 1993, absorberade PostScripts bildmodell, och samlade över femton versioner på funktioner: kryptering i 1.1, interaktiva formulär i 1.2, digitala signaturer och logisk struktur i 1.3, transparens i 1.4, objektströmmar i 1.5, AES-kryptering i 1.6. Adobe lämnade in PDF 1.7 till ISO 2007, och ISO 32000-1:2008 blev resultatet. ISO 32000-2:2020 täcker PDF 2.0, som stramade upp flera underspecificerade områden, reviderade nyckelhärledningen för AES-256 (revision 6 ersätter revision 5), och lade till uttryckligt stöd för associerade filer och rika media
Understandarderna härrör ur samma bas. PDF/A (ISO 19005) byter funktioner mot arkivstabilitet: ingen kryptering, inga beroenden av externt innehåll, alla typsnitt inbäddade, enhetsoberoende färgrymder, XMP-metadata obligatoriskt. PDF/A-1 bygger på PDF 1.4, PDF/A-2 på PDF 1.7, PDF/A-3 tillåter inbäddade filer av vilket format som helst. PDF/X (ISO 15930) är delmängden för tryckproduktion: utdataavsikter, utfalls- och skärrutor, ingen transparens i äldre konformitetsnivåer. PDF/UA (ISO 14289) föreskriver taggad struktur, Unicode-mappningar och språkmetadata för tillgänglighet. De är inga konkurrerande format; de är uppsättningar av ytterligare begränsningar ovanpå kärn-PDF, och en enda fil kan följa mer än en samtidigt förutsatt att begränsningarna inte krockar
För var och en som skriver kod som genererar eller bearbetar PDF är den praktiska baslinjen ISO 32000-2 med noggrann uppmärksamhet på avsnitten om korsreferensmodellen (§7.5), grafiktillståndet (§8.4), texttillståndsoperatorerna (§9.3), typsnittsbeskrivare och ToUnicode (§9.6 och §9.10), interaktiva formulär (§12.7) och digitala signaturer (§12.8). Standarden är lång, men det mesta programmatiska PDF-arbetet rör en smal skiva av den om och om igen. Att förstå objektmodellen och korsreferensmekanismen är ingången; allt annat är specialisering därifrån