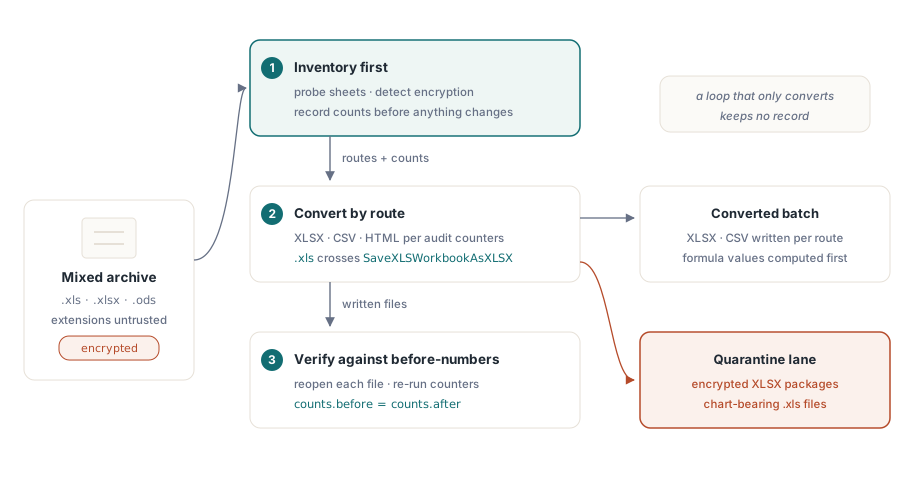
Ett bulk-normaliseringsjobb för kalkylblad är egentligen tre problem i en och samma kappa. Du har ett arkiv med blandade format: BIFF-tidens .xls, modern .xlsx, en spridning av .ods från något LibreOffice-experiment, och en handfull filer ingen kan öppna eftersom lösenordet lämnade huset med en före detta anställd. Målet är att konvertera allt till XLSX och CSV. Den version av det jobbet de flesta skriver är en loop som öppnar varje fil och sparar den under en ny filändelse, och det fungerar precis tills någon frågar vilka filer som tappade sina diagram, kastade sina makron, eller aldrig öppnades alls. Loopen har inget svar, eftersom konvertering ensam inte för något register. En verkstad gör det: den inventerar först, konverterar sedan, och verifierar sist, och de tre stegen måste dela information för att något av det ska vara pålitligt
Att sätta ihop den verkstaden i Delphi eller C++Builder betyder att koppla samman fyra HotXLS-förmågor, ingen av vilka behöver Excel installerat någonstans i pipelinen. Det finns två nativa motorer, en BIFF8-fasad för .xls och en OOXML-fasad för .xlsx och .ods. Det finns billiga sonderingsanrop som läser metadata utan att tolka hela filen. Det finns granskningsräknare per blad som talar om vad en arbetsbok faktiskt innehåller. Och det finns en konverteringsmatris med en dokumenterad fidelitetsprofil för varje väg. Arbetet ligger i att veta var var och en av dem har en skarp kant, för det har de alla, och kanterna är precis det som förvandlar en ren nattlig batch till en måndagsmorgonincident
Sondera innan du laddar: bladnamn och krypteringsdetektering
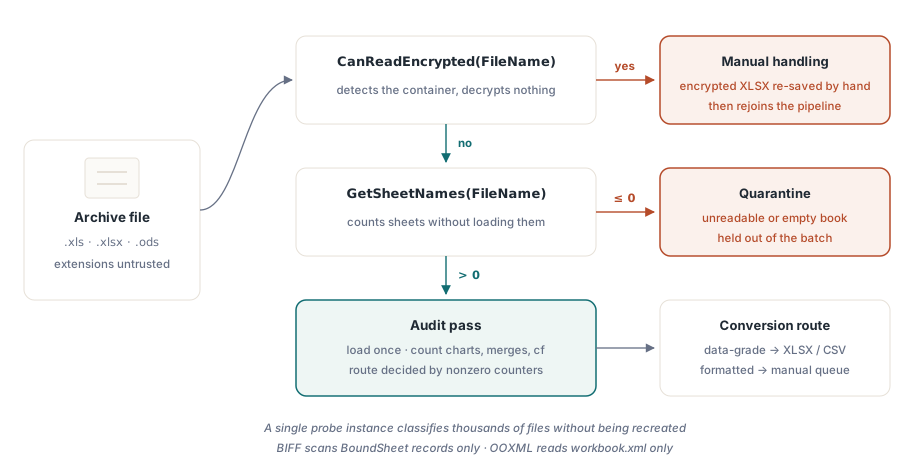
Att öppna en 200 MB arbetsbok bara för att upptäcka att den är krypterad slösar minuter per fil, och multiplicerat över ett stort arkiv slösar det dagar. Båda fasaderna exponerar GetSheetNames, som läser bladmetadata utan att fylla arbetsboken. BIFF-implementationen skannar bara BoundSheet-posterna längst fram i strömmen; OOXML-implementationen läser bara workbook.xml inuti zippen. Bredvid den upptäcker CanReadEncrypted en krypteringsbehållare utan att försöka dekryptera:
var
  Probe: TXLSXWorkbook;
  Names: TStringList;
begin
  Names := TStringList.Create;
  Probe := TXLSXWorkbook.Create;
  try
    if Probe.CanReadEncrypted(FileName) then
    begin
      Writeln(FileName + ': encrypted container - route to manual handling');
      Exit;
    end;
    if Probe.GetSheetNames(FileName, Names) <= 0 then
      Writeln(FileName + ': unreadable - quarantine')
    else
      Writeln(Format('%s: %d sheet(s), first "%s"',
        [FileName, Names.Count, Names[0]]));
  finally
    Probe.Free;
    Names.Free;
  end;
end;
Två driftsdetaljer gör den här loopen billig. GetSheetNames återställer eller fyller inte arbetsboksinstansen, så ett enda sonderingsobjekt kan klassificera tusentals filer utan att återskapas. Och XLS-fasadens version av samma anrop förstår också .xlsx-paket, vilket gör den till en bekväm enda sondering när filändelser inte kan lita på, vilket de sällan kan i ett arkiv så gammalt. Triage före laddning är värt sin egen behandling; mekaniken för lättviktig inspektion finns i vår artikel om bladlistning och lättviktig arbetsboksinspektion
Att räkna vad en arbetsbok faktiskt innehåller
När en fil väl klarar triage avgör granskningspasset dess konverteringsväg. XLSX-fasaden exponerar en räknare för varje funktionsfamilj som påverkar ett fidelitetsbeslut: sammanslagna celler, diagram, bilder, villkorlig formatering, datavalideringar, tabeller, hyperlänkar och kommentarer, plus flaggor på arbetsboksnivå för makron, skydd och källformat. Konverteringsvägen för en fil beror nästan helt på vilka av dessa som kommer tillbaka skilda från noll
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  I: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    if Book.Open(FileName) <> 1 then Exit;
    for I := 0 to Book.Sheets.Count - 1 do
    begin
      Sheet := Book.Sheets[I];
      Writeln(Format('%s: cells=%d merges=%d charts=%d cf=%d dv=%d protected=%s',
        [Sheet.Name, Sheet.Cells.Count, Sheet.MergedCells.Count,
         Sheet.Charts.Count, Sheet.ConditionalFormats.Count,
         Sheet.DataValidations.Count, BoolToStr(Sheet.IsProtected, True)]));
    end;
    if Book.HasVbaProject then
      Writeln('  contains VBA project - macro policy applies');
    if Book.ExternalLinks.Count > 0 then
      Writeln(Format('  %d external link(s)', [Book.ExternalLinks.Count]));
  finally
    Book.Free;
  end;
end;
Läs Cells.Count med en förbehåll i åtanke. Cellagret är glest, så talet räknar instansierade celler, inte den rektangulära arean av det använda området. Ett blad med ett värde i A1 och ett annat i ZZ9999 rapporterar två celler, inte de dryga miljonen som ligger mellan dem. Motsvarande skanning på BIFF-sidan använder UsedRange-gränser tillsammans med ForEachCell, och den bär avvikelsen-med-ett som snubblar nästan alla första gången: UsedRange.FirstRow och dess syskon är 0-baserade, medan Cells.Item[Row, Col] är 1-baserat. En genomgång som glömmer att lägga till ett till varje gräns granskar fel rektangel och säger aldrig något om det
Två spakar skär kostnaden för ett rent granskningspass över stora äldre filer. Att sätta _DisableGraphics till true innan en .xls öppnas hoppar över hela OfficeArt-ritlagerstolkningen, vilket sparar verklig tid på arbetsböcker täta med former. Det är dock strikt en skrivskyddad optimering: att spara från en instans öppnad på det sättet skulle kasta bort ritningarna den aldrig tolkade, så flaggan hör bara hemma på vägar som aldrig kommer att skriva tillbaka filen. När granskningen behöver cellinnehåll per cell snarare än antal, går callbacken ForEachCell igenom de befolkade cellerna direkt och kringgår omkostnaden per åtkomst som indexerade cellegenskaper betalar vid varje läsning av typen Variant, vilket ackumuleras snabbt över miljontals celler
Normalisera de inkonsekventa returkoderna tidigt
HotXLS I/O-anrop rapporterar fel via heltalsresultat snarare än undantag, och konventionerna är inte enhetliga över API:et. De flesta öppnings- och sparningsanrop returnerar 1 vid framgång och -1 vid misslyckande. GetSheetNames returnerar bladantalet, eller -1 med listan tömd. XLSX SaveAsHTML bryter mönstret igen och returnerar 0 vid framgång, -1 för ett bladindex utanför intervallet. En verkstad som testar = 1 överallt kommer tyst att felklassificera anropen som signalerar framgång på något annat sätt, och en som testar <> -1 kommer att svälja de som misslyckas med en annan kod
Regeln som överlever kontakt med hela API:et är smalare än den ser ut: behandla <= 0 som misslyckande för antal-returnerande anrop, kontrollera det dokumenterade framgångsvärdet för varje sparningsrutin du faktiskt använder, och lägg båda bakom en enda liten resultatkontrollerande funktion så att konventionen bor på exakt en plats. Batchpipelines misslyckas mycket oftare från en långsam anhopning av okontrollerade returkoder än från någon exotisk parserbugg, och kostnaden för att ha fel om det här kommer fyrtiotusen filer senare, när ingen längre minns vilka konverteringar som faktiskt tog
Konverteringsmatrisen och var varje väg tappar data
De två fasaderna delar konverteringsarbetet mellan sig. TXLSXWorkbook öppnar XLSX, ODS och CSV, och sparar XLSX, ODS, CSV, HTML, RTF och AES-krypterad XLSX. TXLSWorkbook öppnar och sparar BIFF, och exporterar HTML, RTF och CSV. Det användbara är att varje väg kommer med en dokumenterad fidelitetsprofil, inte ett vagt löfte om korrekthet, så du kan bestämma i förväg vilka vägar som är säkra för vilka filer
CSV-export skriver UTF-8 med en BOM, CRLF-radslut och RFC 4180-citering. Vad den inte gör är att utvärdera formler: en cell som håller =SUM(...) exporteras som den bokstavliga formeltexten, så ett blad med formler förvandlas till ett blad med strängar om du inte beräknar värdena först. HTML-export producerar en enda tabell, med colspan och rowspan som ställföreträdare för sammanslagna celler och grundstilar inbäddade. RTF-export har en skarpare gräns: den kan inte spänna sammanslagna celler över kolumner, så en sammanslagnings fortsättningsceller kommer ut tomma. ODS-import är lättviktig med avsikt, enligt bibliotekets egen dokumentation. Skalära värden och cachade formelresultat kommer igenom; stilar, levande ODF-formeluttryck och ritningar gör det inte. Det spelar roll i samma stund arkivet innehåller riktiga OpenDocument-filer styrda av OASIS ODF 1.3, där allt i närheten av en visuellt trogen konvertering behöver mer än den här importvägen byggdes för att bära, och granskningspasset är vad som talar om för dig att de filerna finns innan batchen tyst plattar till dem
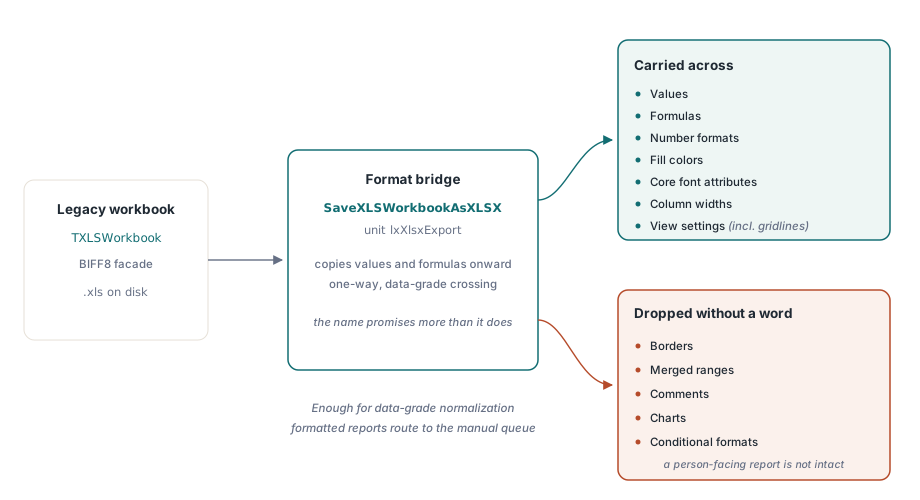
SaveXLSWorkbookAsXLSX är en databro, inte en layoutbro
BIFF-fasaden kan inte skriva OOXML direkt, så övergången från .xls till .xlsx går via funktionen SaveXLSWorkbookAsXLSX i enheten lxXlsxExport. Den brons fidelitet är värd att säga rakt ut, eftersom namnet antyder mer än den gör. Den kopierar värden, formler, talformat, fyllnadsfärger, grundläggande typsnittsattribut, kolumnbredder och visningsinställningar som rutnätslinjer. Den kopierar inte ramlinjer, sammanslagna områden, kommentarer, diagram eller villkorlig formatering. För databaserad normalisering, där nedströmssystem kommer att tolka resultatet och ingen tittar på formateringen, är det precis tillräckligt och inget går förlorat som någon behöver. För en formaterad styrelserapport avsedd att läsas av en människa är det inte tillräckligt, och det är precis här granskningsräknarna förtjänar sin plats: en fil granskningen flaggade som bärande diagram och villkorlig formatering bör routas till en manuell kö, inte genom en bro som kommer att kasta bort båda utan ett ord
var
  Legacy: IXLSWorkbook;        // gränssnittsreferens: anropa inte Free
  Modern: TXLSXWorkbook;
begin
  if SameText(ExtractFileExt(FileName), '.xls') then
  begin
    Legacy := TXLSWorkbook.Create;
    if Legacy.Open(FileName) <= 0 then Exit;
    if SaveXLSWorkbookAsXLSX(Legacy,
         ChangeFileExt(FileName, '.xlsx')) <= 0 then
      Writeln('bridge failed: ' + FileName);
  end
  else
  begin
    Modern := TXLSXWorkbook.Create;
    try
      Modern.StreamingWrite := True;     // strömma bladets XML in i zippen
      if Modern.Open(FileName) = 1 then
        Modern.SaveAsCSV(ChangeFileExt(FileName, '.csv'), 0, ',');
    finally
      Modern.Free;
    end;
  end;
end;
Loopen ovan visar också genomströmningsspaken på OOXML-sidan. Att sätta StreamingWrite till true strömmar kalkylblads-XML direkt in i utdatapaketet i stället för att iscensätta den som en enda jättesträng i minnet, vilket är skillnaden mellan en bekväm körning och en minneskrasch när filer når hundratusentals rader. Storleksbestämning och minnesbeteende för det läget får sin egen behandling i vår artikel om strömmande skrivning för serverbatchjobb. Ytterligare en egenskap spelar roll för en batch som vill använda varje kärna: ingen av fasaderna är trådsäker, men ingen delar heller globalt tillstånd, så det stödda mönstret för parallell konvertering är en arbetsboksinstans per arbetartråd, utan låsning mellan dem
Lösenordsfilerna, och vad man ska göra med dem
Arkivets låsta filer delas rent efter format, och uppdelningen avgör vart de går. Äldre .xls-kryptering, oavsett om det är RC4, RC4 över CryptoAPI, eller den gamla XOR-förvrängningen, går att läsa: skicka lösenordet till Open och filen konverteras som vilken annan som helst. Krypterade .xlsx-paket är en annan historia. HotXLS upptäcker dem med CanReadEncrypted men kan inte dekryptera dem, så det enda ärliga draget är att routa dem till en kö där en människa öppnar och sparar om varje en i Excel innan den återförenas med pipelinen. Den asymmetrin är värd att designa för i förväg, eftersom de krypterade XLSX-filerna är de mest sannolika att vara posterna någon faktiskt bryr sig om
Att sluta loopen med verifiering
Det tredje steget är det som hoppas över, och att hoppa över det är vad som förvandlar en bulkkonvertering till en skuld. Ingen sparväg i HotXLS utvärderar formler. Excel beräknar om när det öppnar en fil, så en XLSX-till-XLSX-konvertering förblir korrekt, men ett CSV-mål tar emot formeltexten ordagrant om inte pipelinen först kör Calculate på cellerna och skriver tillbaka resultaten. Att veta det i förväg är skillnaden mellan en CSV full av tal och en CSV full av =SUM(...)-strängar som ingen märker förrän en nedströmsimport fastnar på dem
Verifiering i sig är billig nog att det inte finns någon ursäkt för att utelämna den. Öppna varje konverterad fil igen med samma bibliotek, kör granskningsräknarna igen, och jämför dem mot förkonverteringssiffrorna inventeringspasset redan registrerade. Ett bladantal som sjönk, ett diagramantal som gick till noll där källan hade tre, ett cellantal som föll utför ett stup: var och en är en tyst förlust fångad till priset av en andra öppning. Stickprovskontrollera ett urval med ögat i Excel eller LibreOffice utöver det, och kombinationen fångar den överväldigande majoriteten av konverteringsskador innan de levereras. Det här är hela anledningen till att inventeringssteget matar verifieringssteget. Utan för-siffrorna bevisar efter-siffrorna ingenting
En granskning-först-verkstad förvandlar en riskabel bulkkonvertering till en mätbar process med en karantänkö för filerna som inte kan klara sig rent. Alla sonderings-, räknings- och konverteringsanrop som visas här är en del av HotXLS Delphi Component, som kör dem nativt in-process utan Excel-automation