HotXLS Delphi Excel Component behåller OpenDocument-datapilottabeller genom en öppna-och-spara-cykel för ODS genom att fånga delträdet <table:data-pilot-tables> i content.xml ordagrant vid öppning och spela upp det vid sparning, sedan v2.382.0. Sedan v2.382.1 bär fragmentet dessutom varje XML-namnrymdsbindning som dess förfäder deklarerade, så den sparade pivotdefinitionen förblir välformad för vilken konsument som helst, inte bara för HotXLS
Buggen som tvingade fram båda ändringarna kom ur en strikt korpuskörning. Exemplet official-pivot.ods, skrivet av en utvecklingsbuild av LibreOffice 6.1, innehåller en pivot med namnet DataPilot1 som läser Sheet1.A2:E30 och lägger sitt resultat i Sheet1.G6:J18. Öppna den med HotXLS, spara den oförändrad, räkna elementen <table:data-pilot-table> i utdata: en in, noll ut, på Win32 och Win64 likadant. Inget i testet rörde pivoten. Den första omgången sonder jämförde bara cellkonstanter och gick igenom; det strukturella påståendet var det som avslöjade förlusten, vilket är en påminnelse om att "värden stämmer" är en svag definition av rundresetrohet
Varför försvinner en ODS-pivottabell efter en sparning med biblioteket?
En ODS-pivottabell försvinner för att HotXLS inte har någon minnesmodell för OpenDocument-datapilottabeller, och ODS-skrivaren bygger content.xml helt ur modellen. Skrivaren sätter ihop automatiska stilar, en <table:table> per kalkylblad, <table:content-validations>, <table:named-expressions> och <table:database-ranges>, var och en genererad från objekt som arbetsboken faktiskt håller. En pivotdefinition — ODF 1.3 Part 3 §9.6, en behållare <table:data-pilot-tables> med en <table:data-pilot-table> per pivot, som bär sin table:source-cell-range, sina table:data-pilot-field-barn, sin table:target-range-address och table:buttons — har inget objekt att bo i, så den regenererade delen utelämnar den helt enkelt
Kontrasten mot XLSX är avsiktlig. HotXLS parsar SpreadsheetML-pivotcachar och pivottabeller till en riktig modell som du kan bygga, utöka med beräknade fält och uppdatera från Delphi, så de överlever en sparning eftersom de skrivs om och inte kopieras. ODS-pivoter är en mycket ovanligare förfrågan, och att modellera ODF:s datapilotvokabulär bara för rundresans skull skulle bli en massa kod som ingen redigerar. Det pragmatiska svaret är detsamma som HotXLS redan tillämpar på okända extLst-block i XLSX: behåll det du inte modellerar, byte för byte om du kan, händelse för händelse om du inte kan
Vad gjorde den första Pos-baserade fångsten fel?
Fångsten i v2.382.0 skar ut pivotdefinitionen ur content.xml som en vanlig sträng, och snittet saknade de namnrymdsdeklarationer som gjorde den meningsfull. Implementationen var så kort som det låter — avkoda delen till en WideString, hitta öppningstaggen med Pos, hitta stängningstaggen efter den, kopiera spannet in i FRawOdsDataPilotTablesXml på arbetsboken:
// HotXLS v2.382.0 -- ersatt en release senare
function OdsCaptureDataPilotTablesXml(Stream: TStream): WideString;
const
  OpenTag: WideString = '<table:data-pilot-tables';
  CloseTag: WideString = '</table:data-pilot-tables>';
var
  Text: WideString;
  StartPos, ClosePos: Integer;
begin
  Result := '';
  Text := LoadPartAsWideString(Stream);   // hela content.xml i minnet
  StartPos := Pos(OpenTag, Text);
  if StartPos = 0 then Exit;
  ClosePos := Pos(CloseTag, Copy(Text, StartPos, MaxInt));
  if ClosePos = 0 then Exit;
  Result := Copy(Text, StartPos, ClosePos + Length(CloseTag) - 1);
end;
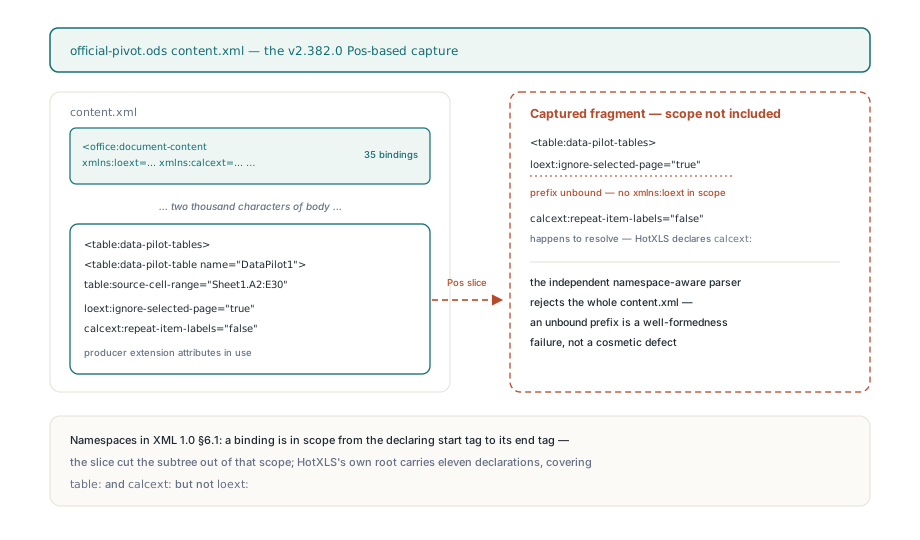
Räkne-påståendet blev grönt, och fixen släpptes. Det som fångade den var en andra, striktare kontroll som lades till samma dag: varje XML-del i det sparade paketet matas till en oberoende namnrymdsmedveten parser utanför HotXLS, och den parsern avvisade den nya content.xml med ett fel om obundet prefix. Pivoten från LibreOffice bär tillverkarspecifika tilläggsattribut — loext:ignore-selected-page="true" på ett sidfält, calcext:repeat-item-labels="false" på varje nivå — och den utskurna strängen innehöll de attributen men inte deklarationerna xmlns:loext och xmlns:calcext som band dem. De deklarationerna satt på källfilens rot <office:document-content>, trettiofem stycken, tvåtusen tecken bort från pivoten
W3C Namespaces in XML 1.0 §6.1 definierar regeln som gör detta till ett hårt fel i stället för ett kosmetiskt: en namnrymdsdeklaration gäller från starttaggen för elementet den står på till det elementets sluttagg, och varje prefixat namn inom det omfånget löses upp mot den. Skär du ut ett delträd ur dokumentet skär du ut det ur omfånget. HotXLS skriver sin egen rot <office:document-content> med elva deklarationer — office, table, text, style, number, fo, draw, svg, xlink, calcext, tableooo — så calcext: råkade lösas upp, table: råkade lösas upp, och loext: gjorde det inte. En namnrymdsmedveten parser behandlar ett obundet prefix som ett välformhetsbrott, vilket betyder att hela delen är oläsbar, inte bara ett attribut
Hur bär HotXLS ärvda xmlns-bindningar över till fragmentet?
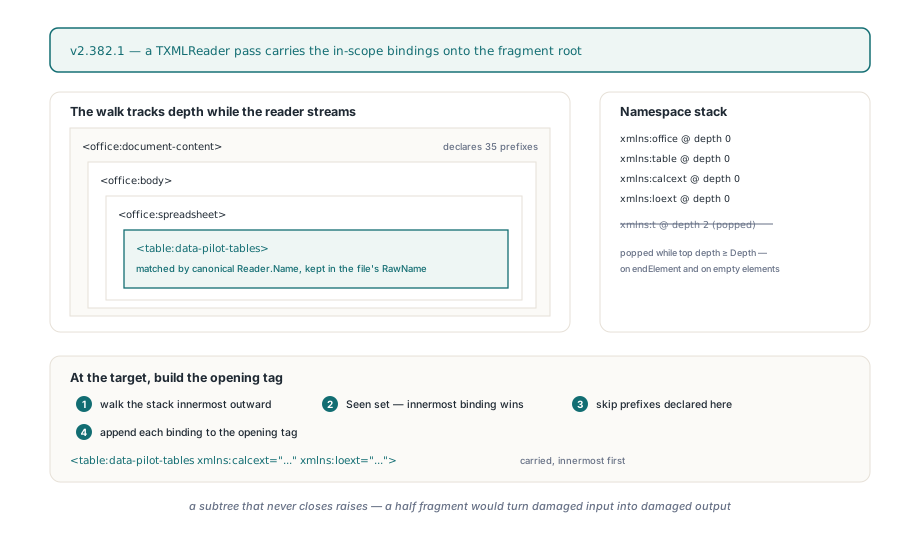
HotXLS v2.382.1 ersatte strängsnittet med en genomgång av content.xml via sin egen strömmande TXMLReader, som håller en stack av namnrymdsbindningar märkta med djupet där var och en deklarerades, och kopierar de bindningar som fortfarande gäller över till fragmentets rotelement i samma stund målet nås. Läsaren kör med PreserveWhitespaceText aktiverat så att textnoder kommer tillbaka exakt som skrivna, och de återuppbyggda taggarna använder TXMLReader.RawName och TXMLReader.Attribute[I].RawName — prefixstavningen från filen — i stället för de kanoniska namn som läsaren normalt lämnar till delparserna. Här är kärnan i loopen:
// Namespaces: TStringList med 'xmlns:p=uri' och deklareringsdjupet i Objects[]
while Reader.Read do
begin
  if CaptureDepth >= 0 then
    XlsxAppendRawXmlReaderNode(Result, Reader);   // element, text, CDATA, kommentar
  if Reader.NodeType = xmlntElement then
  begin
    for I := 0 to Reader.AttributeCount - 1 do
    begin
      AttrName := Reader.Attribute[I].RawName;
      if (AttrName = 'xmlns') or (Pos(WideString('xmlns:'), AttrName) = 1) then
        Namespaces.AddObject(String(AttrName) + '=' + String(Reader.Attribute[I].Value),
          TObject(NativeInt(Depth)));
    end;
    if (CaptureDepth < 0) and (Reader.Name = 'table:data-pilot-tables') then
    begin
      Opening := XlsxRawXmlReaderOpenTag(Reader);   // skala av avslutande '>' eller '/>' först
      ...
      // Bär de gällande förfäderbindningarna över till fragmentets rot.
      for I := Namespaces.Count - 1 downto 0 do
      begin
        AttrName := WideString(Namespaces.Names[I]);
        if Seen.IndexOf(String(AttrName)) >= 0 then Continue;   // innersta bindningen vinner
        Seen.Add(String(AttrName));
        if not Reader.HasAttribute(AttrName) then               // redan deklarerad här? hoppa över
          Opening := Opening + ' ' + AttrName + '="' +
            XlsxEscapeAttr(WideString(Namespaces.ValueFromIndex[I])) + '"';
      end;
      ...
      CaptureDepth := Depth;
    end;
    if not Reader.IsEmptyElement then Inc(Depth);
  end
  else if Reader.NodeType = xmlntEndElement then
  begin
    Dec(Depth);
    if Depth = CaptureDepth then Exit;                           // delträdet stängt
  end;
  if (Reader.NodeType = xmlntEndElement) or
     ((Reader.NodeType = xmlntElement) and Reader.IsEmptyElement) then
    while (Namespaces.Count > 0) and
          (NativeInt(Namespaces.Objects[Namespaces.Count - 1]) >= Depth) do
      Namespaces.Delete(Namespaces.Count - 1);                   // lämna omfånget
end;
if CaptureDepth >= 0 then
  raise Exception.Create('OpenDocument pivot definition ended inside an element');
Tre detaljer i den loopen bär korrektheten. Att gå igenom stacken från den innersta bindningen och utåt och komma ihåg varje prefix i Seen implementerar överskuggning: om en närmare förfader binder om xmlns:table vinner det närmare värdet, exakt som §6.1 säger att det måste. Att hoppa över prefix som elementet självt redan deklarerar undviker att ge samma attribut två gånger, vilket skulle vara ett annat välformhetsfel. Och popregeln slår till vid sluttaggar och vid tomma element, för <x/> ger aldrig någon EndElement-händelse — samma självstängande fälla som fångsten av XLSX extLst fick lära sig. Att matcha målet på Reader.Name i stället för RawName är en tystare vinst: läsaren kanoniserar ODF:s table-namnrymds-URI till prefixet table, så en producent som stavar det t:data-pilot-tables matchar ändå, medan det emitterade fragmentet behåller vilket prefix producenten än använde
Loopen vägrar också gissa. Om delen tar slut medan fångsten fortfarande är öppen — en trunkerad eller felformad content.xml — kastar OdsCaptureDataPilotTablesXml i stället för att returnera ett halvt fragment, för ett halvt fragment skulle skrivas tillbaka vid sparning och förvandla indata som redan är skadad till utdata som är skadad med bibliotekets namn på
Var hamnar fragmentet i den sparade content.xml?
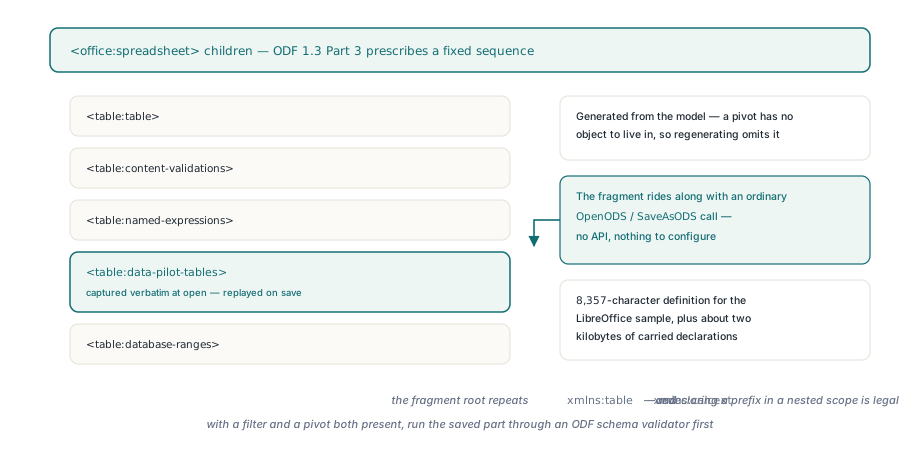
HotXLS skriver det fångade fragmentet i <office:spreadsheet> direkt efter de <table:named-expressions> den genererar och före <table:database-ranges>. Innehållsmodellen för <office:spreadsheet> i ODF 1.3 Part 3 föreskriver en fast följd för de avslutande barnen, så ett ordagrant block kan inte bara läggas till där skrivaren råkar stå; det måste stoppas in i en bestämd plats. Från anroparens sida finns inget API och inget att konfigurera; definitionen följer med vid en vanlig öppning och sparning:
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    if Book.OpenODS('official-pivot.ods') <> 1 then
      raise Exception.Create('open failed');
    Book.Sheets[0].Cells[2, 5].Value := 1250.0;   // redigera inom pivotens källområde
    Book.SaveAsODS('official-pivot-out.ods');
    // content.xml i utdata bär fortfarande DataPilot1 med sitt
    // källområde, fält, målområde, knappar och loext:/calcext:-attribut
  finally
    Book.Free;
  end;
end;
Redundansen är avsiktlig och värd att känna till. Fragmentets rot upprepar nu xmlns:table och xmlns:calcext även om det sparade dokumentets rot också deklarerar dem; Namespaces in XML tillåter att ett prefix deklareras om i ett nästlat omfång, så dubbletterna är ofarliga. För LibreOffice-exemplet är den medburna mängden alla trettiofem rotdeklarationerna, ungefär två kilobyte ovanpå den 8 357 tecken långa definitionen, eftersom fångsten inte analyserar vilka prefix delträdet faktiskt använder. En genomsökning efter använda prefix skulle trimma det, och den kan komma senare; korrekthet först, kompakthet sedan
En regel för att skära ut delträd ur XML för ordagrann uppspelning
Den allmänna lärdomen är att ett delträd bara är självständigt när du har gjort det självständigt, och namnrymdsomfånget är det första som brister när du glömmer det. Checklistan som HotXLS nu tillämpar på varje fångst av typen "behåll det vi inte modellerar":
- Gå igenom dokumentet med en riktig läsare och håll reda på bindningarna i omfånget. Strängsökning med
Poskan inte se omfång alls, och den ger också fel träff på nästlade element med samma namn, på en matchande sträng inuti en kommentar eller enCDATA-sektion, och på attributvärden som råkar innehålla taggtexten - Kopiera de gällande bindningarna över till fragmentets rot, innerst först, en gång per prefix, och hoppa över det roten redan deklarerar
- Behåll råprefixets stavning i de emitterade taggarna; matcha målet på upplöst namnrymd, inte på litteralt prefix
- Bevara whitespace-textnoder, och kom ihåg att ett tomt element stänger sitt eget omfång utan någon sluttaggshändelse
- Validera den sparade delen med en parser som inte är biblioteket under test. Biblioteket läser gladeligen om sin egen utdata genom samma förlåtande kodväg som skrev den
Den sista punkten är den som faktiskt hittade HXLS-003 andra gången. Acceptanskontrollen i v2.382.0 var ett reguljärt uttryck som räknade starttaggar för data-pilot-table i den sparade content.xml, och ett reguljärt uttryck ser en tagg, inte ett dokument — det är blind för om prefixen på den taggen är bundna. Den strikta korpusköraren som lades till i v2.382.1 parsar varje XML- och .rels-del i det sparade paketet med en namnrymdsmedveten parser och jämför sedan pivotträdet — tagg, sorterade attribut, text, barn, rekursivt — mot originalet. Den jämförelsen är namnrymds-expanderad, så en omskrivning av prefix skulle fortfarande gå igenom medan ett obundet prefix inte kan
Var den ordagranna garantin tar slut
Ordagrann uppspelning bevarar en definition; den förstår den inte, och gränserna följer av det. HotXLS exponerar inget API för att läsa, redigera eller uppdatera en ODS-pivot, så FRawOdsDataPilotTablesXml är ett internt fält och det enda observerbara beteendet är att definitionen överlever. Fragmentet serialiseras om från läsarhändelser och kopieras inte som byten: attributcitering och självstängande former normaliseras, medan text och whitespace behålls. Den fångade XML:en emitteras bara av innehållsskrivaren för ODS, så en arbetsbok som öppnats från .ods och sparats som .xlsx tappar pivoten, och en arbetsbok som öppnats från .xlsx har inget att spela upp i en .ods-sparning — asymmetrierna mellan ODS-import- och exportvägarna gäller här som överallt. Och eftersom definitionen är ogenomskinlig kan den inte följa dina redigeringar: byt namn på Sheet1 eller flytta källdata i HotXLS och den sparade pivoten pekar fortfarande på Sheet1.A2:E30, vilket lämnar åt konsumenten att rapportera ett trasigt område nästa gång den uppdateras. En ordningsvarning hör hit också: HotXLS emitterar AutoFilter-områden som <table:database-ranges> efter pivotfragmentet, och korpusexemplet bär inget databasområde, så en arbetsbok med både filter och pivot bör köras genom en ODF-schemavalidator innan du litar på den relativa ordningen mellan de två elementen
Testa med din egen producents filer, inte bara korpusexemplet. Överföringen av namnrymder hanterar vilket prefix en producent än deklarerar på en förfader, men ett dokument som deklarerar ett prefix på pivot-elementet självt, eller som använder en standardnamnrymd för table-vokabuläret, tränar de grenar för överhoppning och överskuggning som LibreOffice-exemplet inte träffar. Båda är implementerade; ingen av dem har något exempel i korpusen än, och den skillnaden är precis den sortens sak som en changelog-post brukar sudda ut
Den ordagranna datapilotfångsten i v2.382.0 och namnrymdsfixen i v2.382.1 levereras i nuvarande HotXLS Delphi Excel Component, vars produktsida listar hela läs- och skrivtäckningen för ODS, XLSX och XLS för Delphi och C++Builder