När en export på 300 000 rader spränger sin minnesbudget får radantalet vanligtvis skulden. Radantalet är vanligtvis oskyldigt. De dyra delarna av en stor arbetsbok är de som skapas som en sidoeffekt: en stilpool som växer med en post per cell eftersom formatering lades till inuti loopen, kalkylblads-XML sammansatt som en enda jättesträng vid sparningstillfället, en miljon identiska formelkroppar lagrade en efter en. HotXLS, losLabs nativa Delphi-bibliotek för XLS- och XLSX-filer, ger dig en specifik spak för var och en av de här kostnaderna. Ingen av dem är aktiverad som standard, eftersom var och en ändrar en avvägning, så att veta vilken spak som matchar vilket symptom är den faktiska prestandafärdigheten
Var en stor arbetsbok spenderar minne
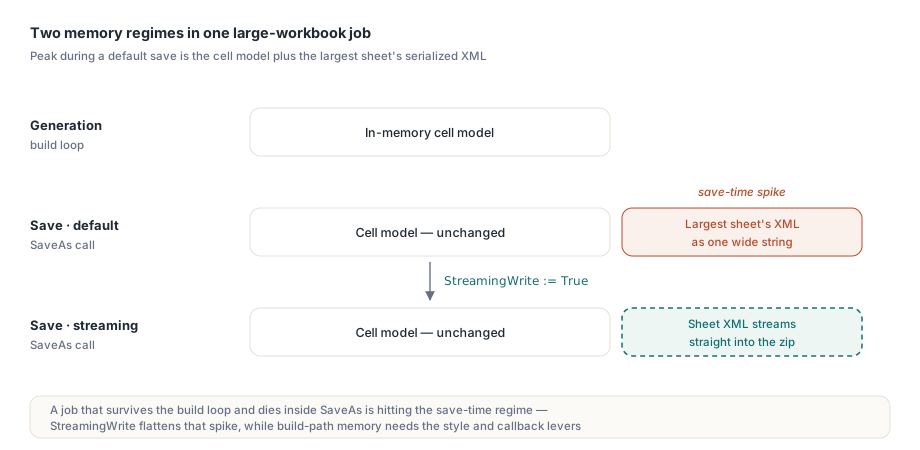
Det finns två distinkta minnesregimer att resonera kring. Under generering växer cellmodellen i minnet med varje cell du rör: värden, format och formler blir alla objekt eller poolposter. Under sparning renderar dessutom standard-XLSX-vägen varje kalkylblads XML till en bred sträng innan den komprimeras in i zip-behållaren, så toppanvändningen är modellen plus det största bladets serialiserade form. Ett jobb som överlever byggloopen och sedan dör inuti SaveAs träffar den andra regimen, inte den första, och lösningen för den ena gör ingenting för den andra
Filstorlek följer en relaterad regel: celler är bara en bidragsgivare, tillsammans med stilar, delade strängar, formler, bilder och kommentarer. Ett granskningspass med ForEachCell och antalen från samlingarna per blad talar om för dig vilken resurs som faktiskt dominerar en problemfil innan du optimerar fel sak. En mätningssubtilitet: Sheet.Cells.Count på XLSX-sidan rapporterar antalet instansierade celler i det glesa lagret, inte arean av det använda området. Ett blad vars data upptar en rektangel på 1000 gånger 50 med hälften av cellerna tomma räknar ungefär 25 000, inte 50 000. Den distinktionen spelar roll när du jämför en kunds "enorma" fil mot dina testfixturer, eftersom arean av det använda området och den faktiska cellpopulationen kan skilja sig åt en storleksordning i glesa finansiella layouter
StreamingWrite fixar sparvägen, inte byggvägen
Att sätta TXLSXWorkbook.StreamingWrite := True växlar SaveAs till en strömmande serialiserare som skriver kalkylblads-XML direkt in i zip-strömmen, vilket eliminerar mellansteget med strängen per blad. Den är som standard False för beteendekompatibilitet, och att slå på den är en enradig ändring:
Book := TXLSXWorkbook.Create;
try
  Sheet := Book.Sheets.Add('Bulk');
  for R := 1 to 100000 do
  begin
    Sheet.Cells[R, 1].Value := R;
    Sheet.Cells[R, 2].Value := 'Row ' + IntToStr(R);
    Sheet.Cells[R, 3].Value := R * 1.5;
  end;
  Book.StreamingWrite := True;   // bladets XML strömmas in i zip-behållaren
  Book.SaveAs('bulk.xlsx');
finally
  Book.Free;
end;
Var precis om vad det här köper: cellmodellen byggd av loopen upptar exakt lika mycket minne som förut. StreamingWrite plattar ut sparningstoppen, vilket är skillnaden mellan ett batchjobb som slutförs och ett som misslyckas vid 95-procentsmärket. Om själva byggloopen uttömmer minnet är spakarna du behöver de nästa två
Stilpooler: lägg till en gång, återanvänd indexet
XLSX-formatering i HotXLS är poolbaserad: Book.Fonts.Add(...), Fills.AddSolid(...) och Borders.Add(...) returnerar ett 0-baserat poolindex som celler refererar till. Att anropa Fonts.Add med identiska parametrar inuti en loop dedupliceras, så det slösar tid snarare än utrymme. Alignments.Add beter sig annorlunda: den returnerar ett nytt objekt per anrop, så att skapa justering per cell växer poolen linjärt med radantalet. En vana täcker båda fallen. Lös upp varje poolindex en gång, utanför loopen, och tilldela index inuti den
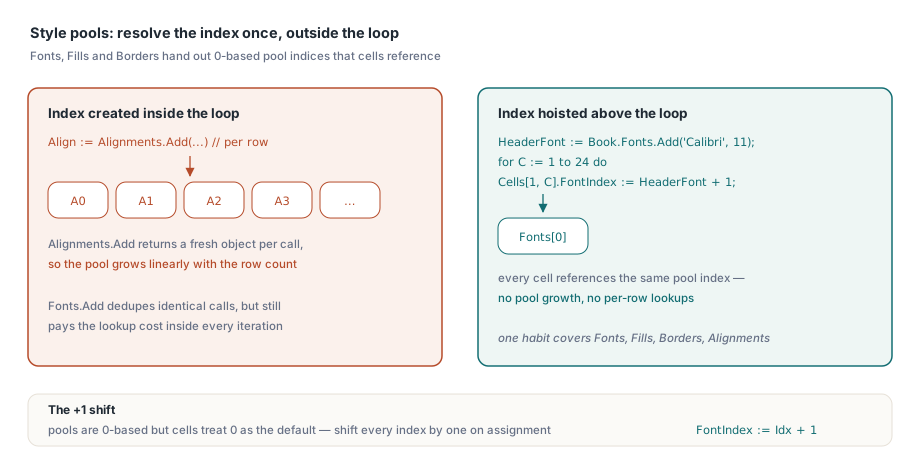
// lyft poolslagningar ut ur den heta loopen
HeaderFont := Book.Fonts.Add('Calibri', 11, True, False);   // 0-baserat poolindex
for C := 1 to 24 do
  Sheet.Cells[1, C].FontIndex := HeaderFont + 1;            // celler lagrar 1-baserat; 0 = standard
+ 1 är inte en felskrivning och att glömma den är den klassiska symptomgenererande buggen här: poolerna delar ut 0-baserade index, medan egenskaperna på cellsidan behandlar 0 som "standard", så varje poolindex måste förskjutas med ett vid tilldelning. Gör fel genom utelämnande och dina rubriker renderas tyst i arbetsbokens standardtypsnitt, en defekt ingen märker förrän vid varumärkesgranskning
Ersätt Variant-trafik per cell med radcallbacks
Varje Sheet.Cells[R, C].Value := X involverar en celluppslagning-eller-skapande plus en Variant-tilldelning. Vid några hundra tusen celler blir den omkostnaden per åtkomst mätbar i profiler. HotXLS tillhandahåller bulk-callback-API:er på båda fasaderna (ForEachCell och ForEachRow för läsning, WriteCells och WriteRows för skrivning) som flyttar iterationen in i motorn och ger din kod hela rader åt gången:
procedure TLedgerExport.FillRow(Sender: TObject;
  SheetIndex, Row, FirstCol, LastCol: Integer;
  var Values: Variant; var Skip: Boolean; var Cancel: Boolean);
begin
  if Row > FCount then
  begin
    Cancel := True;     // stoppa hela skrivningen
    Exit;
  end;
  Values := VarArrayOf([FRows[Row - 1].Account,
                        FRows[Row - 1].PostedOn,
                        FRows[Row - 1].Amount]);
end;

// ett motoranrop i stället för hundratusentals egenskapsträffar
Sheet.WriteRows(1, 1, FCount, 3, FillRow);
Callbackens Skip-flagga lämnar en rad orörd utan att avbryta, och Cancel avslutar operationen tidigt, vilket är användbart när källan är en läsare vars längd du upptäcker allteftersom. Kombinera WriteRows för byggandet med StreamingWrite för sparningen och genereringsvägen har ingen kvarvarande het punkt per cell
Lässidesspakar på XLS-fasaden
Stora äldre .xls-filer har sin egen verktygslåda. _DisableGraphics := True före Open hoppar över att tolka ritlagret helt och hållet, vilket snabbar upp laddning av arbetsböcker som bär år av ackumulerade former och inbäddade bilder. Begränsningen är hård: ritlagret är då frånvarande ur modellen, så att spara en sådan arbetsbok skriver en fil utan dess ritningar. Reservera den här flaggan för skrivskyddade analysjobb. SetTempDir omdirigerar BIFF-skrivarens temporära filer, vilket spelar roll på servrar där standardplatsen för temp har en kvot eller ligger på långsam lagring. UseSharedFormulas grupperar upprepade formelkroppar i delade formelposter, vilket krymper filer där en formelkolumn upprepas ner genom sextiotusen rader
Läsloopar över XLS-data har en indexeringsfälla värd att flagga eftersom den fördubblar arbete när den hanteras defensivt och korrumperar resultat när den missas: UsedRange rapporterar sina gränser FirstRow, LastRow, FirstCol och LastCol 0-baserat, medan Cells.Item[Row, Col] är 1-baserat. En skanning som går igenom det använda området måste lägga till ett till varje koordinat vid cellåtkomsten, som i Cells.Item[Row + 1, Col + 1], annars läser den ett rutnät förskjutet diagonalt med en cell, och tyst tappar den sista raden och kolumnen samtidigt som den inkluderar en fantomförsta. Callbacken ForEachCell kringgår missmatchningen helt, vilket är ännu en anledning att föredra den för hela-bladet-skanningar
Sondera filer innan du laddar dem
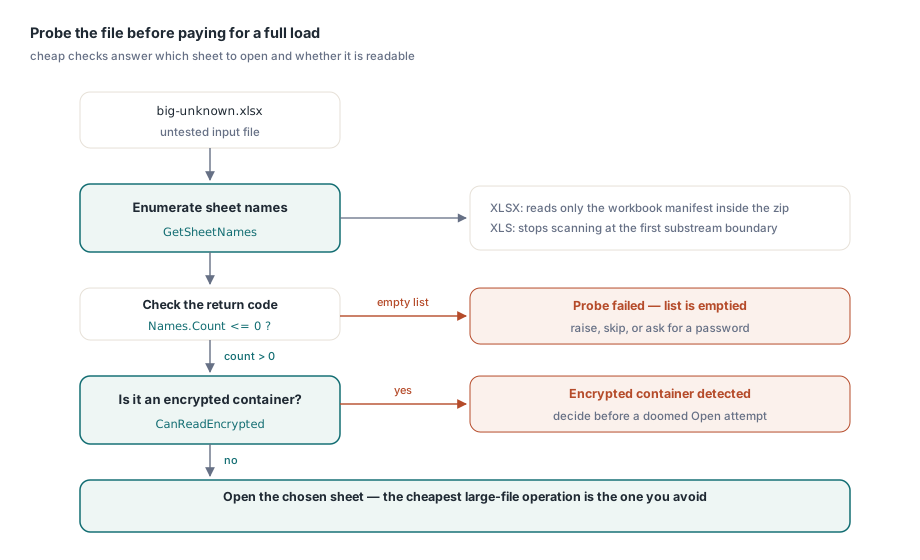
Den billigaste operationen på en stor arbetsbok är den du undviker. GetSheetNames på båda fasaderna listar en fils kalkylblad utan att ladda celldata. XLSX-implementationen läser bara arbetsboksmanifestet inuti zippen och lämnar uttryckligen arbetsboksinstansen ofylld, och XLS-fasaden slutar skanna vid den första underströmsgränsen. Det gör den till rätt förhandskontroll för "vilket blad ska det här importjobbet rikta sig mot", och CanReadEncrypted svarar på "är det här en krypterad behållare" innan ett dömt Open-försök
Names := TStringList.Create;
Book := TXLSXWorkbook.Create;
try
  if Book.GetSheetNames('big-unknown.xlsx', Names) <= 0 then
    raise Exception.Create('cannot enumerate sheets');   // misslyckande tömmer listan
  // välj målbladet, avgör sedan om en fullständig Open är värd det
finally
  Book.Free;
  Names.Free;
end;
Notera returkodskonventionen: de här sonderingsfunktionerna signalerar misslyckande med värden vid eller under noll och tömmer utdatalistan, så testa <= 0 snarare än att jämföra mot ett specifikt framgångsvärde
Att storleksanpassa angreppssättet efter jobbet
För obevakade pipelines som genererar många stora filer i följd avrundar två vanor till bilden. Arbetsboksobjekt är inte trådsäkra för delning, men inget hindrar en oberoende arbetsbok per arbetartråd, vilket parallelliserar batchkonvertering rent. Och när utdata går till HTTP snarare än disk kombineras TStream-sparöverlagringarna med StreamingWrite så att ett stort svar aldrig materialiseras som en temporär fil. En driftsfotnot gäller: strömsparningen skriver från den aktuella positionen utan att spola tillbaka, så sätt Position := 0 innan du lämnar strömmen till svarsramverket. Artikeln om strömmande skrivning och batchjobb utvecklar det serversidiga mönstret, och artikeln om databasexport visar var de här spakarna passar in i en datasetdriven rapport
Slutligen, behåll en värsta-fall-fixtur per rapportfamilj och tidta den i CI. Prestandaregressioner i dokumentgenerering avslöjar sig sällan själva. En stil tillagd inuti en loop eller en sondering ersatt med en fullständig Open ändrar ingenting funktionellt, och det nattliga batchjobbet tar helt enkelt fyrtio minuter längre. Ett tidtaget test på en representativ fixtur med en halv miljon celler förvandlar den glidningen till ett rött bygge i stället för en driftsincident
Utvärderingsbyggen, demoprojekt med ett exempel på bulkgenerering, och den fullständiga API-referensen finns tillgängliga på sidan för HotXLS Delphi Component