Ett definierat namn som pekar på en hel kolumn läses av Excel som en enda cell när det står i en skalär position: =Vertical+1 på rad 7 betyder "cellen på rad 7 i Vertical", inte hela området. HotXLS Delphi Component tillämpar den implicita intersectionen i v2.382.4 på två nivåer, både vid utvärdering och vid beroendeutvinning, för en lånetabell med 4805 formler visade att det inte räcker att få fram rätt värde. När beroendegenomgången expanderar namnet till hela sitt område sluter en nedströms formel som matar någon cell i området en cykel som inte finns, och TXLSXWorkbook.Recalculate vägrar hela arbetsboken
Mallen i fråga är en vanlig låneamorteringsarbetsbok. Med varje cachat värde förgiftat till 777 och en full Recalculate-körning returnerade båda motorarkitekturerna 23, vilket är lxErrorRef, koden för cirkulär referens. 3842 av de 4805 formlerna stämde inte med den oberoende förväntan, B18 innehöll #VALUE!, E18 var fortfarande 777, och betalningsantalet i J7 hade läst platshållarna i en oavslutad saldokolumn. Tre separata fel gömde sig bakom en enda returkod, och den här artikeln går igenom vart och ett med källkoden som åtgärdade det
Varför skapar en skalär referens till ett kolumnnamn en falsk cykel?
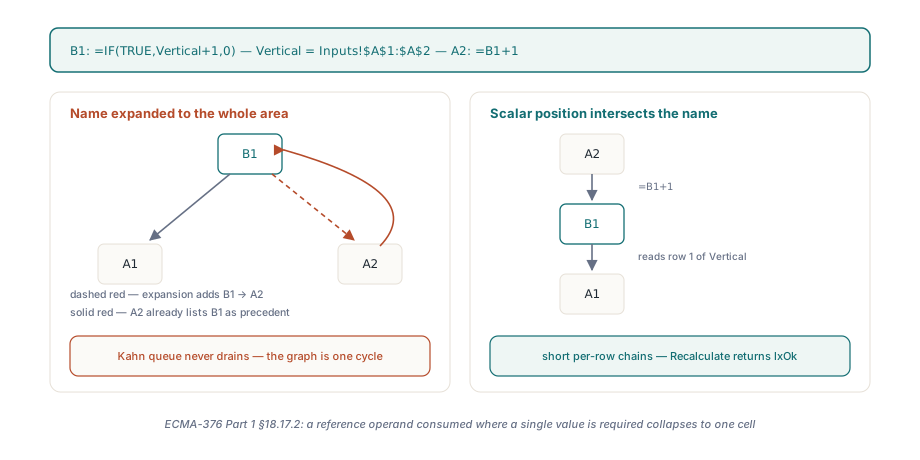
För att en beroendegraf bara känner kanter, och en kant från en formel till ett område på 480 rader är 480 kanter, varav en pekar tillbaka genom en cell som beror på formeln. Tänk dig =IF(TRUE,Vertical+1,0) i B1 med Vertical definierat som Inputs!$A$1:$A$2, och =B1+1 i A2. Excel utvärderar B1 som A1+1 och A2 som B1+1, en rak kedja. En genomgång som registrerar B1 som beroende av A1:A2 gör A2 till ett precedensfall för B1, A2 listar redan B1 som precedensfall, och Kahn-kön som driver inkrementell omräkning i HotXLS ser aldrig någon av noderna nå in-grad noll. Det här är mönstret lånetabeller är byggda av: varje periodrad refererar namngivna kolumner för saldo, ränta och betalningsantal, varje namn spänner över hela amorteringsplanen, och varje rad skriver dessutom in i de kolumnerna. Expandera namnen och grafen är en enda jättelik starkt sammanhängande komponent. Utvärdera dem med implicit intersection och grafen är en uppsättning korta kedjor, en per rad, vilket är vad ECMA-376 Part 1 §18.17.2 beskriver för en referensoperand som konsumeras där ett enda värde krävs
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Inputs');
    Book.DefinedNames.Add('Vertical', 'Inputs!$A$1:$A$2');
    Book.DefinedNames.Add('Alias', '=Vertical');
    Sheet.Cells[1, 1].Value := 1;
    // Skalär position: Vertical kollapsar till A1 eftersom formeln står på rad 1
    Sheet.Cells[1, 2].Formula := '=IF(TRUE,Vertical+1,0)';
    Sheet.Cells[2, 1].Formula := '=B1+1';
    // Ett namn vars definition är ett annat namn intersekterar ändå, så detta är A2
    Sheet.Cells[2, 2].Formula := '=Alias';
    // Argument av referensklass: hela området summeras, ingen intersection
    Sheet.Cells[3, 2].Formula := '=SUM(Vertical)';
    // Rad 6 ligger utanför A1:A2, intersectionen är tom och IFERROR fångar det
    Sheet.Cells[6, 2].Formula := '=IFERROR(Vertical,42)';

    if Book.Recalculate = lxOk then
    begin
      // B1 = 2, A2 = 3, B2 = 3, B3 = 4, B6 = 42
      // Före v2.382.4 var den här grenen onåbar: B1 -> A2 -> B1 var en cykel
    end;
  finally
    Book.Free;
  end;
end;
Hur avgör HotXLS att ett argument är skalärt?
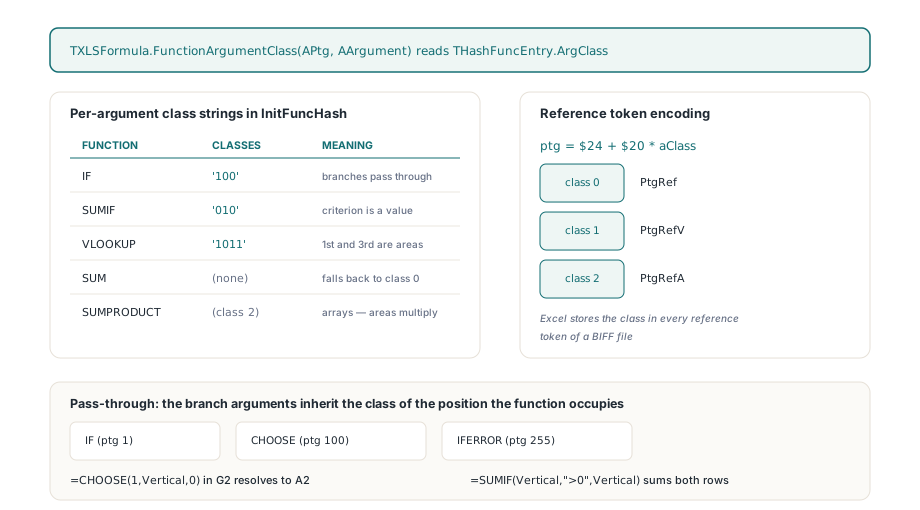
HotXLS läser svaret ur funktionstabellen i stället för ur argumentets form. Varje post i TXLSFormula.InitFuncHash registreras via THashFunc.SetValue med en valfri klasssträng per argument: 'IF' bär '100', 'SUMIF' bär '010', 'VLOOKUP' bär '1011', och 'SUM' bär ingen, så alla dess argument faller tillbaka på funktionsnivåklassen 0. Den nya TXLSFormula.FunctionArgumentClass(APtg, AArgument) exponerar den byten via THashFuncEntry.ArgClass, och ett resultat på 1 betyder värdeklass. Det är samma tre klasser som [MS-XLS] §2.2.2 tilldelar operandtokens, och encodern har redan förlitat sig på dem: när den skriver en referens räknar den ut ptg:n som $24 + $20 * aClass, vilket ger PtgRef för klass 0, PtgRefV för klass 1 och PtgRefA för klass 2. En BIFF-fil skriven av Excel lagrar den klassen i varje referenstoken, så en motor vars tabell matchar specifikationen kan svara på "är det här argumentet skalärt" utan att titta på data. SUMIF:s mellersta argument är kriteriet, ett värde; det första och tredje är områden, referenser. SUMPRODUCT är registrerad med funktionsnivåklass 2, array, vilket är varför =SUMPRODUCT(Vertical,Vertical) fortfarande multiplicerar hela området
Tre funktioner konsulterar inte sin egen tabellpost för något bortom det första argumentet. IF (ptg 1), CHOOSE (ptg 100) och IFERROR (ptg 255) släpper igenom vad de än väljer, så deras grenargument ärver klassen för den position funktionen själv står i. Den enda regeln är vad som låter =CHOOSE(1,Vertical,0) i G2 bli A2 medan =SUMIF(Vertical,">0",Vertical) intill fortfarande summerar båda raderna, och det är regeln en amorteringsplan utnyttjar mest, eftersom dess periodceller lutar sig mot IF för att testa om lånet fortfarande är öppet
Att bära klassen genom beroendegenomgången
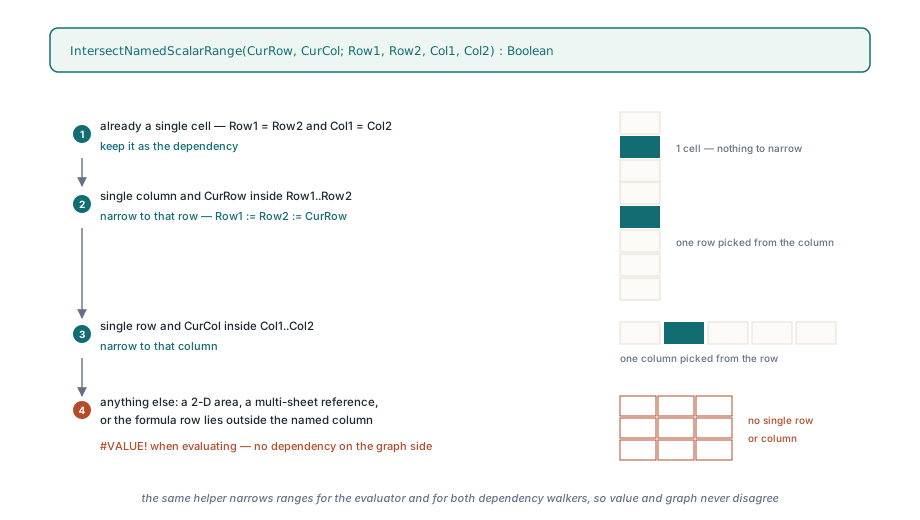
Beroendeutdragaren i lxCalc.pas är en rekursiv Walk över det kompilerade syntaxträdet, och den finns i två exemplar, ett i TXLSCalculator.ExtractDependencies för arbetsboksgrafen och ett i ExtractWorkspaceDependencies för grafen mellan arbetsböcker. v2.382.4 ger båda genomgångarna två extra parametrar. AScalar börjar som True i roten av en formel, räknas om för varje funktionsbarn från FunctionArgumentClass, och skickas vidare oförändrad för grenargumenten till ptg 1, 100 och 255. ANameRoot blir True bara när genomgången går ned i ett namns kompilerade definition, och den överlever bara genom SA_GROUP-noder, parenteserna, så ett namn definierat som =A1:A2+1 inte misstas för ett vanligt område. När båda flaggorna är True vid en SA_RANGE-nod snävar AddResolvedRange in området med samma hjälpfunktion som utvärderaren använder innan den registrerar beroendet. Hjälpfunktionen är kort nog att citera i sin helhet
function IntersectNamedScalarRange(CurRow, CurCol: Integer;
  var Row1, Row2, Col1, Col2: Integer): Boolean;
begin
  Result := False;
  if (Row1 = Row2) and (Col1 = Col2) then Exit(True);   // redan en cell
  if (Col1 = Col2) and (CurRow >= Row1) and (CurRow <= Row2) then
  begin
    Row1 := CurRow; Row2 := CurRow;                     // enstaka kolumn: ta den här raden
    Exit(True);
  end;
  if (Row1 = Row2) and (CurCol >= Col1) and (CurCol <= Col2) then
  begin
    Col1 := CurCol; Col2 := CurCol;                     // enstaka rad: ta den här kolumnen
    Result := True;
  end;
end;
Allt hjälpfunktionen avvisar, ett tvådimensionellt område, en referens över flera ark eller en formel vars rad ligger utanför den namngivna kolumnen, ger #VALUE! på utvärderingssidan och inget beroende alls på grafsidan, vilket är vad Excel gör för en tom intersection. Utvärderingssidan bor i TXLSCalculator.GetValueItemName: den skalar av SA_GROUP-omslag från den kompilerade definitionen, och om roten är en SA_RANGE anropar den GetRangeInfo, intersekterar och hämtar den enda cellen via FGetValue i stället för att utvärdera hela definitionen. Externa referenser stannar på den gamla vägen, för det finns ingen lokal rad att intersektera mot. Var ett namns lagring och räckvidd kommer ifrån till att börja med tas upp i artikeln om definierade namn och formler mellan ark; poängen här är bara vad motorn gör när namnet väl har lösts upp
Varför läste MATCH 777 i en halvfärdig kolumn?
För att MATCH:s uppslagsmatrisargument är en skanningsreferens, och skanningsreferenser uteslöts medvetet från utvärderingsordningen. Artikeln om uppslagsscanning introducerade TXLSDepRange.LookupScan och avslutades med ett avsnitt som hette "Vad du ger upp genom att utesluta skanningskanter från ordningen": en uppslagsformel kan köra innan varje cell i dess område har räknats om och läsa inaktuella värden. I en interaktiv session konvergerar det vid nästa pass. I en batchomräkning av en förgiftad mall gör det inte det, och PaymentCount, definierat som =MATCH(0.01,Balances,-1)+1, läste 777-platshållarna som fortfarande låg kvar i saldokolumnen och returnerade ett periodantal som inte kunde vara rätt
TXLSDepGraph.TopoOrder behandlar nu skanningskanter som mjuka ordningskanter. Vid sidan av den hårda in-graden håller den en ScanInDeg-array som räknar smutsiga skanningsprecedensfall per nod och minskar den i takt med att de precedensfallen emitteras, med hjälp av listorna ScanPrecedents, ScanDependents och ScanPrecedentCount som den tidigare ändringen redan lagrade. Vid varje iteration söker Kahn-kön igenom sitt redo-fönster efter den första nod vars ScanInDeg är noll och byter den till huvudet; om varje redo-nod fortfarande väntar på ett skanningsprecedensfall poppas huvudet i sin stabila ordning. Skanningskanter hamnar aldrig i den hårda in-graden, så en självrefererande VLOOKUP över sin egen kolumn är fortfarande tillåten, men ett uppslag som skulle kunna vänta på ett avslutningsbart precedensfall gör det nu. Regressionstestet som låser fast detta, LookupScan_WaitsForDirtyFormulaValues, förgiftar tre saldoceller till 777 och förväntar sig att PaymentCount kommer tillbaka som 3, växlar sedan indata till noll och förväntar sig att =IFERROR(PaymentCount,99) ser #N/A och returnerar 99
Var kom avrundningen till fyra decimaler ifrån?
Från Delphi Variant-aritmetik, och bara i nästlade positioner. Binäroperatorerna i TXLSCalculator.GetValueItem kopierade redan ett + eller - på toppnivå till två Double-lokaler, så =B1-A1 gick bra. Inuti =IF(TRUE,B1-A1,0) körde samma subtraktion som Value := Value - SubValue på två Variants, och när den ena operanden var ett Int64-cellvärde och den andra en Double blev resultatet vi såg en Currency, en fixpunktyp med fyra decimaler, så 1066.1854641400994 minus 120 kom tillbaka trunkerat till fyra decimaler. I en amorteringsplan där varje betalning räknas fram ur föregående rad vandrar det felet genom hundratals perioder innan det når summorna
// TXLSCalculator.GetValueItem, grenen för binär aritmetik (lxCalc.pas)
if VarIsNull(Value) then Value := 0;
if VarIsNull(SubValue) then SubValue := 0;
// Blandad Int64/Double-Variant-aritmetik kan befordras till Currency.
// Kalkylbladsaritmetik måste behålla flyttalsprecision.
if VarIsNumeric(Value) then Value := Double(Value);
if VarIsNumeric(SubValue) then SubValue := Double(SubValue);
Skyddet kör före SA_ADD, SA_SUB, SA_MUL och SA_DIV på samma sätt, och regressionstestet Arithmetic_MixedInt64AndDoubleKeepsPrecision lagrar Int64(120) i A1 och 1066.1854641400994 i B1, och kontrollerar sedan den nästlade differensen och summan mot 1E-10 samt produkten och kvoten mot 1E-8 respektive 1E-12. HotXLS gör inte anspråk på att känna till varje befordringsregel som RTL tillämpar på blandade Variant-typer över kompilatorversioner; det gör anspråk på att kalkylbladsaritmetik är IEEE double, och nu gör det båda operanderna till double innan operatorn ser dem, vilket tar bort frågan
Vad fixen garanterar, och vad den inte garanterar
Efter v2.382.4 returnerar båda motorarkitekturerna lxOk för den förgiftade mallen, alla 4805 cachade värden stämmer med den oberoende rad-för-rad-förväntan inom 1E-7, och påståendena att cachen verkligen var förgiftad, att källhashvärdet är oförändrat och att varje formel fortfarande finns kvar håller alla. Ingen iteration slogs på och ingen felkod undertrycktes för att komma dit. En äkta cykel genom ett namn, =B1 i A1 medan B1 fortfarande läser Vertical, ger fortfarande ett fel, och testet NamedScalarRanges_IntersectWithoutFalseCycles avslutas med att påstå exakt det
Gränserna är värda att säga rakt ut. Implicit intersection gäller bara ett namn vars kompilerade definition, efter att parenteser skalats av, är ett enkolumns- eller enradsområde på ett enda ark; ett tvådimensionellt namn i skalär position är #VALUE!, precis som i Excel, och en funktion som tabellen inte känner igen får klass 0 från FunctionArgumentClass, så dess namnargument expanderas fortfarande i sin helhet. Den mjuka ordningen är en preferens, inte en garanti: en cykel som bara består av skanningskanter utvärderas fortfarande i stabil ordning och läser vad som än ligger i cachen, vilket är beteendet uppslagsscanningsartikeln accepterade med avsikt. Och resultatet för hela mallen är verifierat mot ett oberoende förväntansskript, inte mot en annan kalkylbladsmotor, eftersom en extern kontorssvit inte hann räkna om originalmallen inom en budget på 60 sekunder. HotXLS är en nativ kalkylbladskomponent för Delphi och C++Builder som läser, räknar om och skriver XLS, XLSX, ODS och CSV utan Excel installerat; namnintersectionen, argumentklasstabellen och den mjuka skanningsordningen gäller för varje format eftersom beräkningsmotorn delas, och den aktuella funktionstäckningen listas på produktsidan för HotXLS Delphi spreadsheet component