HotPDF kör Tesseract inuti din Delphi-process genom HPDFCreateTesseractDLLOCREngine, en fabrik tillagd i v2.772.0 som dynamiskt laddar en Tesseract 5-kompatibel DLL, driver dess C-API (TessBaseAPIInit2, TessBaseAPIRecognize, result iterator:n) och returnerar en IHPDFOCREngine. THotPDF.ApplyLoadedOCRTextLayer använder den motorn för att lägga till ett osynligt, sökbart Unicode-textskikt på inskannade PDF-sidor
Samma igenkännare var redan nåbar genom den externa tesseract.exe-adaptorn som skriver en BMP och tolkar TSV. Den vägen fungerar, men varje sida betalar för en processstart, en temporär bitmappsfil och ett textformat utan baslinjer och utan kontroll över sidsegmentering. Att anropa DLL:en tar bort alla tre. Den tar också bort processmuren, vilket betyder att en Pascal-bindning sitter direkt ovanpå C-strukturer, C-booleaner och C-allokerade strängar. Det mesta som är värt att veta om denna adaptor är var den bindningen kan gå tyst fel
Hur kör du Tesseract in-process från Delphi med HotPDF?
Att köra Tesseract in-process med HotPDF tar ett fabriksanrop i uniten HPDFTesseractRecognition och samma ApplyLoadedOCRTextLayer-anrop varje HotPDF OCR-motor använder. Fabriken validerar ivrigt. DLL-filen och tessdata-katalogen måste finnas, språkidentifieraren får bara innehålla ASCII-bokstäver, siffror, _ och +, varje modell i en kombination som chi_sim+eng måste ha en matchande .traineddata-fil, och alla 21 krävda exporter måste lösas upp innan motorn returneras. Konfigurationsmisstag kastar EArgumentException; en DLL som inte laddas kastar EOSError med Windows-felkoden och en ledtråd att kontrollera arkitektur och beroenden
uses
  SysUtils, HPDFDoc, HPDFTesseractRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Ett Win64-program behöver en 64-bitars DLL; beroende-DLL:er läggs bredvid
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract-5.dll',
    'C:\OCR\tessdata', 'chi_sim+eng');   // THPDFTesseractOptions.Default
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;   // 300 DPI, MinimumConfidence 0.5
    // En tom sidolista betyder varje sida; sidor som redan har text hoppas
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' words accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFTesseractOptions.Default sätter PageSegMode till tpsAuto, EngineMode till temDefault, TimeoutMilliseconds till 60 000 och MaxPixels till 16 777 216. Pixelbudgeten spelar större roll än den ser ut. En US Letter-sida vid standard-300 DPI renderas till 2 550 × 3 300 pixlar, omkring 8,4 miljoner, vilket ryms. Samma sida vid 600 DPI är 5 100 × 6 600, omkring 33,7 miljoner, och adaptorn avvisar den innan Tesseract ser en pixel. Höj MaxPixels (taket är 67 108 864) eller låt DPI:n stå; varje sida är dessutom taklagd vid 32 767 pixlar
DLL:en laddas med LoadLibraryEx med sökflaggorna för DLL:ens egen mapp plus de defaultsäkra katalogerna, så bildbiblioteken Tesseract beror på kan bo bredvid den utan att röra PATH eller aktuell katalog. HotPDF buntar eller laddar inte ner någon OCR-runtime eller modell; du förser båda
Vad ändras jämfört med tesseract.exe-adaptorn?
DLL-adaptorn byter processisolering mot rikare utdata och lägre per-sida-overhead. Båda adaptorerna kopplar in i samma textlayers-pipeline, så koordinatmappning, konfidensfiltrering och allt-eller-inget-committen är identiska; det som skiljer är hur pixlar går in och ord kommer ut
| Aspekt | tesseract.exe-adaptorn | Tesseract-DLL-adaptorn |
|---|---|---|
| Fabrik | HPDFCreateTesseractOCREngine | HPDFCreateTesseractDLLOCREngine |
| Pixlar in | BMP-fil i en privat temporärkatalog | 8-bitars gråskalebuffert i minnet |
| Ord ut | Ordnivå-TSV, taklagd vid 64 MiB | Result iterator, UTF-8 per ord |
| Baslinjer | Ej tillgängligt | Skickas vidare från TessPageIteratorBaseline |
| Sidsegmentering och engine mode | Endast automatisk segmentering | THPDFTesseractPageSegMode, THPDFTesseractEngineMode |
| Timeout | Hårt: barnprocessen termineras | Kooperativt: Tesseract måste notera |
| Krasch- och minneisolering | Separat process | Ingen, delar ditt adressutrymme |
En kostnad försvinner inte. Varje Recognize-anrop skapar sin egen API-instans och anropar TessBaseAPIInit2, så att språkmodellerna initieras per sida i stället för en gång per motor. Operativsystemets filcache mjukar upp omladdningen, men på stora flerspråkiga modellmängder är den fortfarande den dominerande fasta kostnaden per sida, och den räknas mot igenkänningsdeadlinen. In-process RapidOCR-DLL-motorn tar den motsatta designen och håller sina ONNX-modeller residenta under motorns livstid; gränsproblemen (C-ABI, lånade buffertar, avbrottsfri nativ arbetning) är samma familj
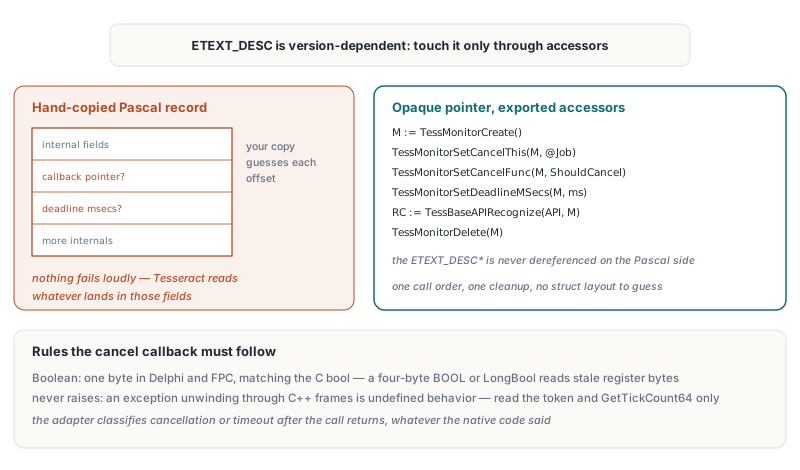
Varför kan inte Delphi kopiera Tesseract monitor-struktur?
Delphi kan inte spegla Tesseracts progressmonitor på ett säkert sätt för ETEXT_DESC innehåller versionsberoende interna fält, så en handkopierad post placerar avbrotts-callbacken och deadlinen på fel offset på vissa byggen. Inget faller högt när det händer. Tesseract läser bara din callback-pekare från ett fält som nu håller något annat, eller ser aldrig deadlinen alls
HotPDF behandlar därför monitorn som en opak pekare och rör den bara genom exporterade funktioner: TessMonitorCreate, TessMonitorSetCancelThis, TessMonitorSetCancelFunc, TessMonitorSetDeadlineMSecs och TessMonitorDelete. Binder du C-API:et själv för ett annat syfte gäller samma mönster. Skissen nedan är din egen bindningskod, inte HotPDF-API, och speglar deklarationerna HotPDF använder internt
type
  // C: typedef bool (*TessCancelFunc)(void *cancel_this, int words);
  TTessCancelFunc = function(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
  TTessMonitorCreate = function: Pointer; cdecl;   // ETEXT_DESC*, aldrig derefererad
  TTessMonitorDelete = procedure(Monitor: Pointer); cdecl;
  TTessMonitorSetCancelFunc = procedure(Monitor: Pointer; Func: TTessCancelFunc); cdecl;
  TTessMonitorSetCancelThis = procedure(Monitor, CancelThis: Pointer); cdecl;
  TTessMonitorSetDeadlineMSecs = procedure(Monitor: Pointer; MSecs: Integer); cdecl;
  TTessBaseAPIRecognize = function(Handle, Monitor: Pointer): Integer; cdecl;

  TOCRJob = record
    CancelRequested: Boolean;
    DeadlineTick: UInt64;
  end;
  POCRJob = ^TOCRJob;

function ShouldCancel(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
begin
  // Körs på Tesseracts stack: läs flaggor och klockan, kasta aldrig
  Result := (CancelThis = nil) or POCRJob(CancelThis)^.CancelRequested or
    (GetTickCount64 >= POCRJob(CancelThis)^.DeadlineTick);
end;

// Användning, med funktionspekarna upplösta av GetProcAddress:
//   Monitor := MonitorCreate();
//   try
//     MonitorSetCancelThis(Monitor, @Job);
//     MonitorSetCancelFunc(Monitor, ShouldCancel);
//     MonitorSetDeadlineMSecs(Monitor, RemainingMs);
//     RC := BaseAPIRecognize(API, Monitor);
//   finally
//     MonitorDelete(Monitor);
//   end;
Två detaljer i den skissen är med flit. Callbacken returnerar Boolean, som är en byte i både Delphi och Free Pascal, matchande C bool i TessCancelFunc. Fyrbajts Windows BOOL eller Delphi LongBool ser utbytbar ut och är det inte: när ena sidan skriver en enda byte och andra läser fyra är de övre bytena i returregistret vadhelst som fanns kvar där, och en false kan anlända som true. Samma header komplicerar saker ytterligare, för funktioner som TessPageIteratorBoundingBox returnerar en int, som HotPDF deklarerar som Integer. Läs C-typen hos varje returvärde i stället för att anta en konvention för hela API:et
Den andra detaljen är att callbacken aldrig kastar. En Delphi-exception som rullar upp genom Tesseracts C++-ramar är odefinierat beteende, så HotPDF:s callback läser bara annulleringstoken och ett monotont GetTickCount64-värde. Adaptorn gör om resultatet till en annullerings- eller timeout-diagnostext efter att TessBaseAPIRecognize returnerat, och utför den kontrollen oavsett den nativa returkoden
Vilka nativa pekare äger Delphi-sidan?
HotPDF Tesseract-DLL-adaptor äger tre nativa objekt per begäran, API-instansen, monitorn och result iterator:n, och lånar allt annat. Varje Recognize-anrop skapar sin egen uppsättning och släpper den i ett finally-block: TessResultIteratorDelete, sedan TessMonitorDelete, sedan TessBaseAPIDelete. Att släppa motorinterfacet avladdar biblioteket
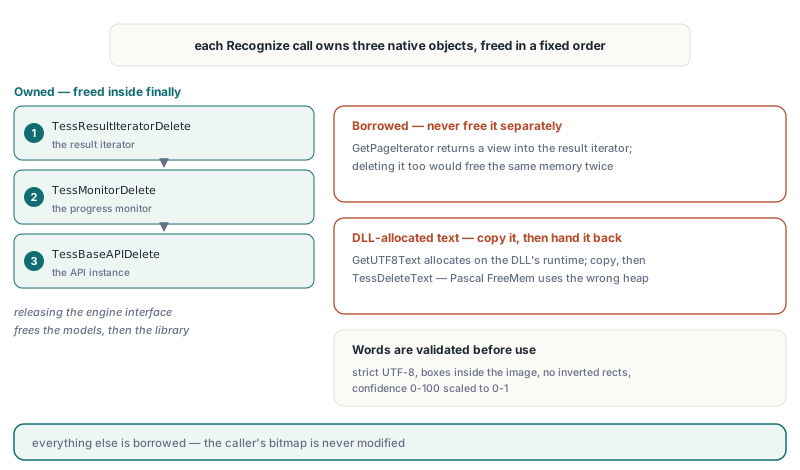
TessResultIteratorGetPageIteratorreturnerar en lånad vy in i result iterator:n, inte ett nytt objekt. HotPDF använder den förTessPageIteratorBoundingBoxochTessPageIteratorBaselineoch frigör den aldrig; att radera den separat skulle frigöra samma minne två gångerTessResultIteratorGetUTF8Textreturnerar en sträng allokerad av DLL:ens egen runtime. HotPDF kopierar den och lämnar tillbaka den genomTessDeleteTexti ettfinally-block; PascalFreeMemskulle frigöra den på fel heap- Ordtext avkodas med strikt UTF-8-validering och längdkontrolleras före konvertering. Ord med kontrolltecken, felformad UTF-8, boxar utanför bilden, inverterade rektanglar eller konfidens utanför 0–100 fäller begärandet i stället för att tyst lagas
- Total text per begäran taklagd vid 1 048 576 UTF-16 code units, och ordantalet måste passa den begärandebudget som
ApplyLoadedOCRTextLayerför ner
Konfidens anländer som 0–100 och skalas till 0–1, så THPDFOCRTextLayerOptions.MinimumConfidence betyder samma sak för varje motor. Rapporterar Tesseract en baslinje skickas båda ändpunkterna vidare; annars faller textlayers-pipelinen tillbaka på sin geometriska uppskattning, exakt som den gör för TSV-indata
Varför validera en enum innan den når DLL:en?
HotPDF kopierar den råa ordinalen hos PageSegMode och EngineMode till en Integer före intervallkontroll, för en kompilator kan anta att en enumvariabel alltid håller ett deklarerat värde och vikla Ord(X) > Ord(High(T)) till en konstant false. Ordinalerna är ingen dekoration: THPDFTesseractPageSegMode följer Tesseracts sidsegmenteringsnumrering från 0 till 13, THPDFTesseractEngineMode följer engine mode-numreringen från 0 till 3, och båda går till DLL:en som vanliga heltal. En alternativpost byggd med FillChar, ifylld från en ström, eller skickad från C++Builder med ett castat heltal kan bära en byte som 200. Att validera den kopierade ordinalen gör om det till en EArgumentException vid fabrikstid i stället för ett odefinierat läge inuti nativ kod. Fabriken avvisar också tpsOSDOnly och tpsAutoOnly, som framställer inga ord, och kräver osd.traineddata för tpsAutoOSD och tpsSparseTextOSD
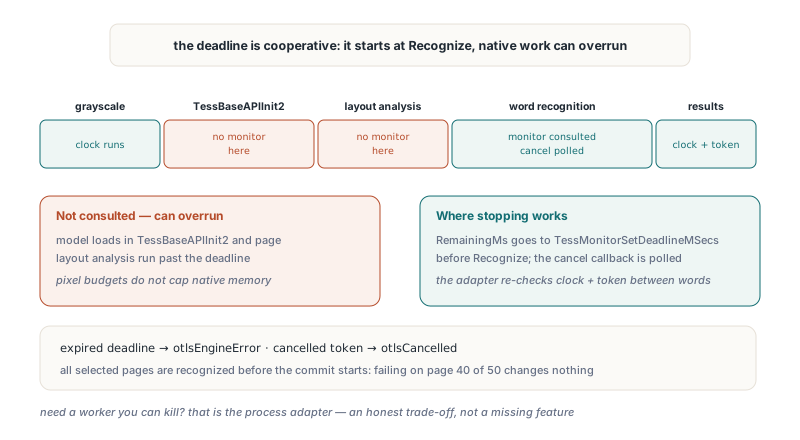
Vad garanterar igenkänningstimeouten egentligen?
Tesseract-DLL-timeouten är kooperativ: HotPDF kan stanna sitt eget arbete och be Tesseract stanna, men den kan inte tvinga nativ kod att returnera. Klockan startar när Recognize börjar, så bitmappskonvertering och modellinitiering konsumerar samma budget som igenkänningen. HotPDF kontrollerar förfluten tid och annulleringstoken under gråskalekonverteringen och mellan ord medan resultat itereras, och skickar de återstående millisekunderna till TessMonitorSetDeadlineMSecs före anropet till TessBaseAPIRecognize
Gapet finns inuti det nativa anropet. Tesseracts monitor konsulteras under ordigenkänning, inte under TessBaseAPIInit2 eller sidlayoutanalys, så en långsam modellladdning eller en patologisk layout kan löpa förbi deadlinen innan timeouten rapporteras. Pixel- och utdatabudgeterna taklägger inte heller det nativa bibliotekets eget minnesbruk. Behöver du en arbetare du kan döda, använd processadaptorn; det är den ärliga avvägningen, inte en saknad funktion
Sidsegmentering är där DLL-adaptorn förtjänar sin plats på svår indata. Formulär, etiketter och inskannade tabeller med utspridda fält igenkänns ofta bättre med tpsSparseText än med automatisk segmentering, som försöker sätta ihop kolumner och stycken som inte finns där
procedure OCRFormPages(Doc: THotPDF; const Pages: array of Integer);
var
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  LayerOptions: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default;
  TessOptions.PageSegMode := tpsSparseText;  // utspridda fält, ingen kolumnsammansättning
  TessOptions.EngineMode := temLSTMOnly;     // behöver LSTM-modeller i tessdata
  TessOptions.TimeoutMilliseconds := 20000;  // inkluderar modellinitiering
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract-5.dll',
    'C:\OCR\tessdata', 'eng+deu', TessOptions);

  LayerOptions := THPDFOCRTextLayerOptions.Default;
  LayerOptions.MinimumConfidence := 0.6;
  if not Doc.ApplyLoadedOCRTextLayer(Pages, Engine, LayerOptions, Info) then
    case Info.Status of
      otlsCancelled:
        Writeln('OCR cancelled, document unchanged');
      otlsEngineError:
        Writeln('Tesseract failed or timed out: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
En timeout visar sig som otlsEngineError med diagnostexten Tesseract DLL OCR timed out, medan en avbruten token visar sig som otlsCancelled. I båda fallen har ApplyLoadedOCRTextLayer igenkänt varje vald sida innan den startar commit-transaktionen, så ett misslyckande på sida 40 av 50 lämnar det laddade dokumentet exakt som det var. Notera att tpsSingleLine, tpsSingleBlock och tpsSparseText ändrar bara segmentering; ingen av dem rätar en skev skanning
Free Pascal och Lazarus: inaktuella pixlar och förlorad kinesiska
Båda Tesseract-fabrikerna fungerar i Windows Free Pascal- och Lazarus Win32- och Win64-byggen sedan v2.772.1, efter två FPC-specifika fixar. Bygg om Lazarus-paketet för målarkitekturen först; den allmänna porteringen tas upp i HotPDF på Free Pascal och Lazarus Win64
Första fixen rör pixlar. En LCL TBitmap skriven via scanlines kan uppdatera sin råa bild utan att uppdatera Windows-bitmappshantelet, så GetDIBits på det hantelet returnerar de gamla pixlarna. Symtomet var förbryllande: text ritad direkt på en bitmapp igenkändes, medan en sida renderad av HotPDF:s PDF-renderare framställde en tom ordlista. På FPC läser adaptorn nu en formatmedveten ögonblicksbild genom CreateIntfImage, som respekterar den råa bildens pixelformat och radordning. Delphi-bygget behåller GetDIBits-vägen på en privat 24-bitars kopia. Inget av byggena modifierar anroparens bitmapp
Andra fixen tillhör tesseract.exe-adaptorn. FPC:s TStringList lagrar ANSI-strängar, så att tilldela avkodad UTF-8 TSV-text till Lines.Text tyst tappade varje kinesiskt eller supplementary plane-tecken systemets ANSI-kodsida inte kunde representera. FPC-vägen behåller nu TSV:en som UTF-8-byten, strimlar BOM:en på bytenivå och avkodar varje ord till UnicodeString individuellt. DLL-adaptorn hade aldrig detta problem för den avkodar varje ord direkt från iteratorn
Snabbreferens
- Fabrik:
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language[, Options])iHPDFTesseractRecognition, tillagd i v2.772.0, FPC-stöd i v2.772.1 - Standarder:
tpsAuto,temDefault, 60 000 ms, 16 777 216 pixlar; timeout-intervall 1–3 600 000 ms, pixeltak 67 108 864 - Matcha DLL-bitbredd mot programmet och placera beroende-DLL:er bredvid Tesseract-DLL:en
- Behandla monitorn som opak; kopiera aldrig
ETEXT_DESCtill en Pascal-post - Deklarera avbrotts-callbacken
cdeclmed ett one-byteBoolean-resultat, och låt aldrig en exception fly den - Frigör iteratortext med
TessDeleteText; frigör aldrig siditeratorn erhållen från result iterator:n - Räkna med att deadlinen är kooperativ: modellinitiering och layoutanalys kan löpa över den
- Använd tesseract.exe-adaptorn när du behöver hård terminering eller kraschisolering
Tesseract-DLL-adaptorn, processadaptorna och den inbyggda OCR-motorn skeppas alla med HotPDF Delphi PDF-komponenten för Delphi, C++Builder och Free Pascal; se HotPDF-produktsidan för utgåvor och nedladdningar